OpenAI董事长、AI智能体公司Sierra首席执行官布雷特·泰勒认为,最有条件从AI智能体中获利的,不是旧金山的初创公司,而是那些拥有数十年客户记录的百年银行、安防公司和贷款机构。泰勒与Sierra联合创始人克莱·巴沃尔用一条简单的规则概括这一判断:"租用智能,自有上下文"。同时他也承认,AI行业在向普通社区解释为什么应当欢迎支撑这一切的数据中心方面,做得很糟糕。
老牌企业才是早期采用者
巴沃尔从一个坦率的观察说起:硅谷活在自己的泡泡里,广告牌上向圈内人推销智能体框架和推理技术。他说,更有说服力的信号,来自远离旧金山那25平方英里地带的地方。
他列举的客户没有一家是初创公司:
- 创立于1857年的西班牙银行桑坦德银行,用AI智能体管理复杂的客户金融关系。
- ADT,其缩写最初代表"美国地区电报公司",部署了对话式智能体,帮助房主评估和选择安防方案。
- Rocket Mortgage用定制智能体引导借款人完成贷款资格问答和负担能力计算。这些智能体已协助促成超过$10亿的按揭贷款。
巴沃尔的观点是,这些部署主要不是客服台的降本项目。它们位于客户接触点上,直接带来营收增长和客户增长。一家年营收超过$400亿的零售商(未具名)从启动到正式上线一个Sierra智能体只用了27天,他以此证明,大型传统机构的行动速度可以远超外界印象。
租用智能,自有上下文
泰勒把当下定义为堪比网页浏览器或智能手机的平台变革。历史上,这类变革往往偏爱初创公司。他引用史蒂夫·乔布斯的说法:当海盗比加入海军有趣得多;并指出,老牌企业数十年积累的优势,在底层平台更替时常常反转为负担。
但他认为,这次变革可能因为一个结构性原因而走向不同的结局。基础模型,即企业从OpenAI等实验室获得授权的大型通用AI系统,正在走向商品化。在他看来,原始智能将无处不在,因而无法成为任何一家企业的持久差异化优势。假想中的"GPT-28"将对所有人开放。
未来的模型无法复制的是上下文:数十年乃至上百年的专有客户数据、交易历史和品牌信任。这是一家创立于1857年的银行拥有而初创公司没有的资产。由此便有了Sierra给客户的指导性口号:向实验室租用智能,自己掌握上下文。
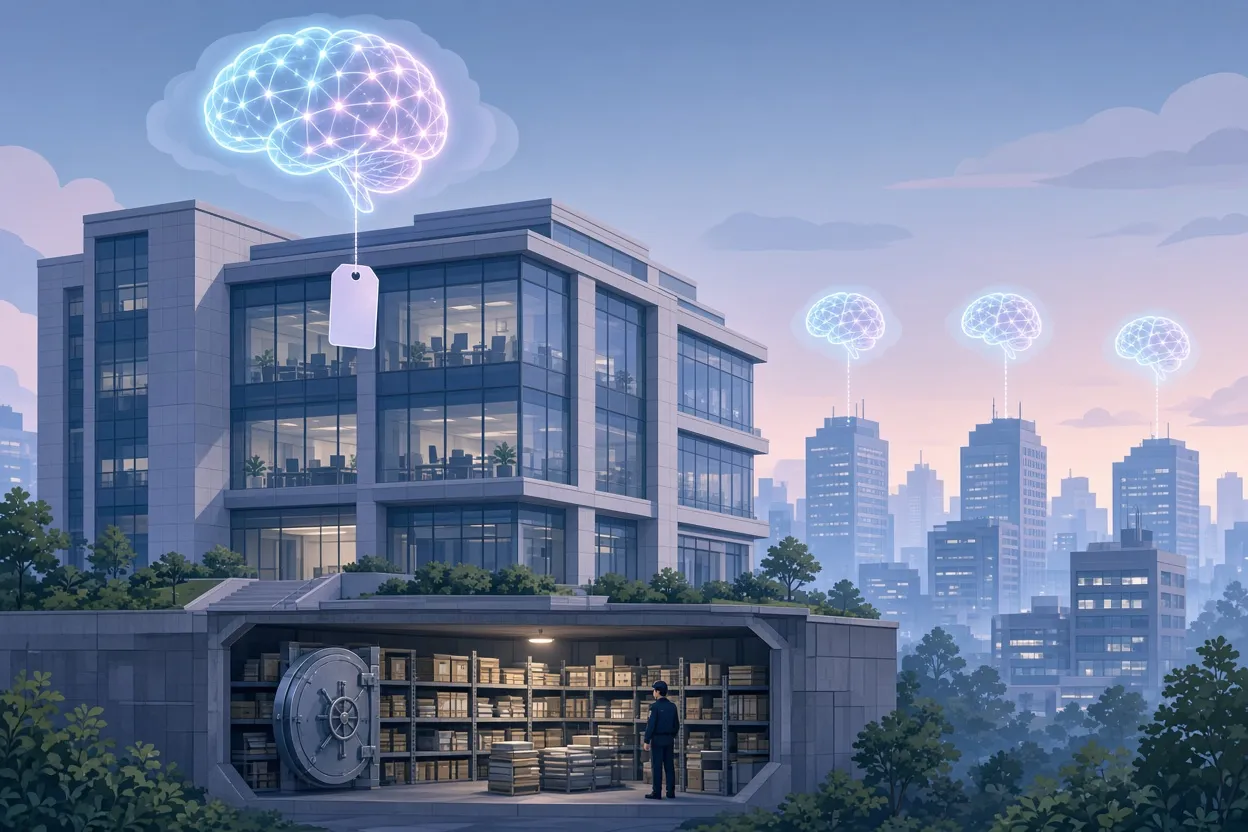
▲ 租用智能,自有上下文
从token恐慌到为结果付费
成本是故事的另一半。巴沃尔说,今年早些时候,首席财务官们对开发者在商业模型API上不可预测的支出感到焦虑,有人称之为"token狂飙"。token是AI模型处理文本的单位,也是服务商计量和计费的依据。
企业的应对是改变购买和使用模型的方式:
| 此前做法 | 正在形成的做法 |
|---|---|
| 所有查询都用同一个旗舰前沿模型 | 把每项任务路由到能胜任的最便宜模型 |
| 按token消耗量计费 | 只在智能体交付业务结果时付费 |
| 开发者随意选用模型 | 首席财务官要求投资回报透明 |
巴沃尔把用顶级前沿模型处理琐碎请求比作开法拉利去买菜。企业正转而采用模型路由,通过OpenRouter等工具或Ramp内部那样的自建系统,把轻量级工作交给更小的或经过微调的开放权重模型(即公开训练参数、企业可自行运行和改造的模型),而把前沿模型留给需要细致推理的难题。
Sierra自身的业务就建立在按结果定价之上。客户只在智能体解决一张工单、完成一笔购买或促成一笔贷款时付费。Sierra在幕后负责应用层,持续调优推理并在多个模型间路由,客户无需操心模型层面的波动。
个人智能体正把算力耗在浏览器模拟上
代替用户行事的个人AI智能体在过去一年迅速兴起。泰勒举了Muse、Instinct以及他本人使用OpenAI的Dot作为其实用性的例子。但他认为它们目前的架构十分浪费:为了完成一项任务,智能体通常要启动一台虚拟机,模拟人类在网站上逐步点击。本应是简单数据传输的工作,由此产生了巨大的计算和推理开销。
为解决这一问题,Sierra牵头推出了名为Personal Agent Protocol的开放标准。它让个人智能体通过结构化API直接与企业软件对话,而不是抓取或浏览可视化网页。泰勒预计这将大幅降低计算负载,同时让消费者通过智能体完成的交易更顺畅、更安全。
数据中心遭遇反弹与沟通失败
中期选举之后,公众和立法层面对数据中心建设的抵制有所加剧,原因是电网容量和土地使用方面的担忧。巴沃尔承认这场辩论是民主治理中自然且必要的一环,但他认为底层需求不受限制。按他的比喻,任何公司只要有可能,都乐意把普通工程师升级为首席工程师,或者成倍增加高质量的客户接触点,正是这种对认知算力的渴求推动基础设施不断扩张。
他直白地摆出了地方层面的权衡:一边是制造、培训和服务岗位加上税收;另一边是噪音和不断上涨的电费。24个月前听起来天方夜谭的想法,比如轨道太阳能阵列和太空数据中心,考虑到需求增长的速度以及埃隆·马斯克火箭事业带来的发射能力进步,如今已值得探索。
泰勒对行业的自我批评更为尖锐。他说,AI行业基本上没能向美国各地社区传达有说服力的价值主张,居民还看不到诸如税单降低之类直接的个人红利。在好处变得切实可感之前,他预计项目将继续遭遇阻力。他还提到被称为"杰文斯悖论"的历史规律:每当能源变得更便宜、更清洁,总需求就会上升以吸纳新增供给,而不是趋于平稳。他预计更便宜的算力也会如此,在科学和工业中解锁意想不到的用途,而这些用途又需要更多算力。他开出的方子是更多的科学与工程,再配以主动达成的、能带来地方互惠的社区协议。
这里还有地缘政治的维度:如果国内电网延误和政治摩擦持续,算力可能迁往马来西亚或中东等地区。泰勒指出,AI是全球性现象,每个国家都会依据自身的国家安全优先级,追求各自的电力、算力和技术主权。
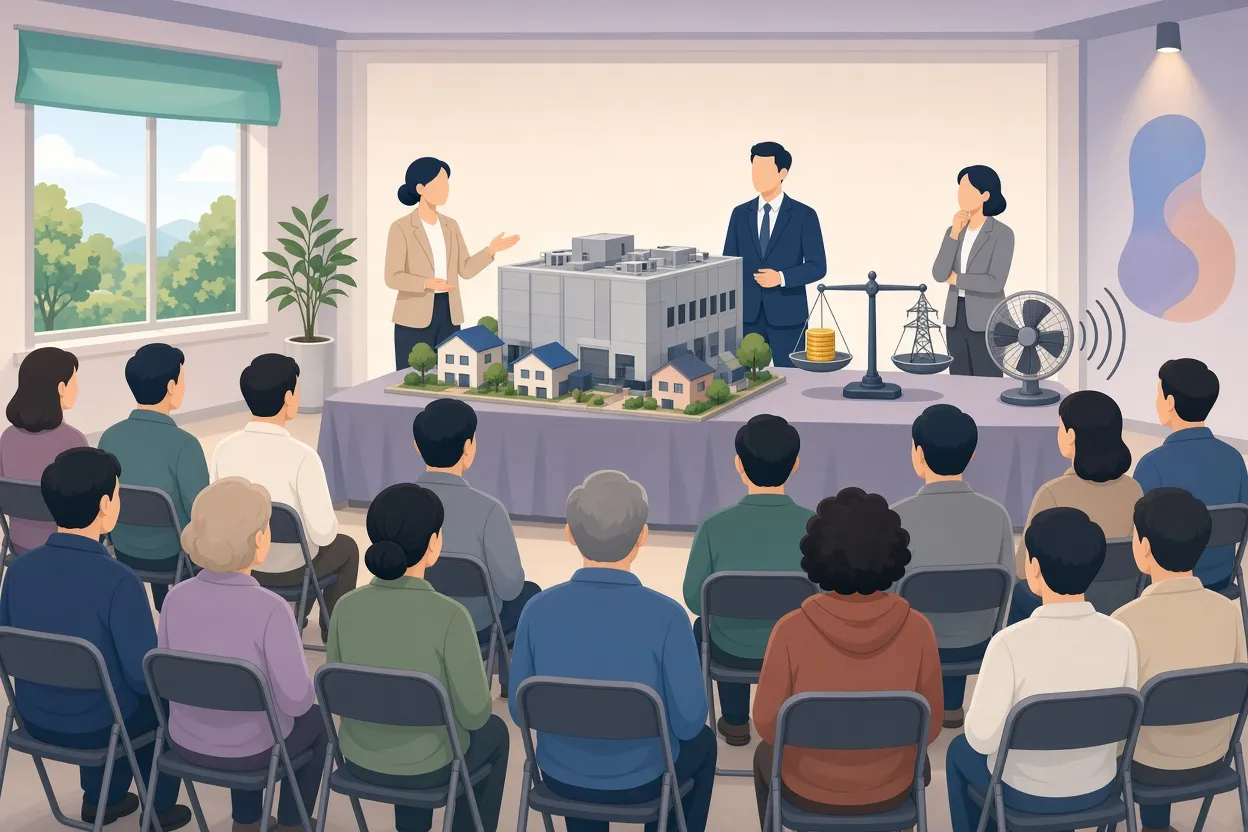
▲ 数据中心审批的地方权衡
稀缺是加速器
巴沃尔还认为,资源上限正推动美国走向更有创造力的架构。他回忆说,谷歌联合创始人谢尔盖·布林常把稀缺称为发明的真正催化剂。在严苛算力限制下展现出高能力的中国实验室DeepSeek,以及训练来复现大模型行为的小型蒸馏模型,在他看来都证明约束会倒逼效率。他说,对前沿智能的强烈需求正推动工程师从每一个token、每一块GPU中榨取更多,从模型设计到数据中心布局再到芯片,无一例外。
智能的存储层级
谈到海外低价模型带来的定价压力,泰勒称赞了OpenAI的Luna模型家族,称其表现出色,而且在许多企业用例中,运行成本比自行托管开放权重替代方案更低。他用两个类比描述市场走向:
- 运营商手机店:在Verizon或T-Mobile,买家可以花大约$1,000买一部旗舰手机,也可以签套餐免费拿一部旧款。两者对不同需求都是合理选择。
- 存储层级:软件根据延迟和成本目标混用机械硬盘、闪存和内存,而不是把一切都放进最快的那一层。
他认为,智能也会遵循同样的逻辑。他预计两到三年内,部署将依赖一组按特定成本、速度和能力要求匹配的模型,而非单一的庞大模型。
给IPO投资者的提醒
随着Anthropic和OpenAI可能上市,巴沃尔给公开市场投资者的建议是保持谦逊。过去三年里,编程智能体、DeepSeek和OpenAI的o1推理模型,每一个到来的速度都快于预测。他说,对智能的总需求看起来没有上限,但其技术形态、商业包装和地理分布仍高度不稳定。只有极少数实验室处于前沿,任何声称能确定AI具体商业或技术路径的人都值得深度怀疑。他建议采取印象式的长期敞口,而不是依赖僵硬的预测。以上内容均不构成投资建议,只是两位出售AI智能体的公司高管的观点。
这意味着什么,该怎么做
贯穿始终的主线是:AI智能体的价值正从模型转向围绕模型的上下文。对老牌企业而言,这是好消息:它们已有的客户记录、交易历史和信任才是稀缺要素。对行业而言,信息更为严峻:算力需求也许无边无际,但承载这些硬件的公众还没有被告知为什么该在乎。
可操作的要点:
- 把专有客户数据和CRM历史视为任何智能体部署的核心资产,租用模型智能而不是试图自建。
- 别再把常规查询发给前沿模型。用路由把每项任务匹配到够用且最便宜的模型,包括蒸馏或微调过的开放权重选项。
- 按结果为AI做预算,例如解决的工单、完成的销售或促成的贷款,而不是token用量。
- 如果你构建面向消费者的系统,请开放结构化API,让个人智能体无需模拟浏览器即可完成交易;Personal Agent Protocol是一个值得考虑的标准。
- 如果你建设基础设施,请尽早与所在社区接触,拿出职业培训、电费减免或税收优惠等具体补偿,因为抽象的国家层面利益并没有说服他们。
- 如果你做投资,请假设未来三年带来的意外不会少于过去三年。


