OpenAI 회장이자 고객 서비스 AI agent 기업 Sierra의 CEO인 Bret Taylor는 AI 업계가 미국 지역사회에 설득력 있는 가치를 보여 주지 못했다고 인정합니다. 데이터센터가 들어서도 주민이 세금 감면 같은 직접적인 이익을 체감하지 못한다는 것입니다. 그런데 Taylor와 Sierra 공동 창업자 Clay Bavor가 함께 전하는 또 하나의 메시지는 방향이 다릅니다. 실리콘밸리의 회의론과 별개로, 1857년에 세워진 은행부터 전신 회사로 출발한 보안 기업까지 오래된 전통 기업들이 AI agent(사용자를 대신해 스스로 작업을 수행하는 AI)로 이미 매출을 만들어 내고 있다는 것입니다. 이 글은 두 사람의 진단을 바탕으로 전통 기업이 AI agent 시대에 유리한 이유, 비용 구조의 변화, 그리고 데이터센터를 둘러싼 갈등을 정리합니다.
실리콘밸리 밖에서 먼저 성과가 나오는 이유
Bavor는 실리콘밸리가 여전히 고립된 거품 속에 있다고 말합니다. 샌프란시스코 거리의 광고판은 agentic framework(agent를 만드는 개발 틀)와 추론 기술 같은 전문 용어로 가득하지만, 정작 지금 가장 큰 움직임은 기술 스타트업이 아니라 오래된 전통 기업에서 나온다는 것입니다.
| 기업 | 배경 | AI agent 활용 | 성과 |
|---|---|---|---|
| Santander | 1857년 설립된 스페인 은행 | 복잡한 고객 금융 관계 관리 | 소매 금융 고객 지원 |
| ADT | American District Telegraph에서 출발한 보안 기업 | 주택 소유자의 보안 구성 상담 | 고객 접점 강화 |
| Rocket Mortgage | 주택담보대출 기업 | 대출 자격과 상환 가능액 질문에 응답 | $10억 넘는 대출 실행 |
핵심은 이들이 AI를 비용 절감 수단으로만 쓰지 않는다는 점입니다. 고객 접점을 늘리고 거래를 성사시켜 매출 자체를 키우는 데 agent를 쓰고 있습니다. Bavor는 연 매출 $400억이 넘는 한 소매 기업이 Sierra의 agent를 단 27일 만에 실제 서비스에 투입했다는 사례도 들며, 대기업이 생각보다 빠르게 움직일 수 있다고 강조합니다.
지능은 빌리고 맥락은 소유하라
Taylor는 지금의 AI 전환을 웹 브라우저와 스마트폰이 가져온 플랫폼 전환에 빗댑니다. 이런 전환기는 보통 민첩한 스타트업에 유리합니다. Taylor는 "해군에 들어가는 것보다 해적이 되는 게 더 재미있다"는 Steve Jobs의 말을 인용하며, 기존 기업이 가진 강점이 플랫폼 전환기에는 오히려 약점으로 뒤집히는 일이 흔하다고 설명합니다.
그럼에도 전통 기업에 구조적 우위가 있다는 것이 Taylor의 주장입니다. 그는 Sierra의 원칙을 "지능은 빌리고, 맥락은 소유하라(rent the intelligence, own the context)"라는 한 문장으로 요약합니다. 기반 모델(foundation model)의 지능은 결국 누구나 쓸 수 있는 범용 자원이 될 것이므로, 모델의 똑똑함 자체는 지속적인 차별화 요소가 될 수 없다는 논리입니다. 가상의 'GPT-28'이 아무리 뛰어나도 어떤 기업이 수십 년, 길게는 백 년 넘게 쌓아 온 고객 데이터, 거래 기록, 브랜드 신뢰는 복제할 수 없습니다. 바로 그 맥락(context)이 해자가 된다는 것입니다.
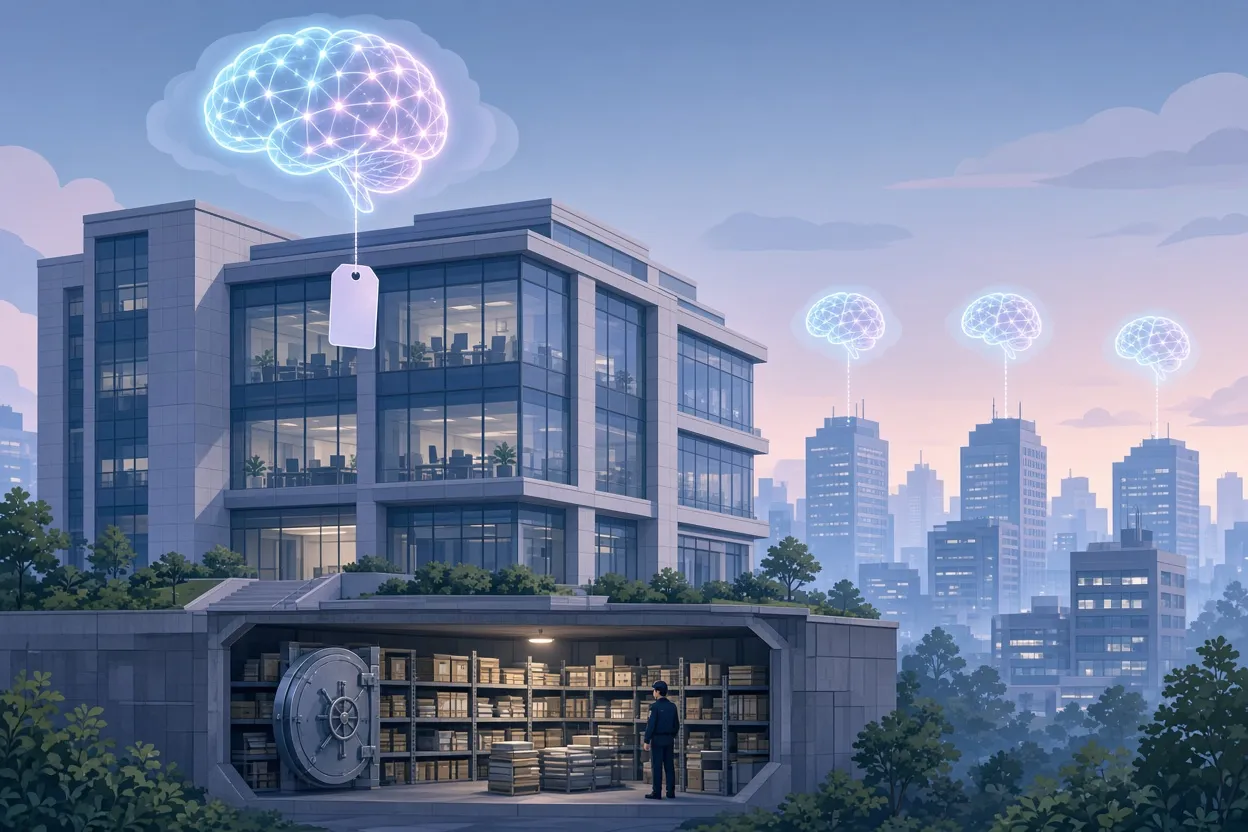
▲ 지능은 빌리고 맥락은 소유
token 비용 불안이 바꾼 구매 방식
올해 초 기업 CFO들은 token(모델이 처리하는 텍스트 단위) 비용 때문에 심한 불안을 겪었다고 Bavor는 전합니다. 개발자들이 상용 모델 API를 얼마나 쓸지 예측할 수 없었기 때문입니다. 그 결과 기업들은 모든 질문에 가장 비싼 frontier 모델(최고 성능의 최신 모델)을 쓰는 관행에서 벗어났습니다. Bavor는 이를 "식료품을 사러 Ferrari를 몰고 가는 것"에 비유합니다.
대신 자리 잡은 방식은 model routing(요청마다 알맞은 모델로 보내는 구조)입니다. OpenRouter 같은 외부 서비스나 Ramp 같은 내부 라우팅 체계를 통해, 가벼운 작업은 fine-tuning(이미 학습한 모델을 특정 작업에 맞게 더 학습시키는 방법)한 open-weights 모델(가중치를 공개한 모델)로 보내고 까다로운 문제만 frontier 모델에 맡기는 식입니다.
Sierra는 한 걸음 더 나아가 사업 모델 자체를 token 사용량이 아니라 결과 기준(outcome-based pricing)으로 설계했습니다. 고객사는 agent가 지원 요청을 실제로 해결하거나, 구매를 완료하거나, 대출을 실행했을 때만 비용을 냅니다. 모델 선택과 추론 최적화는 Sierra가 뒤에서 처리하므로 고객사는 모델 수준의 가격 변동에 노출되지 않습니다.
단일 모델이 아니라 계층형 지능
해외 저가 모델의 등장으로 서구 frontier 연구소가 고가 정책을 버려야 하는 것 아니냐는 시각에 대해, Taylor는 OpenAI의 Luna 모델군을 예로 듭니다. 그는 Luna가 많은 기업 용도에서 직접 open-weights 모델을 운영하는 것보다 오히려 저렴하다고 평가합니다.
그가 든 비유는 두 가지입니다. 하나는 통신사 매장에서 $1,000짜리 최신 스마트폰을 살 수도 있고 이전 세대 기기를 요금제에 끼워 무료로 받을 수도 있다는 것, 다른 하나는 컴퓨터가 지연 시간과 비용에 따라 하드디스크, 플래시 저장 장치, RAM을 조합해 쓰는 저장 장치 계층입니다. 앞으로 2~3년 안에 지능도 하나의 거대 모델이 아니라 비용, 속도, 능력 요구에 맞춰 배열된 여러 모델의 조합으로 쓰이는 것이 표준이 될 것이라는 전망입니다.
개인 agent의 compute 낭비와 Personal Agent Protocol
지난 1년 사이 개인용 AI agent가 급속히 퍼졌습니다. Taylor는 Muse, Instinct, 그리고 자신이 직접 쓰는 OpenAI의 Dot 같은 도구가 매우 유용하다고 말하면서도, 지금 세대 agent의 작동 방식이 지나치게 비효율적이라고 지적합니다. 가상 머신을 띄우고 사람이 웹을 돌아다니는 과정을 흉내 내며 작업하기 때문에, 단순한 데이터 전송으로 끝날 일에 막대한 compute(계산 자원)와 추론 비용이 들어간다는 것입니다.
Sierra는 이 문제를 풀기 위해 Personal Agent Protocol이라는 공개 기술 표준을 주도하고 있습니다. 개인 agent가 화면을 긁거나 브라우저를 조작하는 대신 기업의 소프트웨어 시스템과 구조화된 API로 직접 통신하게 하는 규약입니다. Taylor는 agent와 기업 사이의 통신을 이렇게 정리하면 계산 부하가 크게 줄고 소비자 입장에서도 더 매끄럽고 안전한 거래가 가능해진다고 설명합니다.
데이터센터 반발과 업계의 소통 실패
중간선거 이후 전력망과 토지 사용을 이유로 데이터센터 건설에 대한 반발이 커지고 있습니다. 전력 제약과 인허가 지연이 기업과 AI 플랫폼의 compute 확보를 가로막을 수 있다는 우려도 있습니다.
Bavor는 지역사회가 마주한 선택이 단순하지 않다고 인정합니다. 한쪽에는 제조, 교육, 서비스 일자리와 세수가 있고, 다른 쪽에는 소음과 전기요금 상승에 대한 주민의 걱정이 있습니다. 그는 이런 논쟁이 민주 사회에서 당연하고 필요한 과정이라고 봅니다. 다만 AI에 대한 수요 자체는 모든 산업에서 사실상 제약이 없다고 주장합니다. 어떤 기업이든 선택권만 있다면 staff급 엔지니어를 principal급으로 올리거나 양질의 고객 접점을 몇 배로 늘리려 할 것이라는 비유입니다.
Taylor는 여기서 업계의 책임을 직접 언급합니다. AI 업계가 미국 지역사회에 설득력 있는 가치 제안을 전달하는 데 대체로 실패했고, 주민들이 세금 감소 같은 개인적 배당을 아직 보지 못하고 있다는 것입니다. 이익이 손에 잡히기 전까지는 반대가 계속될 것이라는 경고로 읽힙니다. 그는 과학과 기술의 문제를 푸는 해법은 더 많은 과학과 공학이라며, 인프라 건설이 지역에 실질적 혜택을 주도록 선제적으로 설계해야 한다고 말합니다.
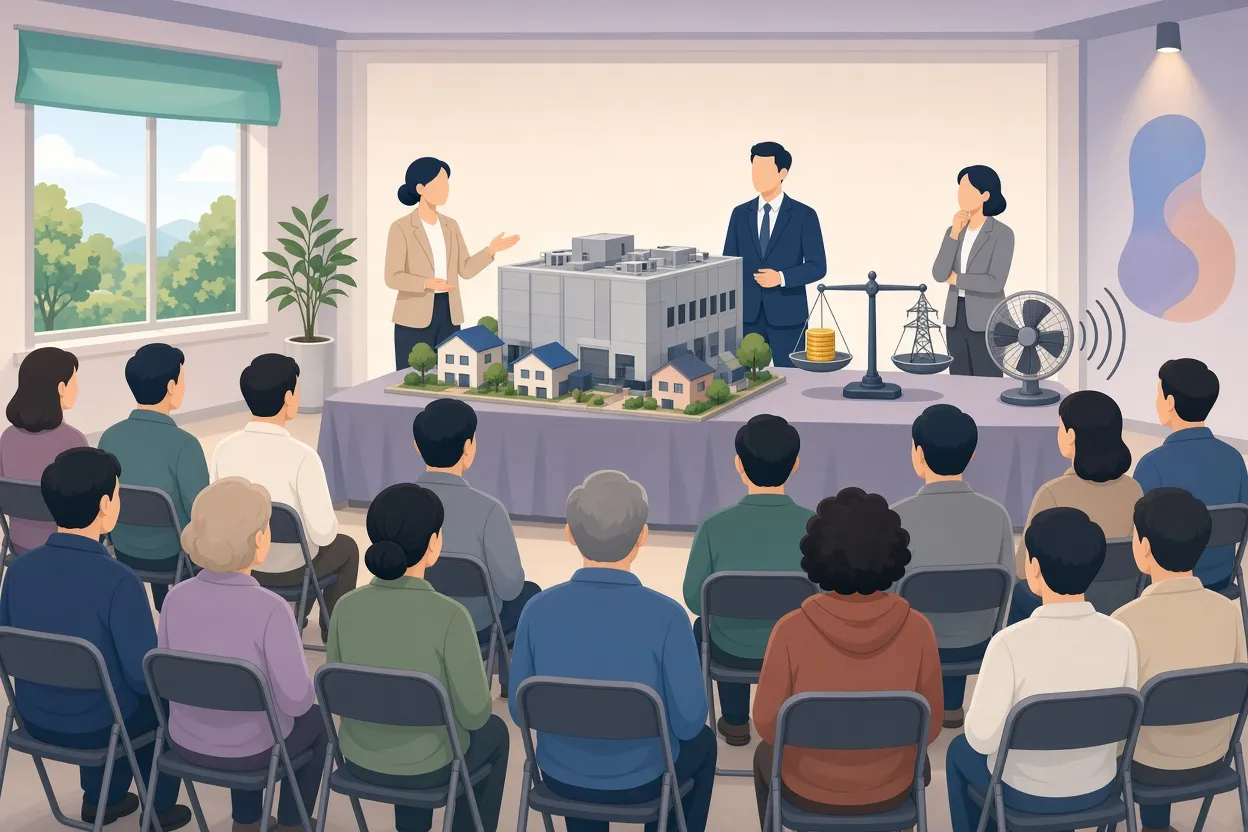
▲ 데이터센터와 지역사회의 갈등
효율이 좋아지면 수요는 더 커진다
compute가 싸지면 데이터센터 수요가 줄어들까요. Taylor의 답은 반대입니다. 역사적으로 더 깨끗하고 싼 에너지가 등장할 때마다 총수요는 공급을 모두 흡수할 만큼 늘어났고, compute도 마찬가지로 비용이 내려가면 과학과 산업에서 예상 못 한 용도가 열려 더 큰 수요를 만든다는 것입니다. 이른바 Jevons paradox(효율 개선이 오히려 총소비를 늘리는 현상)입니다.
Bavor는 2년 전만 해도 궤도 태양광과 우주 데이터센터 같은 아이디어가 황당하게 들렸지만, AI 수요의 속도와 Elon Musk 같은 인물이 이끄는 발사 능력의 발전을 고려하면 검토할 가치가 있다고 말합니다. compute가 말레이시아나 중동으로 옮겨 갈 수 있다는 우려에 대해 Taylor는 AI가 전 지구적 현상이며 각국이 국가 안보 우선순위에 따라 자체 전력과 compute, 기술 주권을 추구할 것이라고 봅니다.
제약이 혁신을 낳는다는 관점도 나옵니다. Bavor는 Google 공동 창업자 Sergey Brin이 희소성이야말로 발명의 진짜 촉매라고 자주 말했다고 회상하며, 심한 compute 제약 속에서도 높은 성능을 보인 중국의 DeepSeek와 distillation(큰 모델의 능력을 작은 모델에 압축해 옮기는 기법)으로 만든 소형 모델을 예로 듭니다. frontier 지능에 대한 거대한 수요가 엔지니어들로 하여금 token 하나, GPU 하나에서 더 많은 것을 뽑아내게 만들고, 이것이 모델부터 반도체까지 기술 스택 전체의 발전을 밀어붙인다는 설명입니다.
상장을 앞둔 AI 연구소와 겸손이라는 조언
Anthropic과 OpenAI 같은 선도 연구소의 기업공개 가능성이 거론되는 가운데, Bavor가 투자자와 경영자 모두에게 강조하는 태도는 겸손입니다. 지난 3년만 돌아봐도 자동 코딩 agent의 급성장, DeepSeek의 등장, OpenAI의 o1 추론 모델처럼 예측을 벗어난 일이 반복됐기 때문입니다. 지능에 대한 총수요는 무한해 보이지만, 그것이 어떤 기술 형태와 상품으로, 어느 지역에서 실현될지는 매우 유동적이라는 것입니다. 그는 기반 모델의 최전선에서 돌파구를 내는 연구소는 극소수이며, AI의 상업적·기술적 경로를 확실히 안다고 말하는 사람은 깊이 의심해야 한다고 덧붙입니다. 이 글은 특정 투자 판단을 권하지 않으며, 두 사람의 조언도 예측의 불확실성을 인정하라는 데 초점이 있습니다.
정리: 기업과 독자가 챙길 것
두 사람의 이야기를 종합하면, AI agent 시대의 승부는 더 똑똑한 모델을 확보하는 데서 갈리지 않습니다. 자기만의 고객 맥락을 얼마나 잘 쌓고 연결하느냐, 그리고 비용을 결과와 어떻게 묶느냐가 관건입니다. 기업과 실무자가 바로 적용할 수 있는 항목을 정리하면 다음과 같습니다.
- 단순하고 반복적인 자동화에는 고가 frontier 모델을 쓰지 않고, 미묘한 판단이 필요한 문제에만 아껴 씁니다.
- OpenRouter나 Ramp 같은 라우팅 도구로 frontier API와 fine-tuning한 open-weights 모델 사이에 요청을 배분합니다.
- AI 예산은 token 사용량이 아니라 해결된 지원 요청, 완료된 판매 같은 결과 지표로 계획합니다.
- 기존 고객 상담 기록과 CRM 데이터를 핵심 맥락 층으로 삼아 범용 경쟁자와 차별화합니다.
- 외부 소비자 agent가 자사 시스템과 연결될 때를 대비해 Personal Agent Protocol 같은 표준을 검토합니다.
- 데이터센터를 짓는 기업이라면 지역 일자리 훈련, 공과금·세금 상쇄처럼 손에 잡히는 혜택을 갖고 초기에 지역사회와 대화합니다.
실리콘밸리의 거품과 데이터센터를 둘러싼 갈등은 당분간 이어질 것으로 보입니다. 그러나 오래된 은행, 보안 회사, 대출 기업이 이미 agent로 성과를 내고 있다는 사실은, AI의 가치가 기술 자체보다 그것을 어디에 어떻게 붙이느냐에서 나온다는 점을 보여 줍니다.


