Anthropic于2026年11月9日发布了Claude Fable 5.2,同时推出一个受限的同架构模型Mythos 5.2。新模型以82分登上Artificial Analysis智能指数榜首,并在Anthropic自家基准表的智能体编程、科学研究和机器人三个类别中领先。问题在于成本与定位:它的API价格正好是Claude Opus 5.5的两倍,而且Anthropic自己也表示,大多数用户应继续把Opus 5.5作为日常模型,只在问题确实困难时才动用Fable 5.2。本文梳理发布当天的数据、实际测试结果,并给出一套判断是否值得切换的实用方法。
两个模型,同一架构
Mythos 5.2与Claude Fable 5.2共用同一底层架构,但面向不同人群。Mythos 5.2是不受限版本,仅向获得授权的网络安全研究人员和红队测试人员开放。Fable 5.2则是面向公众和商业客户的版本,在此之上叠加了严格的网络安全护栏和安全缓解措施。在网络安全基准上,Mythos 5.2的得分高于Fable 5.2,Anthropic将这一差距归因于护栏的移除。
值得注意的是Anthropic对Fable 5.2的定位方式。公司明确不建议把它作为处理日常任务的主力模型,而是提出了两种角色:
- 顾问:编程和知识工作先用Opus 5.5起步,当较小的模型遇到瓶颈时再升级到Fable 5.2。
- 编排者:让Fable 5.2把复杂项目拆解成若干部分,再把子任务分派给Haiku、Sonnet或Opus。
对任何考虑切换的人来说,这一定位都很关键。Fable 5.2被放在日常模型之上的专家层级,而不是日常模型的替代品。
基准测试结果
Anthropic的基准表将Fable 5.2与Fable 5.1、Opus 5.5、OpenAI的GPT-6 Astra以及谷歌的Gemini 4 Carbon进行对比。Fable 5.2在大多数测试集上达到了最先进水平,其中智能体科学研究和机器人两项的提升幅度最大。
| 基准 | Fable 5.2 | Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|---|---|---|---|
| FrontierCode 2.0(智能体编程) | 49.1% | 42.5% | - | - |
| Frontier SWE v2 | 69.9% | 62.3% | - | - |
| 业务流程自动化 | 55.4% | - | - | 63.9% |
| Terminal-Bench Science 2.1(智能体研究) | 74.6% | 58.7% | 68.1% | 64.8% |
| RoboDojo机器人仿真 | 64.9% | 40.6% | 29.8% | - |
Gemini 4 Carbon在业务流程自动化上保持明显领先,因此Fable 5.2并非所有类别的最佳选择。差距最悬殊的是机器人项目:Fable 5.2比Opus 5.5高出24分以上,是GPT-6 Astra的两倍多。
独立基准测试平台Artificial Analysis证实了这一榜首位置,其智能指数得分82分是该平台有记录以来的最高分。同一平台也将Fable 5.2列为其追踪的最昂贵模型,在最高推理强度下平均每项任务成本为$26.54。不过有一项效率指标指向相反方向:Fable 5.2每项任务平均生成的输出token略少于Sonnet 5.5,说明即使思考时间很长,它的推理也相当精炼。
一项要求模型绘制某知名演员精细SVG肖像的自定义测试给出的结果则更为复杂。Fable 5.2单次运行耗时19分50秒,消耗122,248个token,花费$4.86。自动评审给出的分数为7.2分(满分10分),在该榜单上排第六,落后于8.0分的GPT-6.1 Sol、7.6分的Gemini 4 Argon和7.3分的GPT-6 Astra。自动评审并不完美,审美方面人眼仍是更好的标准,但这一结果符合测试中其他地方观察到的规律:Fable 5.2擅长逻辑与结构,胜过视觉打磨。
推理强度:并非越高越好
Fable 5.2提供多个推理强度档位,从Low、Medium、High、Extra High到Max。Anthropic在FrontierCode 2.0上的成本与准确率曲线显示,这一区间顶端的收益递减非常明显。Extra High档位的得分实际上高于Max,也就是说最长的思考时间反而拉低了结果,同时让每项任务的成本大幅上升。
▲ Max推理强度下的收益递减
对预算规划更有用的对比是:Fable 5.2在High推理强度下的准确率可与Opus 5.5在Max下相当,而每项完成任务的总体价格更低。实际使用中,合理的默认选择是High或Extra High,Max只留给已经验证确有帮助的场景。当你需要快速得到可运行的代码时,Medium也表现不错,下文的游戏测试就是例子。
定价与获取方式
Fable 5.2已即时上线Anthropic的网页界面、AWS Bedrock和Google Cloud Vertex AI。在网页端需要付费方案,免费版不包含该模型。
| 方案 | 月费 | 可用Fable 5.2 |
|---|---|---|
| Free | $0 | 否 |
| Pro | $17 | 是 |
| Max | $100 | 是 |
| Ultra | $200 | 是 |
发布周期间,Anthropic向Pro和Team订阅用户提供促销性的用量重置,以及最高50%的每周用量加成。这些额度是临时的,想了解该模型的人可以在这段窗口期以相对较低的成本进行高强度测试。
API定价为每百万输入token $8、每百万输出token $40。
| 模型 | 每百万输入token | 每百万输出token |
|---|---|---|
| Claude Fable 5.2 | $8 | $40 |
| Claude Opus 5.5 | $4 | $20 |
| Claude Fable 5.1 | $10 | $50 |
| GPT-6 Astra | $10 | $50 |
Fable 5.2的价格正好是Opus 5.5的两倍,但比前代Fable 5.1和OpenAI的GPT-6 Astra都略便宜。
实测结果:游戏与实体硬件
一条要求克隆独立游戏Megabonk的测试提示词撞上了Anthropic更新后的政策:模型现在会拒绝直接克隆或侵犯现有电子游戏知识产权的请求。Fable 5.2没有就此失败,而是提出制作一款同类型的原创游戏。成果名为Shardstorm,是一款3D群怪生存类Roguelike,具备自动开火武器、经验宝石、升级选项,以及名为Vex、Oria和Pip的自定义角色。该游戏通过Claude Code在Medium推理强度下用约16分钟生成,运行中没有出现bug:带体力消耗的冲刺、通过升级获得的二段跳、碰撞检测、升级时暂停的菜单,以及Sky Feather、Wisdom Seed、Star Glaive、Shell Plating等一系列升级项,全部在首次运行时就正常工作。
弱点在于表现力。地形和敌人都是低多边形,音频只是简单的MIDI风格循环,远不能与ElevenLabs这类专门的AI音频工具相比。在同类任务上,Opus 5.5似乎能产出更讨喜的视觉风格,这再次印证了Fable 5.2的优势在逻辑而非美学。此外,随着更多用户尝试新模型,生成速度也可能因服务器负载而波动。
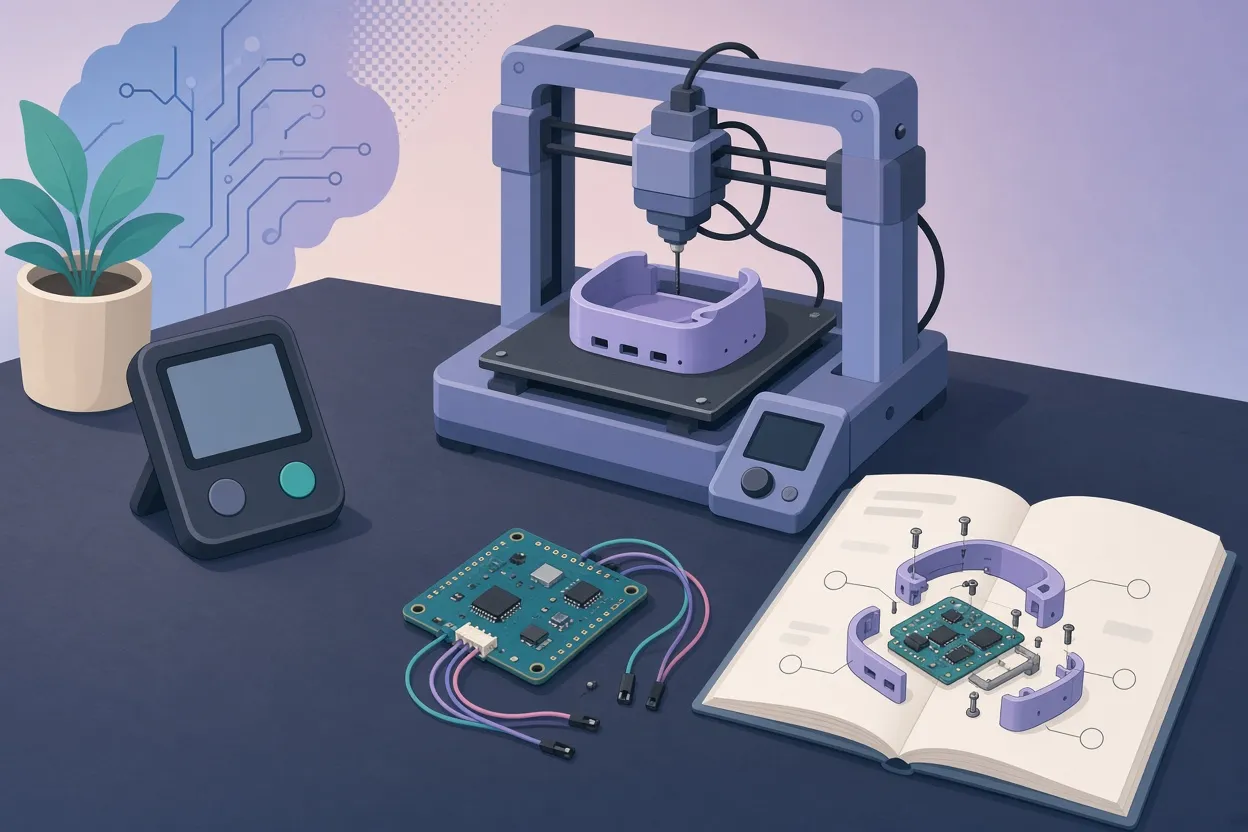
▲ AI设计的手持小工具与组装手册
硬件测试的野心更大。一条提示词要求给出一套完整的手持桌面小工具方案:现成元器件、零件清单、固件、可3D打印的STL文件,以及接线与组装指引。提示词要求以一位真实演员为主题,模型针对生成真实在世人物形象的护栏随即触发,改用一个名为PixelPal的原创像素风机器人角色替代。规格书给出了具体零件:Raspberry Pi Pico H微控制器、Waveshare 1.54英寸240x240 SPI LCD模块、16mm瞬动按钮、杜邦线、M3螺丝、双面泡棉胶带和一根micro-USB数据线。在Bambu Studio中打开STL文件,确认各部件均可打印:带按钮和显示屏开孔的前壳、显示屏压板和背板,只是屏幕开孔看起来比理想尺寸略小。随后在High推理强度下追加请求,约15分钟后得到一份图文组装手册,包含CAD风格的爆炸图、引脚映射表、焊接步骤和故障排查FAQ。
Anthropic与早期测试者的展示案例
Anthropic自己的演示偏向长时间运行的自主工作。在一项实验中,一位工程师给Fable 5.2一个空目录,要求构建一个原型操作系统。模型协调了1,000多个子智能体连续工作8天,成果在一台实体笔记本电脑上成功启动,具备自定义内核、设备驱动、网络协议栈、窗口管理器和内置的Claude智能体工具。在生物化学领域,模型组合两个开源蛋白质模型,预测了完整的腺相关病毒衣壳结构。在硬件方面,一段单段落提示词就生成了语音助手中枢、USB会议扬声器和手持电子宠物的电路板原理图、元件布局、固件和可3D打印外壳。
在X上分享结果的早期测试者也朝着类似方向推进。一位AI内容创作者展示了一款Gears of War风格的可玩第三人称射击游戏,拥有精细的城市环境、逼真的光照和掩体机制,视觉完成度远高于16分钟生成的Shardstorm,原因很可能是使用了更高的推理强度并经过数天迭代。同一团队的一位制作人发布了一段两小时的23个演示拆解,包括Zelda风格的冒险游戏、Halo风格的射击游戏、钢铁侠飞行模拟器、功能可用的Adobe Photoshop和Adobe Premiere仿制品、一款名为VoxRack的变声应用,以及一款3D乒乓球游戏。一位科技作者完全用代码生成了一段20秒的京都伏见稻荷大社秋景电影感旅游广告,镜头沿鸟居轨道推进,并配以同步的传统音乐。一位AI创业者打造了Mirror Earth,这是一款基于体素、利用开放数据重建真实城市的游戏;漫步在体素化的圣迭戈街头,你可以击穿墙壁、用物理驱动的爆炸砸毁汽车,不过悬浮的鸽子和僵住的行人模型也暴露了自动生成的粗糙之处。
该不该切换?
这个决定取决于你实际用模型做什么。根据发布当天的证据,以下几条经验法则站得住脚:
- 日常编程、内容创作和一般知识工作继续用Opus 5.5。普通用户可能察觉不到显著差异,而Opus 5.5的API价格只有一半,用量限制也更宽裕。
- 困难的多阶段问题交给Fable 5.2:难以捉摸的软件bug、复杂架构、科学工作流、精细的3D仿真,以及实体设备工程。
- 在大型项目中把它设置为编排者,由更便宜的模型通过API处理细粒度的执行。
- 默认不要用Max推理强度。High或Extra High能以低得多的成本提供相当或更好的准确率。快速生成代码用Medium,涉及空间输出、CAD设计和图文手册时再提高强度。
- 打印前先在Bambu Studio等切片软件中核验硬件输出;涉及真实公众人物或受版权保护游戏名称的请求,预计会被改向原创替代方案。
结论
Claude Fable 5.2在困难推理、智能体科学研究、机器人和工程工作上看起来是一次真正的飞跃,独立的智能指数排名也印证了Anthropic的基准主张。但它同时价格高昂,被刻意定位为专家而非日常主力,而且在视觉打磨和业务流程自动化上并非最强选项。如果你的工作偏常规,Opus 5.5仍是务实之选。如果你经常碰到较小模型啃不动的问题,Pro和Team方案在发布周的用量加成提供了一个低风险的机会,可以在促销重置到期前验证Fable 5.2是否值这个价。


