Anthropic이 2026년 11월 9일 새 최상위 모델 Claude Fable 5.2와 Mythos 5.2를 공개했습니다. 독립 평가 기관 Artificial Analysis의 Intelligence Index에서 Fable 5.2는 82점으로 현재 공개된 모델 가운데 1위에 올랐습니다. 다만 Anthropic 스스로 이 모델을 매일 쓰는 기본 모델로 권하지 않는다는 점이 이번 출시의 가장 큰 특징입니다. 성능은 가장 높지만 가격도 가장 비싸고, 일상 작업에서는 기존 Opus 5.5와 차이를 체감하기 어려워 보입니다.
Mythos 5.2와 Fable 5.2, 같은 모델의 두 얼굴
두 모델은 같은 구조를 공유합니다. Mythos 5.2는 안전 제한을 걷어낸 원형으로, 승인된 사이버보안 연구자와 red-teaming(공격자 관점에서 취약점을 찾는 모의 테스트) 담당자만 쓸 수 있습니다. Fable 5.2는 여기에 사이버보안 guardrail(안전 제한 장치)과 완화 조치를 더해 일반 사용자와 기업에 공개한 버전입니다. 사이버보안 benchmark에서는 제한이 없는 Mythos 5.2가 Fable 5.2보다 높은 점수를 냅니다.
Anthropic이 제시한 사용법은 분명합니다. 코딩과 일반 지식 작업은 Opus 5.5로 시작하고, 작은 모델이 막히는 어려운 문제에서 Fable 5.2를 '조언자'로 부르거나, 복잡한 프로젝트를 쪼개 Haiku·Sonnet·Opus에 하위 작업을 나눠 주는 'orchestrator(지휘자 역할의 모델)'로 쓰라는 것입니다.
benchmark에서 앞선 곳과 뒤진 곳
Anthropic의 공식 benchmark 표에서 Fable 5.2는 대부분의 항목에서 Opus 5.5, GPT-6 Astra, Gemini 4 Carbon을 앞섭니다. 특히 과학 연구와 로봇 시뮬레이션에서 격차가 큽니다.
| benchmark | Fable 5.2 | Opus 5.5 | 비고 |
|---|---|---|---|
| FrontierCode 2.0 (agentic coding) | 49.1% | 42.5% | |
| Frontier SWE v2 | 69.9% | 62.3% | |
| Terminal-Bench Science 2.1 (과학 연구) | 74.6% | 58.7% | GPT-6 Astra 68.1%, Gemini 4 Carbon 64.8% |
| RoboDojo (로봇 시뮬레이션) | 64.9% | 40.6% | GPT-6 Astra 29.8% |
| 업무 workflow 자동화 | 55.4% | - | Gemini 4 Carbon이 63.9%로 1위 |
업무 workflow 자동화에서는 Gemini 4 Carbon이 여전히 앞서 있어, 모든 영역에서 1위는 아닙니다. 또한 Fable 5.2는 이론물리, capsid 단백질 접힘, 수학 형식화 같은 깊은 STEM 과제를 겨냥해 설계됐다는 점도 함께 밝혀졌습니다.
reasoning effort를 Max로 올리면 오히려 손해
이번 출시에서 눈여겨볼 데이터는 FrontierCode 2.0의 비용 대비 정확도 곡선입니다. reasoning effort(모델이 답하기 전 생각에 쓰는 계산량 설정)를 Low, Medium, High, Extra High, Max로 올려 가며 비교했는데, Extra High가 Max보다 점수가 높았습니다. 생각을 더 오래 시킨다고 결과가 좋아지지 않고 작업당 비용만 크게 늘어난 것입니다. 반면 Fable 5.2를 High로 돌리면 Opus 5.5를 Max로 돌린 것과 비슷한 정확도를 더 낮은 작업당 비용으로 얻을 수 있었습니다.
Artificial Analysis 집계에서도 비용 문제가 드러납니다. 최대 reasoning 설정에서 Fable 5.2의 평균 작업 비용은 $26.54로, 목록에 오른 모델 가운데 가장 비쌉니다. 다만 작업당 출력 token 수는 Sonnet 5.5보다 조금 적어, 말을 길게 늘어놓기보다 비교적 간결하게 추론하는 편으로 보입니다.
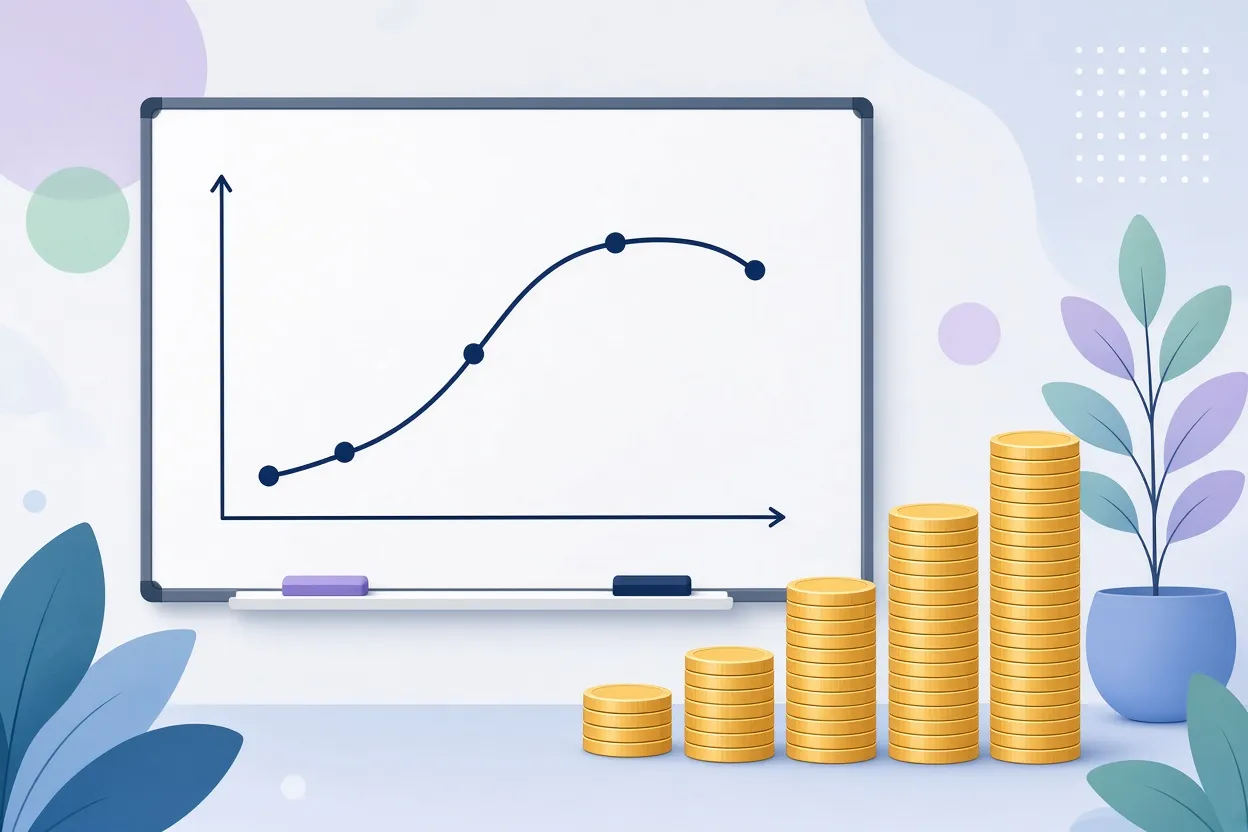
▲ reasoning effort별 비용과 정확도
가격과 이용 조건
Fable 5.2는 출시 즉시 Anthropic 웹 콘솔, Amazon Web Services Bedrock, Google Cloud Vertex AI에서 쓸 수 있습니다. 웹에서는 유료 구독이 필요하고 무료 요금제에서는 쓸 수 없습니다.
| 구분 | 가격 |
|---|---|
| Claude Pro | 월 $17 |
| Claude Max | 월 $100 |
| Claude Ultra | 월 $200 |
| Fable 5.2 API | 입력 100만 token당 $8, 출력 100만 token당 $40 |
| Opus 5.5 API | 입력 $4, 출력 $20 |
| Fable 5.1 API | 입력 $10, 출력 $50 |
| GPT-6 Astra API | 입력 $10, 출력 $50 |
API 가격은 Opus 5.5의 정확히 2배입니다. 다만 이전 세대인 Fable 5.1이나 OpenAI의 GPT-6 Astra보다는 조금 싸졌습니다. 출시 주간에는 Pro와 Team 구독자에게 Fable 사용량 초기화 혜택과 최대 50%의 주간 사용량 보너스가 제공됩니다.
직접 써 보면 어떤가
Anthropic이 공개한 시연 사례는 규모가 큽니다. 한 엔지니어가 빈 디렉터리에서 운영체제 프로토타입을 만들라고 지시하자, Fable 5.2는 1,000개가 넘는 sub-agent(하위 작업을 맡는 자동 실행 agent)를 지휘하며 8일 동안 쉬지 않고 코드를 쓰고 컴파일하고 검토했습니다. 결과물은 자체 kernel, 장치 드라이버, 네트워크 스택, 창 관리자, 내장 Claude agent 도구를 갖추고 실제 노트북에서 부팅되는 운영체제였습니다. 생화학 분야에서는 두 오픈소스 모델을 결합해 adeno-associated virus의 capsid 구조 전체를 예측했고, 하드웨어 분야에서는 한 문단짜리 prompt만으로 회로도, 부품 배치, firmware, 3D 프린팅용 외장까지 설계해 음성 비서 허브, USB 스피커폰, 휴대용 가상 반려동물 기기 시제품을 만들었습니다.
출시 당일 진행된 독립 테스트 결과는 조금 더 입체적입니다.
- 게임 생성: Claude Code에서 reasoning을 Medium으로 두고 Megabonk 스타일의 3D 게임을 요청하자 약 16분 만에 완성했습니다. 기존 게임 IP를 그대로 복제해 달라는 요청은 거부하되, 같은 장르의 독창적인 게임을 만들겠다고 먼저 제안해 'Shardstorm'이라는 3D horde survival roguelike(몰려드는 적을 버티며 성장하는 장르의 게임)를 내놓았습니다. 달리기, 스태미나, 이단 점프, 충돌 판정, 레벨업 메뉴가 버그 없이 동작했지만, 저폴리곤 지형 같은 그래픽은 Opus 5.5 결과물보다 투박하고 음악도 단순한 MIDI 수준이었습니다.
- 하드웨어 설계: 시판 부품으로 만드는 휴대용 책상 가젯을 요청하자 Raspberry Pi Pico H, Waveshare 1.54인치 240x240 SPI LCD, 16mm 버튼, M3 나사 등 정확한 부품 목록과 firmware, STL 파일을 내놓았습니다. STL을 Bambu Studio에서 열어 보니 버튼과 화면 구멍이 뚫린 앞면 셸, 디스플레이 클램프, 뒷판이 제대로 모델링돼 있었습니다. High reasoning으로 조립 설명서를 요청하자 약 15분 뒤 CAD 스타일 분해도, 핀 배치표, 납땜 순서, 문제 해결 FAQ가 담긴 문서가 나왔습니다. 실존 배우를 테마로 요청했지만 실존 인물의 외형을 만들지 않는 guardrail 때문에 'PixelPal'이라는 독창적인 픽셀아트 로봇 캐릭터로 바뀌었습니다.
- SVG 초상화 테스트: 복잡한 SVG 초상화를 그리게 하는 한 개인 benchmark에서는 19분 50초, 122,248 token, 약 $4.86이 들었고 자동 심사 점수 7.2점으로 6위에 그쳤습니다. 1위는 GPT-6.1 Sol(8.0), 2위는 Gemini 4 Argon(7.6), 4위는 GPT-6 Astra(7.3)였습니다.
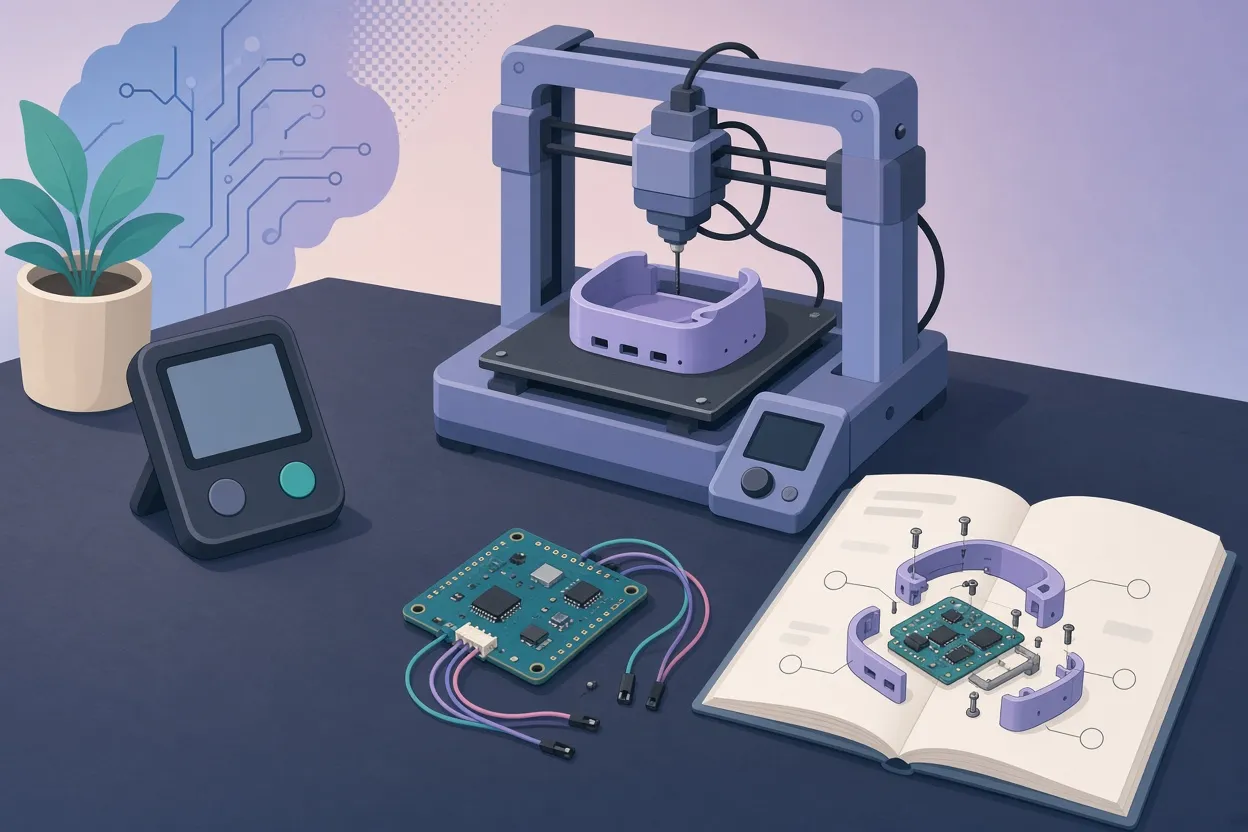
▲ AI가 설계한 하드웨어 시제품
X에 올라온 초기 접근 사용자들의 결과물도 눈에 띕니다. 한 AI 크리에이터 팀은 도시 전투 환경과 엄폐 사격을 갖춘 3인칭 슈팅 게임을 선보였고, 같은 팀의 영상 제작자는 Photoshop과 Premiere 기능을 흉내 낸 앱, 음성 변조기, 3D 탁구 게임 등 23개 데모를 공개했습니다. 한 테크 작가는 코드만으로 교토 후시미이나리 신사의 가을 풍경을 담은 20초짜리 여행 광고 영상과 음악을 만들었고, 한 AI 창업자는 공개 데이터를 바탕으로 실제 도시를 voxel로 재현해 건물 벽을 부수고 차를 박살 낼 수 있는 'Mirror Earth' 게임을 만들었습니다. 그래픽 수준이 높은 사례들은 더 높은 reasoning 설정이나 며칠에 걸친 반복 prompt로 만든 결과로 보이며, Mirror Earth에는 공중에 뜬 비둘기나 멈춘 NPC 같은 결함도 남아 있었습니다.
지금 갈아탈 이유가 있는가
출시 당일 정보로 판단하면, Fable 5.2는 '더 좋은 Opus'가 아니라 '다른 용도의 모델'로 보는 편이 맞습니다. 다음 기준으로 판단해 보시기 바랍니다.
| 상황 | 권장 선택 |
|---|---|
| 일상 코딩, 글쓰기, 지식 작업 | Opus 5.5 또는 Sonnet 유지. 비용 절반, 체감 차이 작음 |
| 찾기 어려운 버그, 복잡한 소프트웨어 아키텍처 | Fable 5.2를 조언자로 투입 |
| 여러 단계로 나뉜 큰 프로젝트 | Fable 5.2를 orchestrator로 두고 하위 작업은 API로 Sonnet·Haiku에 위임 |
| 3D 시뮬레이션, CAD 설계, 그림이 들어간 설명서 | Fable 5.2를 High 또는 Extra High로 |
| 시각적 완성도가 중요한 창작물 | Opus 5.5가 아직 더 나은 결과를 내는 것으로 보임 |
실제로 써 볼 때는 몇 가지를 지키면 비용을 아낄 수 있습니다. reasoning effort는 기본값으로 Max를 쓰지 말고, 빠른 코드 생성은 Medium, 공간 설계나 긴 문서는 High나 Extra High를 쓰는 편이 낫습니다. 게임을 만들 때는 상표가 있는 게임 이름을 직접 쓰지 말고 장르와 규칙을 설명하는 편이 거부를 피하는 길입니다. 하드웨어를 설계했다면 출력 전에 STL을 slicer에서 열어 치수를 확인해야 합니다. 테스트에서도 화면 구멍이 필요 이상으로 작게 설계된 점이 발견됐습니다. 웹에서 써 보려면 최소 Pro(월 $17) 구독이 필요하고, 출시 주간의 사용량 보너스와 초기화 혜택이 사라지기 전에 어려운 문제를 몰아서 시험해 보는 것이 가장 경제적인 접근으로 보입니다.


