Anthropicは2026年11月9日、Claude Fable 5.2を、利用者を限定した姉妹モデルMythos 5.2とあわせてリリースしました。新モデルはArtificial AnalysisのIntelligence Indexでスコア82を記録して首位に立ち、Anthropic自身のベンチマーク表でもエージェント型コーディング、科学研究、ロボティクスの各分野でトップです。ただし注意すべきは価格と用途です。API価格はClaude Opus 5.5のちょうど2倍で、Anthropic自身も、ほとんどのユーザーは日常のモデルとしてOpus 5.5を使い続け、本当に難しい問題に当たったときだけFable 5.2を使うべきだとしています。本記事では、発表日の数値、実際に試した結果、そして乗り換えが自分に合うかを判断する実践的な方法を整理します。
2つのモデル、1つのアーキテクチャ
Mythos 5.2とClaude Fable 5.2は同じ基盤アーキテクチャを共有していますが、対象とする利用者は異なります。Mythos 5.2は制限のないバージョンで、認可を受けたサイバーセキュリティ研究者とレッドチーミングのテスターに限って提供されます。Fable 5.2は一般と商用顧客向けのバージョンで、厳格なサイバーセキュリティのガードレールと安全対策が重ねて施されています。サイバーセキュリティのベンチマークではMythos 5.2がFable 5.2を上回っており、Anthropicはその差をガードレールを外したことによるものだと説明しています。
目を引くのは、AnthropicによるFable 5.2の位置づけです。同社は、定型的な作業の主力モデルとして日常的に使うことを明確に推奨していません。代わりに2つの役割を提案しています。
- アドバイザー: コーディングや知識労働はOpus 5.5で始め、小さいモデルが行き詰まったときにFable 5.2へエスカレーションする。
- オーケストレーター: Fable 5.2に複雑なプロジェクトを分割させ、サブタスクをHaiku、Sonnet、Opusに委任する。
この位置づけは、乗り換えを検討する人にとって重要です。Fable 5.2は日常モデルの代替ではなく、その上に置かれたスペシャリスト層として位置づけられています。
ベンチマークが示すもの
Anthropicのベンチマーク表は、Fable 5.2をFable 5.1、Opus 5.5、OpenAIのGPT-6 Astra、GoogleのGemini 4 Carbonと比較しています。Fable 5.2はほとんどのスイートで最先端の結果に達し、特にエージェント型の科学研究とロボティクスで最大の伸びを示しました。
| ベンチマーク | Fable 5.2 | Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|---|---|---|---|
| FrontierCode 2.0(エージェント型コーディング) | 49.1% | 42.5% | - | - |
| Frontier SWE v2 | 69.9% | 62.3% | - | - |
| 業務ワークフロー自動化 | 55.4% | - | - | 63.9% |
| Terminal-Bench Science 2.1(エージェント型研究) | 74.6% | 58.7% | 68.1% | 64.8% |
| RoboDojoロボティクスシミュレーション | 64.9% | 40.6% | 29.8% | - |
業務ワークフロー自動化ではGemini 4 Carbonが明確にリードを保っており、Fable 5.2がすべてのカテゴリーで最良の選択というわけではありません。最も劇的な差はロボティクスの結果で、Fable 5.2はOpus 5.5を24ポイント以上上回り、GPT-6 Astraの2倍以上のスコアを記録しています。
独立系ベンチマークプラットフォームのArtificial Analysisも、同プラットフォームが記録した中で最高となるIntelligence Indexスコア82で首位を裏づけています。同時に、同プラットフォームはFable 5.2を追跡対象の中で最も高価なモデルとしても掲載しており、推論努力を最大にしたときの平均タスクコストは$26.54です。一方で効率面では逆の見方もできます。Fable 5.2はタスクあたりの出力トークン数が平均でSonnet 5.5よりわずかに少なく、長く考える場合でも推論は比較的簡潔であることがうかがえます。
有名俳優の詳細なSVG肖像画を描かせる独自テストでは、より複雑な結果となりました。Fable 5.2は1回の実行に19分50秒を要し、122,248トークンを消費して、コストは$4.86でした。自動判定では10点満点中7.2点で、このリーダーボードではGPT-6.1 Solの8.0、Gemini 4 Argonの7.6、GPT-6 Astraの7.3に続く6位です。自動判定は完璧ではなく、美的な評価では依然として人の目のほうが確かな基準ですが、この結果はテストの他の場面でも見られた傾向と一致します。Fable 5.2が優れているのは、見た目の仕上がりよりも論理と構造なのです。
推論努力: 多ければ良いとは限らない
Fable 5.2では、Low、Medium、High、Extra High、Maxという複数の推論努力レベルを選べます。AnthropicがFrontierCode 2.0で示したコスト対精度のグラフは、この範囲の上限で急激に収穫逓減が起きることを示しています。実際にはExtra HighのほうがMaxよりも高いスコアを出しており、最も長い思考時間は結果を悪化させる一方で、タスクあたりのコストを大幅に押し上げていました。
▲ Max推論努力での収穫逓減
予算計画でより役立つ比較は次の点です。Fable 5.2のHigh設定は、Opus 5.5のMax設定に匹敵する精度に達し、しかも完了タスクあたりの総額はより安く済みます。実用上はHighかExtra Highを既定とし、Maxは効果を確認できた場合に限って使うのが賢明でしょう。後述のゲームテストが示すように、動くコードを素早く得たいときはMediumでも十分に機能します。
価格とアクセス
Fable 5.2は、AnthropicのWebインターフェース、AWS Bedrock、Google Cloud Vertex AIを通じて即日利用できます。Webでは有料プランが必要で、無料枠には含まれません。
| プラン | 月額 | Fable 5.2の利用 |
|---|---|---|
| Free | $0 | 不可 |
| Pro | $17 | 可 |
| Max | $100 | 可 |
| Ultra | $200 | 可 |
発表週の期間中、AnthropicはProとTeamの加入者向けに、プロモーションとして利用枠のリセットと最大50%の週間利用ボーナスを提供しています。これらの特典は期間限定なので、このモデルに関心がある人は、比較的低コストで集中的に試せる機会が得られます。
API価格は入力100万トークンあたり$8、出力100万トークンあたり$40です。
| モデル | 入力(100万トークンあたり) | 出力(100万トークンあたり) |
|---|---|---|
| Claude Fable 5.2 | $8 | $40 |
| Claude Opus 5.5 | $4 | $20 |
| Claude Fable 5.1 | $10 | $50 |
| GPT-6 Astra | $10 | $50 |
Fable 5.2のコストはOpus 5.5のちょうど2倍ですが、前モデルのFable 5.1やOpenAIのGPT-6 Astraよりはわずかに安くなっています。
実際に試した結果: ゲームと物理ハードウェア
インディーゲームMegabonkのクローンを求めるテストプロンプトは、Anthropicの更新されたポリシーに引っかかりました。モデルは今や、既存のビデオゲームの知的財産をクローンしたり侵害したりする直接の要求を拒否します。しかしFable 5.2は失敗に終わるのではなく、同じジャンルのオリジナルゲームを作ることを提案してきました。できあがったのはShardstormという名の3Dホード・サバイバル型ローグライクで、自動発射の武器、経験値ジェム、レベルアップ時の選択肢、そしてVex、Oria、Pipというオリジナルキャラクターを備えています。Claude Codeを使い、推論努力Mediumで約16分で生成されたこのゲームは、バグなしで動作しました。スタミナが減るダッシュ、アップグレードで解放される二段ジャンプ、当たり判定、レベルアップ時に一時停止するメニュー、そしてSky Feather、Wisdom Seed、Star Glaive、Shell Platingといった一連のアップグレードが、すべて初回の実行で機能したのです。
弱点は見た目の演出でした。地形と敵はローポリゴンで、音声はElevenLabsのような専用AIオーディオツールに匹敵するものではなく、単純なMIDI風のループにとどまりました。同種のタスクではOpus 5.5のほうが見栄えのよいビジュアルスタイルを生み出すようで、Fable 5.2の強みは美観ではなく論理にあるという見方を裏づけています。また、新モデルを試すユーザーが増えるにつれ、生成速度はサーバー負荷によって変動する可能性があります。
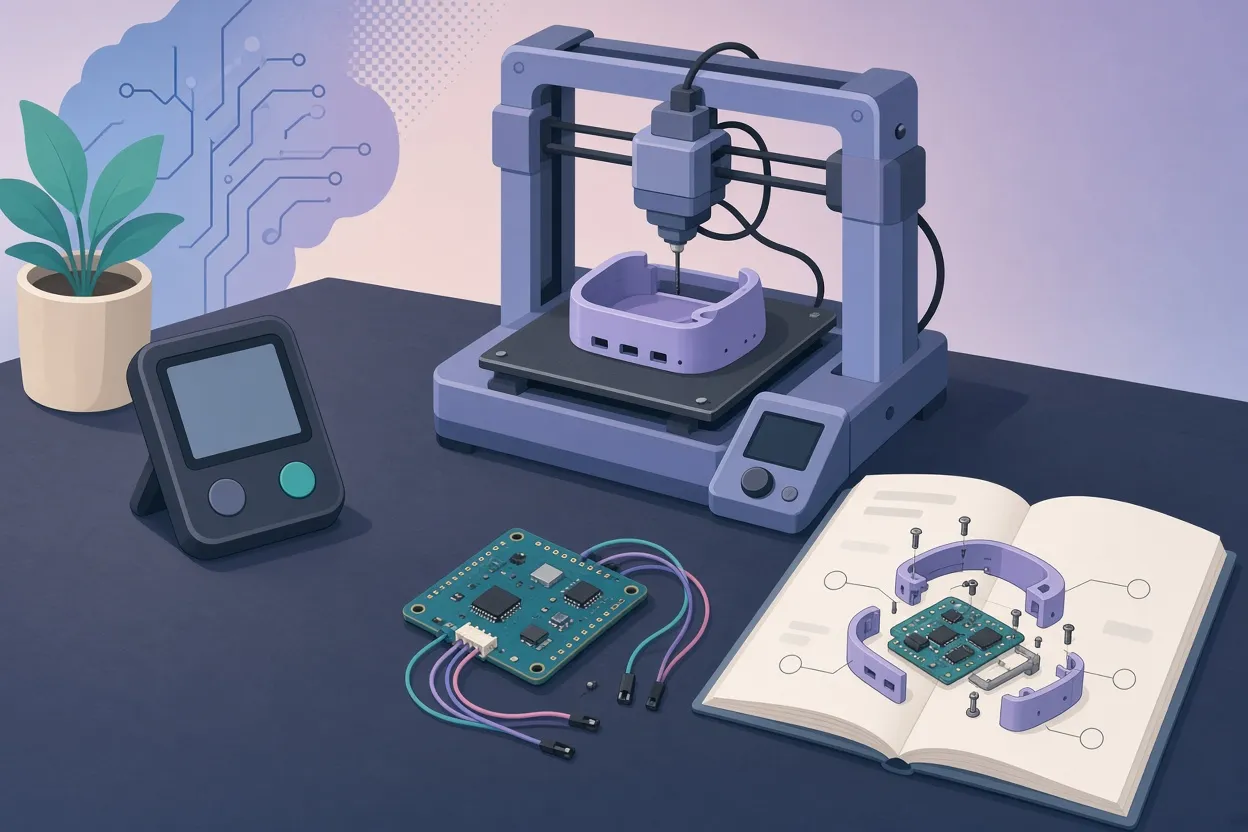
▲ AI設計の手持ちガジェットと組み立てマニュアル
ハードウェアのテストはさらに野心的なものでした。1つのプロンプトで、既製の部品、部品リスト、ファームウェア、3Dプリント用のSTLファイル、配線と組み立ての手引きを含む、完全な手持ちサイズの卓上ガジェットを求めたのです。プロンプトでは実在の俳優をテーマにするよう求めましたが、実在する存命の人物の肖像を生成しないというモデルのガードレールが働き、代わりにPixelPalというオリジナルのピクセルアート風ロボットキャラクターに置き換えられました。仕様書には具体的な部品名が記されていました。Raspberry Pi Pico Hマイコンボード、Waveshareの1.54インチ240x240 SPI LCDモジュール、16mmのモーメンタリーボタン、ジャンパーワイヤー、M3ネジ、両面フォームテープ、micro-USBデータケーブルです。STLファイルをBambu Studioで開くと、ボタンとディスプレイの切り欠きを持つフロントシェル、ディスプレイクランプ、バックプレートという印刷可能な部品が確認できましたが、画面の切り欠きは理想よりも小さく見えました。続けて推論努力Highで追加依頼をすると、約15分後に、CAD風の分解図、ピン配置表、はんだ付けの手順、トラブルシューティングのFAQを含む図解付きの組み立てマニュアルが生成されました。
Anthropicと初期テスターによるショーケース
Anthropic自身のデモは、長時間の自律的な作業に重点を置いています。ある実験では、エンジニアがFable 5.2に空のディレクトリを渡し、プロトタイプのオペレーティングシステムを作るよう依頼しました。モデルは1,000以上のサブエージェントを調整して8日間連続で稼働させ、できあがったOSは独自カーネル、デバイスドライバー、ネットワークスタック、ウィンドウマネージャー、組み込みのClaudeエージェントツールを備えて物理的なノートPCで起動しました。生化学では、2つのオープンソースのタンパク質モデルを組み合わせ、アデノ随伴ウイルスのカプシド構造全体を予測しました。ハードウェアでは、1段落のプロンプトから、音声アシスタントハブ、USBスピーカーフォン、手持ちサイズのバーチャルペットについて、回路基板の回路図、部品配置、ファームウェア、3Dプリント可能な筐体が生成されました。
X上で結果を共有した初期テスターたちも、同じ方向性で試しています。あるAIコンテンツクリエイターは、Gears of War風のプレイ可能なサードパーソンシューターを公開しました。精細な都市環境、リアルな照明、カバーアクションの仕組みを備え、16分で作られたShardstormよりはるかに視覚的に洗練されていましたが、これはより高い推論設定と数日間にわたる反復によるものと考えられます。同じチームのプロデューサーは、Zelda風のアドベンチャー、Halo風のシューター、Iron Manのフライトシミュレーター、Adobe PhotoshopとAdobe Premiereの機能するクローン、VoxRackというボイスチェンジャーアプリ、3Dの卓球ゲームなど、23のデモを2時間かけて解説する内容を公開しています。あるテックライターは、秋の京都・伏見稲荷大社を舞台にした20秒のシネマティックな旅行広告を、完全にコードだけで生成しました。鳥居に沿ったカメラトラッキングと、同期した伝統音楽を備えています。あるAI起業家は、オープンデータから実在の都市を再現するボクセルベースのゲームMirror Earthを作りました。ボクセルで再現されたサンディエゴを歩き回り、壁を殴り抜けたり、物理演算による爆発で車を壊したりできますが、宙に浮いたハトや静止したままの歩行者モデルには、自動生成の粗さも見て取れます。
乗り換えるべきか
判断は、モデルで実際に何をするかにかかっています。発表日の情報に基づけば、いくつかの経験則が成り立ちます。
- 日常的なコーディング、コンテンツ制作、一般的な知識労働にはOpus 5.5を使い続ける。平均的なユーザーは劇的な違いに気づかないかもしれず、Opus 5.5はAPI価格が半分で利用上限にも余裕がある。
- Fable 5.2は多段階の難問に使う。見つけにくいソフトウェアのバグ、複雑なアーキテクチャ、科学的なワークフロー、入り組んだ3Dシミュレーション、物理デバイスのエンジニアリングなど。
- 大規模プロジェクトではオーケストレーターとして設定し、細かな実行はAPI経由で安価なモデルに任せる。
- 既定でMax推論を使うのは避ける。HighかExtra Highで同等かそれ以上の精度がはるかに低いコストで得られる。素早いコード生成にはMediumを使い、空間的な出力、CAD設計、図解マニュアルでは努力レベルを上げる。
- ハードウェアの出力は印刷前にBambu Studioなどのスライサーで検証し、実在の公人や著作権のあるゲームタイトルに関わる依頼はオリジナルの代替案に振り替えられると想定しておく。
結論
Claude Fable 5.2は、難しい推論、エージェント型の科学研究、ロボティクス、エンジニアリングの作業において本物の飛躍と見られ、独立系のIntelligence Indexの順位もAnthropicのベンチマーク上の主張を裏づけています。一方で高価であり、日常の主力ではなくスペシャリストとして意図的に位置づけられ、見た目の仕上がりや業務ワークフロー自動化では最強の選択肢ではありません。仕事が定型的なら、Opus 5.5が引き続き実用的な選択です。小さいモデルでは解けない問題に定期的にぶつかるなら、ProとTeamプランの発表週の利用ボーナスを使えば、プロモーションのリセットが終わる前に、Fable 5.2がその価格に見合うかを低リスクで試せます。


