李维斯(Levi Strauss & Co.)用两个半月重建了BackPocket——一款帮助门店造型师查询库存、为顾客订购缺货商品的移动应用。而这款应用的上一个版本,从开发到部署花了九个月。这家服装公司将72%的周期缩短归功于对整个软件开发生命周期(SDLC,即从功能需求到生产代码的一系列步骤)的重新设计,而非某一款AI工具:整个流程围绕17个运行在GitHub Copilot上的专业智能体展开。该公司一位负责共享平台与服务的高级总监完整介绍了这套设计,从最初的纸上工作坊,到定义每个智能体的Markdown文件。对于任何正在权衡如何把智能体引入现有团队和工具链的工程组织来说,这都是一份可操作的蓝图。
先改流程,再选工具
该公司用经济学家保罗·大卫对第二次工业革命的一项观察来阐释自己的思路。工厂最初用电动机取代蒸汽机时,生产率多年几乎没有变化,因为业主沿用了原有的车间布局和工作流程。直到工厂围绕电力带来的新可能重新改建,收益才真正到来。该公司认为,软件团队在AI智能体上正处于同一节点:把智能体直接塞进一成不变的开发流水线收效甚微,而流程重设计恰恰是大多数组织跳过的那一步。
因此,在编写任何智能体之前,团队先用业务语言定义了成功的含义:
- 更快的价值交付速度,以从最初构想到工具交到造型师手中的时间来衡量。
- 更高的质量,即更少的缺陷、更少的返工和更少的上线后故障,主要抓手是自动化测试和规格驱动开发。
- 标准内置于平台,而不是事后补上。该公司已有关于可观测性、无障碍和安全设计的企业级定义,但得出的结论是:一旦标准依赖开发者的记忆就会失效。正确的路径必须成为最省力的自动化路径。
在纸上画出12次交接
一个由产品管理、软件工程、开发者效能、质量工程和AI架构人员组成的跨职能小组,合上笔记本电脑,在同一个房间里用纸笔和白板工作了三天。第一天梳理现有流程,第二天定义未来状态和目标成果,第三天找出连接两者所需的技术支撑。
现状图显示流程分为四个阶段:规划(排定优先级、撰写用户故事、拆解、估算规模并评估依赖)、构建(编写代码和单元测试、开分支和拉取请求、评审、构建与合并)、验证(QA与回归测试、验收)和发布(零售试点、零售推广)。在这些阶段之间,团队数出了六个角色之间的12次交接。两个瓶颈最为突出:由于需要跨职能对齐,撰写用户故事需要两到四周,有时长达数月;而QA回归测试在每个周期的最后阶段都雷打不动地占用三周。
这一发现改变了管理层的提问方式。团队不再问如何让人写代码更快,而是问如何用智能体消除交接之间的等待时间。
划定智能体做什么、人决定什么
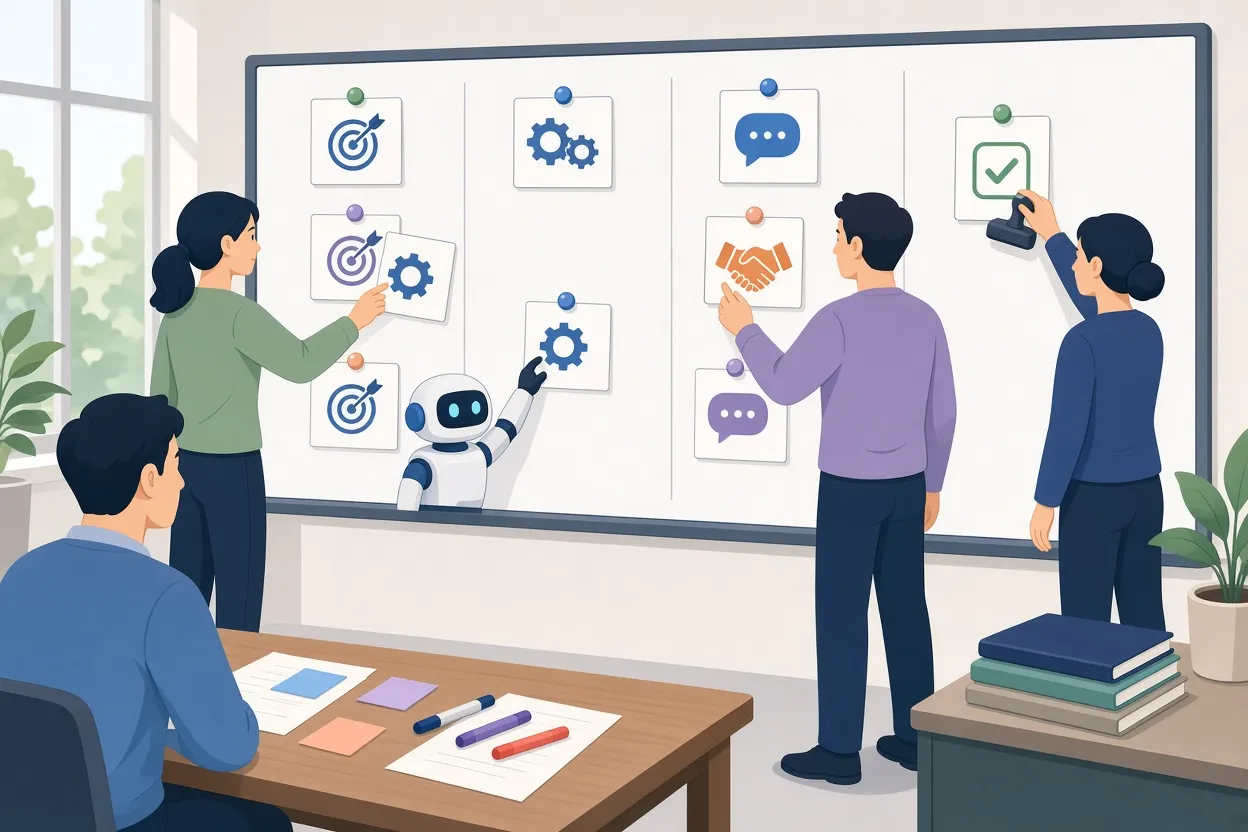
▲ 区分AI执行与人类决策的四栏分工表
第二天,团队确立了一条简单的运作规则:智能体负责执行,人做最终决定。为了落实这条规则,他们参照麦肯锡式框架搭建了一张四栏表格:成果、AI负责、人负责、人决定。
每一个旧步骤都被改写为一项成果。“撰写需求”变成了“需求清晰、对齐且跨职能一致”。然后,每项成果被拆分到其余三栏:
| 栏目 | 内容 |
|---|---|
| AI负责 | 综合、初稿起草、实现、持续监控 |
| 人负责 | 提供上下文、运用判断力、评估细微差别、管理干系人沟通 |
| 人决定 | 批准、否决或上报智能体的提案 |
把“人负责”和“人决定”分开是有意为之。该公司认为,正是这一机制让人即便在智能体承担大部分敲键盘工作的情况下,依然保持问责和掌控。
随后,表格中的每个单元格都变成一张智能体卡片,包含五个参数:触发条件、输入、动作、输出和交接。以需求智能体为例:触发条件是新的功能请求;输入是原始工单、客户请求或规格模板;动作是起草可测试的需求,并在发现缺口或歧义时向干系人提问;输出是一组整洁的可测试需求;交接则是由人类评审者确认规格并合并一个规格审批拉取请求。
一个编排者、17个专家,以及团队已在使用的工具
平台直接接入开发者已有的工作场所:GitHub.com、GitHub Copilot CLI和Visual Studio Code。一个编排智能体从这些入口接收请求,并将每个请求路由给合适的专家智能体。17个专家智能体包括:从工单起草规格的需求智能体、植入遥测并排查问题的可观测性智能体、编写并运行测试套件的测试智能体,以及覆盖应用安全、数字无障碍等领域的另外14个。
外部系统通过模型上下文协议(MCP)服务器接入,这是一种让智能体调用外部工具的标准接口。需求智能体对接作为工作记录系统的Jira;可观测性智能体与New Relic通信;测试智能体通过Playwright驱动浏览器。另有MCP服务器连接Figma、Confluence、Context7和内部设计仓库。由于连接是单独声明的,更换后端无需重写智能体本身。整套系统运行在GitHub Copilot Cloud Agent上,并通过共享技能让企业最佳实践一次编写、处处复用。
一个智能体就是一个Markdown文件
每个智能体由一个Markdown文件定义,包含YAML前置元数据头和纯文本系统指令。示例中的需求智能体定义将GPT-5.4指定为模型,并列出了面向Atlassian Jira与Confluence以及GitHub的MCP工具。因为指令是纯文本,团队中任何人无需机器学习专长就能读懂并提出修改。每份定义都写明智能体可以做什么、可以调用哪些工具,以及不得做什么。
这些文件存放在GitHub组织级的agents目录中,因此公司内每个仓库都能直接使用,无需逐仓库配置。修改像其他代码一样走拉取请求流程,因此经过同行评审、受版本控制且可审计。
从工单到上线,只设两道人工关卡
需求以EARS(Easy Approach to Requirements Syntax)编写,这是一种用于消除歧义的结构化规格格式;智能体被要求在工单不清晰时停下来向工程师求证。人在恰好两个节点充当强制检查点:评审并合并规格拉取请求,以及评审并合并最终的生产拉取请求。
规格合并后,Copilot Cloud Agent生成初始构建并开启一个草稿拉取请求。专家智能体按需运行,而不是每次变更都跑满17个。质量门禁随后按固定顺序执行:
- 单元测试与集成测试
- 无障碍
- 性能
- 代码评审
- 安全
安全有意放在最后,以便审计前面各智能体所做的每一处修改。可观测性智能体会在给出任何部署建议之前为新代码植入监测,这样变更一到生产环境,遥测就已就绪。最终的拉取请求将智能体输出整理为彼此独立、带标签的提交,并附一份汇总说明。在一个案例中,将开发者门户迁移到Next.js App Router时,迁移本身、Playwright测试修复、性能优化、无障碍调整和HTTP安全头分别对应独立提交,评审者可以逐一检查每项修复。
由智能体承载的标准
| 智能体 | 执行的标准 | 方式 |
|---|---|---|
| 安全 | OWASP漏洞与CVE | 静态审计、密钥扫描、按严重程度排序的修复提交 |
| 无障碍 | WCAG 2.2 AA | 通过Playwright在无头浏览器中测试真实页面渲染,并在拉取请求中生成修复 |
| 性能 | Core Web Vitals | 在真实浏览器会话中测量实际指标,而非合成估算 |
| 可观测性 | 默认的New Relic链路追踪与告警 | 通过拉取请求注入缺失的监测代码 |
入门套件、自动修复与内部市场
▲ 智能体、技能与MCP服务器内部市场
新仓库通过10套标准化入门套件一开始就“智能体就绪”,覆盖从TypeScript到Swift的公司主要语言。每套套件自带CI/CD工作流、文档、运行手册、一个AGENTS.md文件和Copilot指令。持续集成流水线在每个拉取请求上强制执行依赖安全审查、自动化测试、覆盖率阈值和New Relic预检验证。CI失败时,Copilot Agentic Autofix会读取日志、生成补丁并推回分支。对于老仓库,审计智能体会将项目与入门套件模板比对,并开启升级拉取请求来补齐差距。
可发现性由LS&CO Developer AI Portal提供,这是一个内部市场,收录了24个定制智能体、19个共享技能、15个MCP服务器和可复用的提示词集合。工程师可以对每个条目评分、评论和评审,并一键安装到VS Code或GitHub。
工具好办,改习惯难
该公司表示,工具是简单的部分。真正费力的是变革管理,因为角色预期的变化会带来切实的焦虑。它为一个小队制定的赋能手册如下:
- 工作坊前的预读材料,包括Gartner和麦肯锡的行业研究,以鼓励大胆设想。
- 一位精通AI的首席工程师以“教练兼队员”身份嵌入小队,参加每日站会、回答聊天提问并开展辅导。
- 在小队自己的生产代码库上进行实操培训,而不是在沙箱里。
- 每周的开发者效能答疑时间,作为一个不加评判的场合,供人提问、演示新能力和分享同事的成功案例。
- 一场要求每个团队都必须使用AI的全公司黑客马拉松,事前配有技能预培训工作坊。其中若干项目此后已进入生产环境,明年还计划举办一场企业AI大会。
该公司引用的一份光辉国际白皮书指出,高绩效工程师往往感受到最大的摩擦,因为AI要求他们放弃那些曾让自己成功的习惯。工程师必须采用规格驱动和测试先行的开发方式,并学会批判性地审查智能体的输出。每日站会从汇报状态转向讨论决策和例外情况。
四条运作原则把整个体系维系在一起:人在模糊问题上行使判断,智能体负责执行;持久的上下文存放在仓库和工单中,而不是聊天线程里——该公司认为后者目前还过于短暂;智能体和人通过同样的CI/CD和评审关卡;每一次智能体操作和人工干预都被记录在案。
一个项目的成果与教训
| 指标 | 结果 |
|---|---|
| BackPocket交付时间 | 2.5个月,此前为9个月(快72%) |
| 工程吞吐量 | 提升51% |
| 拉取请求通过率 | 提升54% |
| AI辅助的拉取请求占比 | 从26%升至69%,目标为100% |
这些是一家公司推行过程中的数据,而非通用基准。管理层原本预计吞吐量会在过渡期下滑,因此增长出乎意料。该公司也承认,如果智能体只是生成了更多代码,吞吐量上升可能是一个空洞的指标,但它认为通过率同步上升、加上MVP快速交付,说明价值是真实的。
两条技术教训尤为突出。早期让多个智能体在并行Git分支上工作的尝试引发了持续不断的合并冲突,于是团队改为在单个拉取请求内顺序执行:评审智能体发表评论,由一个辅助智能体逐条解决。此外,由于智能体在规格不完整时往往会带着虚假的自信继续推进,工作流必须设计成能尽早暴露歧义。在组织层面,最初的三天工作坊已压缩为三小时版本,用于让更多小队上手。
可以带走的要点
核心教训在于,智能体是李维斯最后才构建的东西,而不是第一步。该公司先定义了成功,摸清了时间真正流失在哪里,明确划分了哪些工作由智能体执行、哪些决定由人保留,然后才编写智能体定义,并通过MCP把它们接到Jira、Confluence、New Relic和Playwright上。
对于考虑走类似路线的团队,这套设计给出了一个顺序:
- 在碰任何工具之前,先用业务语言写下成功的含义。
- 在纸上画出当前流程,数清交接次数和等待时间。
- 把每项成果归入AI负责、人负责、人决定三栏,并让后两者保持分开。
- 用触发条件、输入、动作、输出和交接定义每个智能体,并以可评审的文本形式存入版本控制。
- 让智能体通过与人相同的关卡,安全检查放在最后,人把守规格和最终合并两道关。
- 为辅导和习惯改变预留的精力要多于安装部署。
该公司用“旧工厂里的新电机”这个比喻来概括这一警示。它的数字能否复制到其他组织还有待观察,但这份避免重蹈覆辙的蓝图异常具体。


