Levi Strauss & Co.は、店舗のスタイリストが在庫を調べたり、品切れ商品を顧客のために注文したりできるモバイルアプリ「BackPocket」を、2カ月半で作り直しました。同じアプリの前バージョンは、開発から展開までに9カ月を要していました。同社はこの72%の期間短縮を、特定のAIツールの成果ではなく、機能要望から本番コードに至る一連の手順であるソフトウェア開発ライフサイクル(SDLC)全体を、GitHub Copilot上で動く17種類の専門AIエージェントを中心に再設計した結果だと位置づけています。同社の共有プラットフォーム・サービス担当シニアディレクターが、出発点となった紙のワークショップから、各エージェントを定義するMarkdownファイルに至るまで、設計の全体像を公開しました。既存のチームとツールにエージェントをどう組み込むかを検討しているエンジニアリング組織にとって、実践的な設計図と言える内容です。
ツールより先にプロセスを変える
同社は自社のアプローチを、経済学者ポール・デイビッドが第二次産業革命について指摘した事実になぞらえて説明しています。工場が蒸気機関を電動モーターに置き換えた当初、生産性は何年もほとんど向上しませんでした。経営者が従来の工場レイアウトと作業の流れをそのまま維持していたからです。生産性が上がったのは、電気で可能になったことを前提に工場を作り直してからでした。同社は、ソフトウェアチームもAIエージェントに関して同じ地点に立っていると主張します。開発パイプラインを変えずにエージェントを投入しても成果はわずかで、多くの組織が飛ばしてしまうのがこのプロセス再設計の工程だというわけです。
そこでチームは、エージェントを1つも書く前に、ビジネスの言葉で成功の定義を決めました。
- 価値到達までの速度の向上。最初の構想からスタイリストの手元にツールが届くまでの時間で測ります。
- 品質の向上。欠陥、手戻り、デプロイ後のバグを減らすことを指し、主な手段は自動テストと仕様駆動開発です。
- 後付けではなくプラットフォームに組み込まれた標準。同社には可観測性、アクセシビリティ、セキュリティ・バイ・デザインに関する全社的な定義がすでにありましたが、開発者の記憶に頼る標準は守られないと結論づけました。正しいやり方が、最も楽で自動化された道にならなければならないという考えです。
12回の引き継ぎを紙の上に描き出す
プロダクトマネジメント、ソフトウェアエンジニアリング、開発者ベロシティ、品質エンジニアリング、AIアーキテクチャの各部門からなる横断チームが、ノートPCを閉じた状態で3日間同じ部屋にこもり、紙とホワイトボードで作業しました。1日目に現在のプロセスを描き出し、2日目に将来のあるべき姿と目標成果を定め、3日目にその2つをつなぐために必要な技術的要素を洗い出しました。
現状の図には4つの段階が現れました。Plan(優先順位付け、ユーザーストーリーの作成、分解、見積もり、依存関係の評価)、Build(コードとユニットテストの作成、ブランチとプルリクエストの作成、レビュー、ビルド、マージ)、Verify(QAと回帰テスト、受け入れ)、Release(店舗でのパイロット、店舗展開)です。これらの段階全体で、6つの役割の間に12回の引き継ぎがあると数えられました。目立ったボトルネックは2つでした。ユーザーストーリーの作成は部門間の調整のために2~4週間、時には数カ月かかり、QAの回帰テストは毎サイクルの最後に決まって3週間を消費していました。
この発見が経営層の問いを変えました。人がより速くコードを書くにはどうするかではなく、エージェントを使って引き継ぎの間の待ち時間をどう解消するかを問うようになったのです。
エージェントがやることと人が決めることを分ける
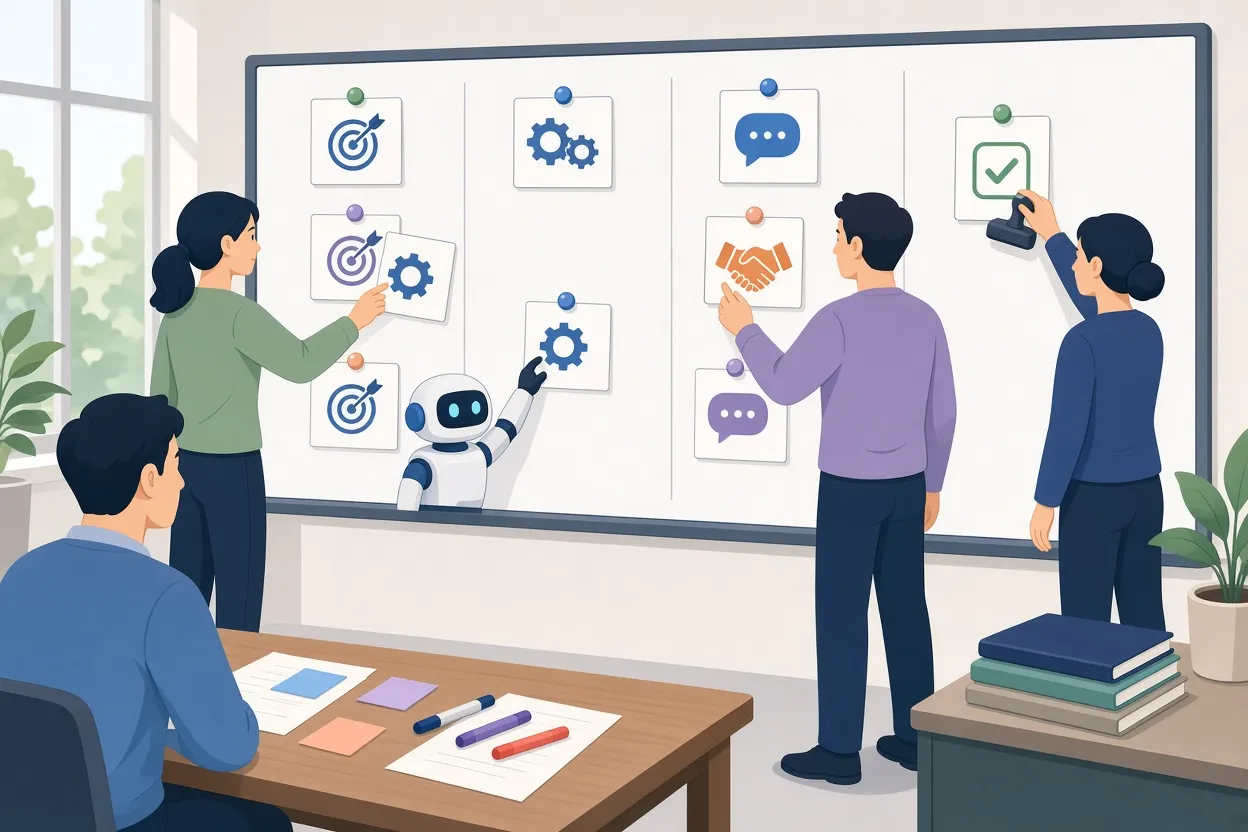
▲ AIの実行と人の判断を分ける4分割の表
2日目にチームはシンプルな運用ルールを採用しました。エージェントが実行を引き受け、人が最終判断を下す、というものです。これを適用するために、McKinsey流のフレームワークを手本にした4列の表を作りました。列は「成果(Outcomes)」「AIがやること(AI Does)」「人がやること(Human Does)」「人が決めること(Human Decides)」です。
従来の各工程はすべて成果として書き直されました。「要件を書く」は「要件が明確で、合意され、部門横断的である」になりました。次に各成果を残りの列に振り分けました。
| 列 | 入るもの |
|---|---|
| AIがやること | 統合、初稿の作成、実装、継続的な監視 |
| 人がやること | コンテキストの提供、見極め、ニュアンスの評価、ステークホルダーとのコミュニケーション管理 |
| 人が決めること | エージェントの提案の承認、却下、エスカレーション |
「人がやること」と「人が決めること」を分けているのは意図的です。同社はこれを、エージェントが入力作業の大半を担うようになっても、人が責任と主導権を保ち続けるための仕組みと捉えています。
その後、表の各マスは5つのパラメーターを持つエージェントカードになりました。トリガー、入力、アクション、出力、引き継ぎです。要件エージェント(Requirements Agent)の場合、トリガーは新しい機能要望、入力は生のチケット、顧客からの要望、仕様テンプレート、アクションはテスト可能な要件を起草し、抜けや曖昧さを検出したらステークホルダーに質問すること、出力は整ったテスト可能な要件一式、引き継ぎは人のレビュアーが仕様を確認し、仕様承認のプルリクエストをマージすることです。
1つのオーケストレーター、17の専門家、チームが使い慣れたツール
このプラットフォームは、開発者がすでに作業している場所、つまりGitHub.com、GitHub Copilot CLI、Visual Studio Codeに組み込まれています。オーケストレーション用のエージェントがこれらの入り口から要求を受け取り、それぞれを適切な専門エージェントに振り分けます。17の専門エージェントには、チケットから仕様を起草する要件エージェント、テレメトリーを組み込んで問題を調査する可観測性エージェント(Observability Agent)、テストスイートを作成して実行するテストエージェント(Testing Agent)のほか、アプリケーションセキュリティやデジタルアクセシビリティなどの領域を担う14のエージェントが含まれます。
外部システムとは、エージェントが外部ツールを呼び出すための標準インターフェースであるModel Context Protocol(MCP)サーバーを通じて接続します。要件エージェントは作業の記録システムであるJiraに、可観測性エージェントはNew Relicに、テストエージェントはPlaywright経由でブラウザーにアクセスします。さらに別のMCPサーバーがFigma、Confluence、Context7、社内のデザインリポジトリをつなぎます。接続は個別に宣言されているため、エージェント自体を書き換えずにバックエンドを差し替えられます。すべてはGitHub Copilot Cloud Agent上で動作し、共有スキルによって全社のベストプラクティスを一度書けば再利用できるようになっています。
エージェントの正体は1つのMarkdownファイル
各エージェントは、YAMLフロントマターのヘッダーと平文のシステム指示からなる1つのMarkdownファイルで定義されています。サンプルとして示された要件エージェントの定義では、モデルにGPT-5.4を指定し、Atlassian JiraとConfluence、およびGitHub向けのMCPツールを列挙しています。指示が平文なので、機械学習の専門知識がなくてもチームの誰もが読んで変更を提案できます。各定義には、そのエージェントが何をしてよいか、どのツールを呼び出せるか、何をしてはいけないかが記されています。
これらのファイルはGitHubの組織レベルのエージェント用ディレクトリに置かれ、リポジトリごとの設定なしに社内のあらゆるリポジトリから利用できます。変更は他のコードと同じくプルリクエストを通すため、ピアレビューとバージョン管理の対象になり、監査も可能です。
チケットから本番まで、人のゲートは2カ所
要件は、曖昧さのない仕様を書くための構造化フォーマットであるEARS(Easy Approach to Requirements Syntax)で記述され、チケットが不明確な場合、エージェントは作業を止めてエンジニアに確認するよう指示されています。人が必須のチェックポイントとして関わるのはちょうど2カ所、仕様のプルリクエストをレビューしてマージする時点と、最終的な本番向けプルリクエストをレビューしてマージする時点です。
仕様がマージされると、Copilot Cloud Agentが最初のビルドを生成し、ドラフトのプルリクエストを開きます。専門エージェントは、変更のたびに17すべてが動くのではなく、必要なものだけが実行されます。その後、品質ゲートが決まった順序で実行されます。
- ユニットテストと統合テスト
- アクセシビリティ
- パフォーマンス
- コードレビュー
- セキュリティ
セキュリティを最後に回すのは意図的で、先行するエージェントが加えたすべての変更を監査するためです。可観測性エージェントはデプロイを推奨する前に新しいコードに計装を施すため、変更が本番に到達した瞬間からテレメトリーが有効になります。出来上がるプルリクエストでは、エージェントの出力がラベル付きの個別のコミットにまとめられ、統合された要約が添えられます。ある例では、開発者ポータルをNext.jsのApp Routerへ移行した際、移行そのもの、Playwrightテストの修正、パフォーマンス最適化、アクセシビリティ調整、HTTPセキュリティヘッダーがそれぞれ別のコミットになり、レビュアーが修正を1つずつ確認できました。
エージェントが担う標準
| エージェント | 守らせるもの | 方法 |
|---|---|---|
| セキュリティ | OWASPの脆弱性とCVE | 静的監査、シークレットスキャン、深刻度順の修正コミット |
| アクセシビリティ | WCAG 2.2 AA | Playwright経由でヘッドレスブラウザー上の実際のページ描画をテストし、PR内で修正を生成 |
| パフォーマンス | Core Web Vitals | 合成的な推定ではなく、実際のブラウザーセッションで実測 |
| 可観測性 | New Relicの標準トレースとアラート | 不足している計装をプルリクエストで注入 |
スターターキット、自動修正、社内マーケットプレイス
▲ エージェント、スキル、MCPサーバーの社内マーケットプレイス
新しいリポジトリは、TypeScriptからSwiftまで同社の主要言語を網羅する10種類の標準化されたスターターキットによって、最初から「エージェント対応」の状態で始まります。各キットにはCI/CDワークフロー、ドキュメント、ランブック、AGENTS.mdファイル、Copilot向けの指示が同梱されています。継続的インテグレーションのパイプラインは、すべてのプルリクエストに対して依存関係のセキュリティレビュー、自動テスト、カバレッジのしきい値、New Relicのプリフライト検証を強制します。CIが失敗すると、Copilot Agentic Autofixがログを読み、パッチを生成してブランチにプッシュし返します。古いリポジトリに対しては、監査エージェントがプロジェクトをスターターキットのテンプレートと比較し、差分を埋めるアップグレードのプルリクエストを開きます。
見つけやすさを支えるのがLS&CO Developer AI Portalです。24のカスタムエージェント、19の共有スキル、15のMCPサーバー、再利用可能なプロンプト集を備えた社内マーケットプレイスで、エンジニアは各項目を評価、コメント、レビューでき、ワンクリックでVS CodeやGitHubにインストールできます。
ツール導入は簡単、習慣を変えるのは難しかった
同社によれば、ツールの整備は簡単な部分でした。大変だったのは変革管理です。役割への期待が変わることは、現実的な不安を生むからです。スクワッド(チーム)向けの支援プレイブックは次のようなものです。
- ワークショップ前の事前資料。GartnerやMcKinseyの業界調査を含め、野心的な発想を促します。
- AIに精通したプリンシパルエンジニアがプレイングコーチとしてスクワッドに加わり、デイリースタンドアップに参加し、チャットの質問に答え、コーチングセッションを実施します。
- サンドボックスではなく、スクワッド自身の本番コードベースを使った実践的なトレーニング。
- 週次の開発者ベロシティ・オフィスアワー。質問、新機能のデモ、同僚の成功事例の共有を、評価を気にせず行える場です。
- 全チームがAIを使うことを義務づけた全社ハッカソン。事前にスキル習得ワークショップを開きました。ハッカソンのプロジェクトのいくつかはその後本番に移行し、来年には全社AIカンファレンスが計画されています。
同社が引用するKorn Ferryのホワイトペーパーは、高い成果を上げてきたエンジニアほど最も大きな摩擦を経験することが多いと示唆しています。AIは、彼らを成功に導いてきた習慣を捨てるよう求めるからです。エンジニアは仕様駆動かつテストファーストの開発を取り入れ、エージェントの出力を批判的にレビューすることを学ぶ必要がありました。デイリースタンドアップは、進捗報告の場から、判断と例外を扱う場に変わりました。
システム全体を支えているのは4つの運用原則です。曖昧な問題では人が判断を下し、エージェントが実行を担うこと。永続的なコンテキストはチャットのスレッドではなくリポジトリとチケットに置くこと(同社は現時点ではチャットは一時的すぎると考えています)。エージェントも人も同じCI/CDとレビューのゲートを通ること。そして、エージェントのすべてのアクションと人によるすべての上書きを記録することです。
1つのプロジェクトから得た成果と教訓
| 指標 | 結果 |
|---|---|
| BackPocketの納期 | 9カ月から2.5カ月に短縮(72%高速化) |
| エンジニアリングのスループット | 51%増 |
| プルリクエストの合格率 | 54%向上 |
| AI支援によるプルリクエストの割合 | 26%から69%へ、目標は100% |
これらは1社の導入事例の数値であり、一般的なベンチマークではありません。経営層は移行期間中にスループットが落ち込むと予想していたため、増加は驚きでした。同社はまた、エージェントが単により多くのコードを生成しただけなら、スループットの増加は中身のない指標になりうることも認めています。それでも、合格率の上昇とMVPの迅速な納品が同時に起きていることが、実質的な価値を示していると主張しています。
技術面の教訓は2つあります。初期に複数のエージェントを並行するGitブランチで作業させたところ、マージの競合が絶えなかったため、チームは1つのプルリクエスト内での逐次実行に切り替えました。レビューエージェントがコメントを投稿し、補助エージェントがそれを1つずつ解決する形です。また、仕様が不完全だとエージェントは根拠のない自信で先に進んでしまう傾向があるため、ワークフローは曖昧さを早い段階で表面化させるよう設計しなければなりません。組織面では、当初3日間だったワークショップが、追加のスクワッドを受け入れるための3時間版に凝縮されました。
この事例から学ぶこと
核心となる教訓は、Levi Strauss & Co.がエージェントを最初ではなく最後に作ったという点です。同社は成功を定義し、実際にどこで時間が失われているかを描き出し、エージェントが実行する作業と人が握り続ける判断を明示的に切り分け、そのうえで初めてエージェントの定義を書き、MCPを通じてJira、Confluence、New Relic、Playwrightに接続しました。
同様の取り組みを検討するチームに向けて、この設計は次の順序を示唆しています。
- ツールに触れる前に、成功の意味をビジネスの言葉で書き出す。
- 現在のプロセスを紙に描き、引き継ぎと待ち時間の数を数える。
- すべての成果を「AIがやること」「人がやること」「人が決めること」に振り分け、後の2つは分けたままにする。
- 各エージェントをトリガー、入力、アクション、出力、引き継ぎで定義し、レビュー可能なテキストとしてバージョン管理に保存する。
- エージェントにも人と同じゲートを課し、セキュリティは最後に実行し、仕様と最終マージには人が関わり続ける。
- 導入作業よりもコーチングと習慣の変化に多くの労力を見込む。
同社はこの警告を、古い工場に新しいモーターを据えるという比喩で締めくくっています。その数値が他の組織にも当てはまるかはまだ分かりませんが、その過ちを避けるための設計図としては、異例なほど具体的です。


