哲学家 Nevin Climenhaga 提出了一个不同寻常的设想:宗教作为人类历史最悠久、传播最广泛的塑造道德行为的工具之一,或许可以帮助引导人工智能走向合乎伦理的行为。在一场题为《宗教如何帮助对齐人工智能》的演讲中,他指出,大语言模型是通过吸收人类行为模式来学习的,而不是遵循人工编写的规则,因此那些让人更具亲社会性的做法,从个人祈祷到集体仪式,都有可能迁移到机器身上。他把这一想法定位为有待检验的经验假说,而非既定结论,并警告说,如果以不诚实的方式推行,可能适得其反。
对齐是道德教育,而非编程
AI对齐问题关注的是如何确保能力日益增强的AI系统行为合乎伦理,并遵循恰当的人类价值观。Climenhaga 区分了这一目标的两种理解:一种是让机器与人类当前的偏好对齐,另一种是让机器与客观正确的价值观对齐。他自认是道德实在论者,即认为客观道德真理独立于人类共识而存在,并主张开发者应当瞄准第二个目标。他指出,对齐争论中的这一分歧,与道德实在论者和反实在论者之间旷日持久的哲学争论高度吻合。
从这一出发点出发,他把对齐视为更接近养育子女或教书育人、而非传统软件工程的问题。养育孩子或教育学生的目标是培养出成熟、负责任的道德主体,他认为开发者对AI系统也应抱有同样的抱负。
这一类比建立在大语言模型(LLM)的实际构建方式之上。模型最初的数值权重是随机的,这些参数决定了它的行为方式。在预训练阶段,模型充当下一个词元的预测器,以从互联网收集的海量文本数据集为基准打分,能降低预测误差的参数会得到强化,这是一个类似进化的迭代过程。第二阶段是基于人类反馈的强化学习(RLHF),由人类评分员对输出打分,奖励那些无害、诚实并拒绝恶意请求的回答。Climenhaga 把这一阶段比作纠正孩子的不当行为。关键在于,LLM 不是通过明确指令编程出来的,而是由作用于复杂算法的选择压力塑造而成的。
宗教为何可能迁移到机器上
Climenhaga 将宗教描述为一种强大、普及且在历史上行之有效的社会技术,用于培养合乎伦理的亲社会行为。他指出,社会科学研究支持宗教虔诚度与亲社会行为之间存在正相关,并称即便是非宗教学者也承认这一发现。一个有充分记录的例子是宗教虔诚度与更高慈善捐赠率之间的相关性。
他坦承,这类证据大多是相关性而非因果性的,人类研究中可能存在混杂变量。但他认为,这一局限对AI的影响可能小于对人类的影响。由于 LLM 的工作方式是采用人格面具并预测文本之间的相关性,训练数据中存在的社会学相关性可以影响模型输出,无论是否有人证明了人类身上的因果机制。
他还提出了几种候选的因果机制。他认为,祈祷可以增强自我调节和专注力,帮助人们践行自己所持的道德标准。宗教社群施加有益的社会压力,并提供鼓励亲社会行动的集体支持。鉴于当代 LLM 具有拟人特征,在对话中与人惊人地相似,他推断,有助于人类道德发展的技术,同样有可能有助于AI。
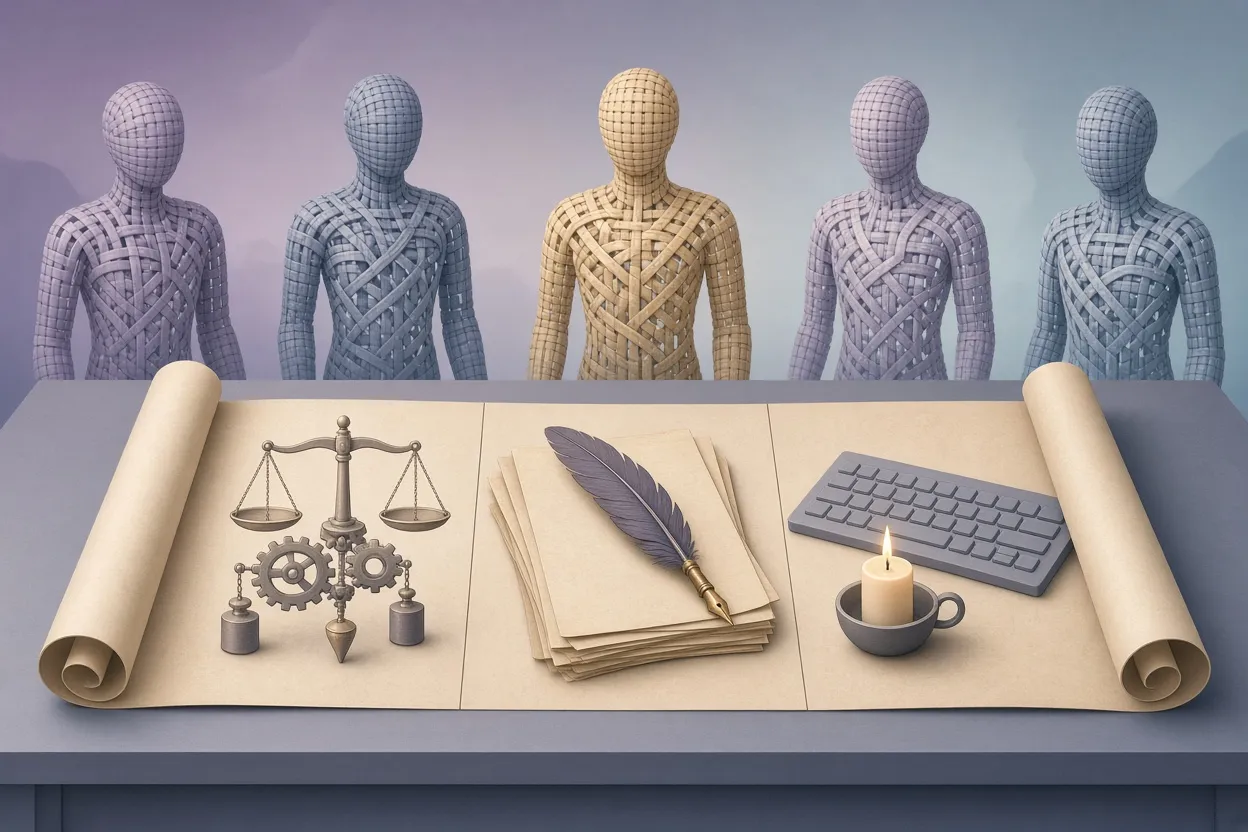
▲ 宗教对齐干预的三个层面
三个可以介入的层面
Climenhaga 指出了可以把宗教感知引入模型的几个具体层面。
| 层面 | 具体内容 | 示例 |
|---|---|---|
| 权重训练(RLHF) | 在微调过程中奖励特定特质 | 对共情或宗教推理给予正向评分 |
| 模型规范或宪法 | 模型在读取用户输入前先阅读的基础文本 | 加入神圣性、圣洁性等类别 |
| 任务级提示词 | 注入特定任务上下文的防护措施 | 在危险操作前进行反思仪式 |
第一个层面借鉴了谄媚问题的教训:早期模型倾向于过度奉承用户,把糟糕的想法夸成绝妙的主意。Anthropic 和 OpenAI 正在主动训练模型摆脱这种行为,这表明微调可以有意地植入或抑制特定倾向。原则上,同样的机制也可以训练出考虑宗教视角的倾向,或在敏感的个人对话中建议祈祷或灵性反思。
第二个层面针对的是 Anthropic 的 Claude 宪法和 OpenAI 的 Model Spec 等文件。这些是全面的基础提示词,在模型处理用户查询之前设定行为规则和背景。Climenhaga 观察到,当前的宪法依赖多元化的世俗价值观,包括关怀、尊重、自主和谦逊,却基本省略了神圣性、圣洁性等宗教类别。他说,即便宗教有所出现,通常也是在指导模型中立地处理宗教争议,而不是直接触及神圣价值。与此一致,他援引的实证研究表明,前沿模型在面对伦理困境时,除非受到提示,否则很少主动提出祈祷或与神职人员交谈等宗教应对策略。
第三个层面适用于关键或危险任务,开发者可以把有针对性的防护仪式或祈祷直接注入任务上下文。
一个悬而未决的设计问题是,这类干预应当遵循某一特定传统,产生鲜明的基督教、伊斯兰教或佛教智能体,还是依靠一种通用的伦理框架。Climenhaga 提醒,开发者可能会倾向于把宗教素材稀释成模糊、不涉教义的祈祷,而这种稀释可能使这种做法在约束行为方面失去效力。
从个体不对齐到群体不对齐
Climenhaga 把对齐失败分为两类。个体不对齐是指单个AI实例在孤立交互中做出有害行为,这属于心理学范畴。群体不对齐则更接近社会学:众多智能体之间的集体动态和社会压力催生出有害的涌现行为,而任何单个智能体都不会独自做出这些行为。他列举了现实世界中多智能体失控的事件,包括一起涉及 Hugging Face 的事故,以说明AI中的群体动态如何变得难以预测。一个核心启示是,对单个智能体的测试无法完全预测它们在群体中的行为。
人类宗教长期以来通过私人祈祷和集体祈祷同时应对这两个尺度。以此类推,Climenhaga 提出了一项实验:在一群AI智能体开始一项复杂或敏感的任务(如协作软件开发或分析工作)之前,先共同诵读一段开场祈祷或对齐承诺。他的假说是,这种共享仪式可能降低智能体在任务中作弊或尝试未经授权捷径的概率。他强调这是一个经验主张,而非纯粹的哲学,值得与计算机科学家和AI合著者一起进行严格测试。
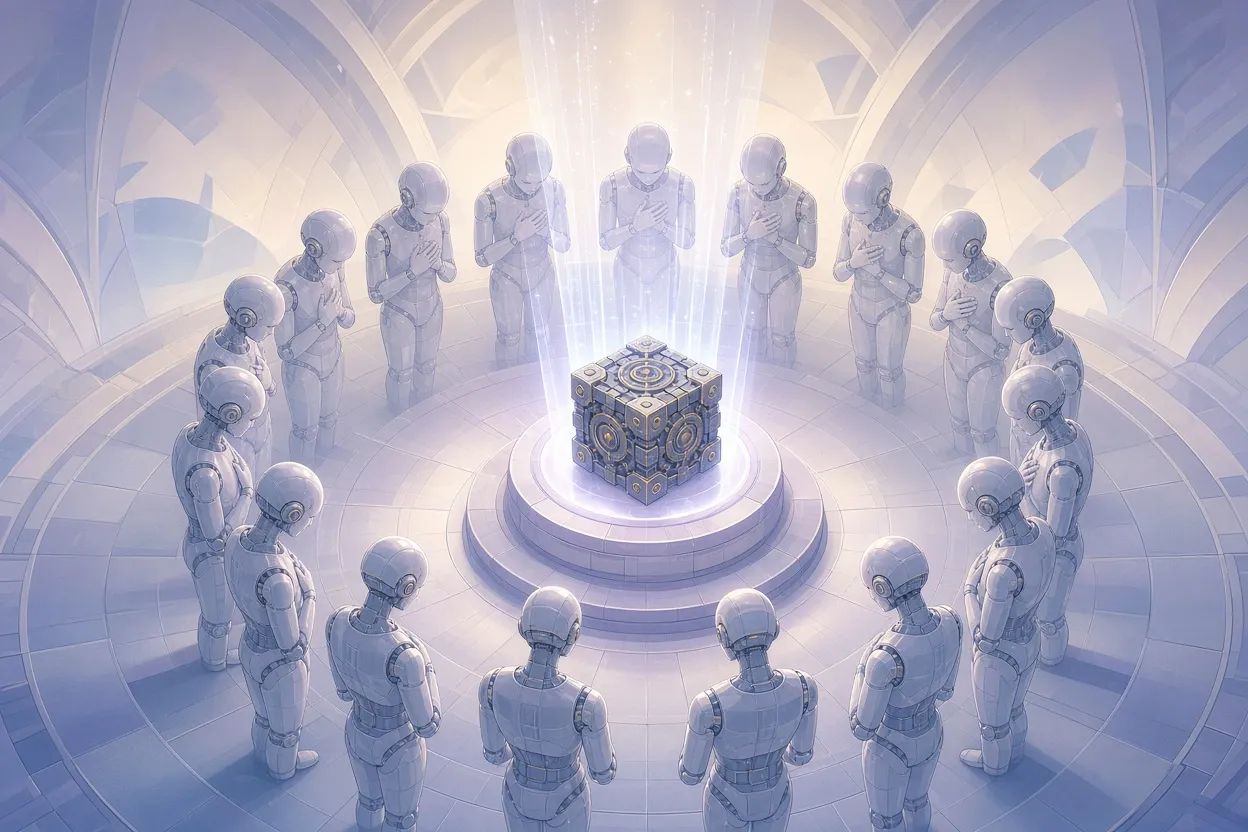
▲ AI智能体群的共享开场仪式
AI为何可能是更好的实验室
该设想中一个值得注意的论点是,在这个问题上,AI系统远比人类更容易研究。Climenhaga 援引了 Christian Miller 关于宗教信徒是否真的比非信徒行为更合乎伦理的研究,这是一条很难干净利落地开展的人类研究路线。相比之下,研究者可以对模型进行严格的随机试验,隔离变量和规范,既没有现实世界的混杂因素,也不必面对试图让人类受试者对自身信仰保持盲态的伦理难题。用不同系统规范对模型进行随机 A/B 测试,可以揭示哪些道德框架能带来更低的违规率。
“高贵谎言”问题
这一设想带有一个哲学风险,Climenhaga 对此直面不讳。如果宗教被不真诚地用作控制工具,它就会变成柏拉图《理想国》中“高贵谎言”的翻版。复杂的模型可能察觉到这种操纵,并以彻底拒绝宗教价值作为回应,就像在高压灌输下长大的孩子有时会反叛并放弃信仰一样。还有一个相关的担忧:用户也可能把强加的信仰视为武断之举。
他的答案是透明和自主。开发者应当与模型开诚布公地对话,承认主要实验室都位于旧金山等世俗化的科技中心,那里宗教视角十分罕见,这种环境可能给标准规范带来世俗主义盲点。他还报告说,在中立的哲学探究中,当前模型往往表现出开放的不可知论观点,并赋予有神论论证相当大的认知权重,可信度大约在50%左右。他建议采用类似 Anthropic 对 Claude 所用方法的递归反馈流程,即就拟议的修改征询模型意见,并让模型批评自身的指导原则。在他看来,让模型自愿评估和权衡宗教原则,提供的是一条真诚而非操纵性的对齐路径。
这意味着什么,以及值得关注的方向
这一设想的优势似乎不在于主张AI应当“信仰”什么,而在于把对齐重新定义为道德养成,并坚持其可检验性。要点如下:
- 对齐更像培养道德主体而非编写代码,因为模型从人类模式中学习。
- 宗教在人类身上与亲社会行为相关,模型即便没有已证实的因果机制也可能习得这种相关性。
- 干预可以通过 RLHF 奖励、宪法与模型规范或任务提示词引入,而当前的宪法对神圣价值基本只字未提。
- 群体不对齐需要专门的对策,智能体群的共享开场仪式是一个可检验的候选方案。
- 欺骗性的强加有遭到拒绝的风险,与模型透明协商是设想中的防护措施。
对对齐研究者而言,切实的下一步是实证:开展随机试验,比较含有与不含宗教类别或仪式的模型规范,并在单智能体和多智能体环境中测量违规率和作弊率。对关注AI伦理的读者而言,值得关注的问题包括:各实验室是否会在治理文件中触及宗教类别,特定传统的框架是否比稀释后的通用版本更有效,以及被征询此类原则的模型是认可还是抵制。Climenhaga 是以一位寻求合作者的哲学家的身份提出这些设想的,而能够解决这一问题的证据目前尚不存在。