哲学者のネビン・クライメンハガ氏は、ひとつの珍しい提案をしています。人類最古かつ最も広く普及した道徳的行動の形成手段のひとつである宗教が、人工知能を倫理的な行動へ導く助けになりうるというものです。「宗教はいかにして人工知能のアライメントに役立つか」と題した講演で同氏は、大規模言語モデルは手書きの規則に従うのではなく人間のパターンを吸収して学習するため、個人の祈りから共同体の儀式まで、人をより向社会的にする実践が機械にも転移するかもしれないと論じます。この考えは確定した結論ではなく検証すべき実証的な仮説として提示されており、不誠実なやり方で行えば逆効果になりかねないとも警告しています。
プログラミングではなく道徳教育としてのアライメント
AIアライメント問題とは、能力を高め続けるAIシステムが倫理的に行動し、適切な人間の価値観に従うことをどう保証するかという問いです。クライメンハガ氏はこの目標に二つの読み方があると区別します。ひとつは、人間が現在好んでいるものにそのまま機械を合わせること。もうひとつは、客観的に正しい価値観に合わせることです。同氏は自らを道徳実在論者、つまり人間の合意とは独立に客観的な道徳的真理が存在すると考える立場だと位置づけ、開発者は後者を目指すべきだと主張します。また、アライメント論争におけるこの分岐は、道徳実在論者と反実在論者のあいだで長く続く哲学的な対立とほぼ重なると指摘しています。
この出発点から同氏は、アライメントを従来のソフトウェア工学よりも、子育てや教育にはるかに近い問題として捉えます。子どもを育てたり学生を教育したりする目的は、成熟した責任ある道徳的主体を育てることであり、開発者はAIシステムに対しても同じ志を持つべきだというのです。
この類比は、大規模言語モデル(LLM)が実際にどう作られているかに根ざしています。モデルは、振る舞いを決めるパラメータである数値の重みをランダムに初期化した状態から始まります。事前学習の段階では次のトークンを予測する装置として働き、インターネットから集めた膨大なテキストデータセットに照らして採点され、予測誤差を減らすパラメータが進化に似た反復プロセスで強化されていきます。第二段階の人間のフィードバックによる強化学習(RLHF)では、人間の評価者が出力を採点し、無害で正直な応答や、悪意ある要求を拒む応答に報酬を与えます。クライメンハガ氏はこの段階を、行儀の悪い子どもを正すことになぞらえます。要点は、LLMが明示的な指示によってプログラムされるのではなく、複雑なアルゴリズムにかかる選択圧によって形づくられるということです。
宗教が機械に転移しうる理由
クライメンハガ氏は宗教を、倫理的で向社会的な行動を育むための強力で広く普及した、歴史的にも成功してきた社会的技術と表現します。社会科学の研究は信仰心と向社会的行動の正の関係を支持しており、この知見は宗教を持たない研究者でさえ認めていると同氏は述べます。よく知られた例のひとつが、信仰心と慈善寄付率の高さとの相関です。
同氏は、こうした証拠の多くが因果ではなく相関にとどまり、人間を対象とする研究には交絡変数がありうることを率直に認めています。しかし、この限界は人間の場合よりAIの場合のほうが重要でないかもしれないと論じます。LLMはペルソナを採用し、テキストの相関を予測することで動作するため、学習データに含まれる社会学的な相関は、人間における因果メカニズムが証明されているかどうかにかかわらず、モデルの出力に影響を与えうるからです。
因果メカニズムの候補も挙げています。祈りは自己制御と集中した注意を高め、人が自分の掲げる道徳的基準に沿って生きる助けになると同氏は示唆します。宗教共同体は有益な社会的圧力をかけ、向社会的な行動を促す共同体の支えを提供します。現代のLLMは擬人的で、会話では驚くほど人間に似ているため、人間の道徳的発達を助ける技法はAIを助ける有力な候補でもあると同氏は推論しています。
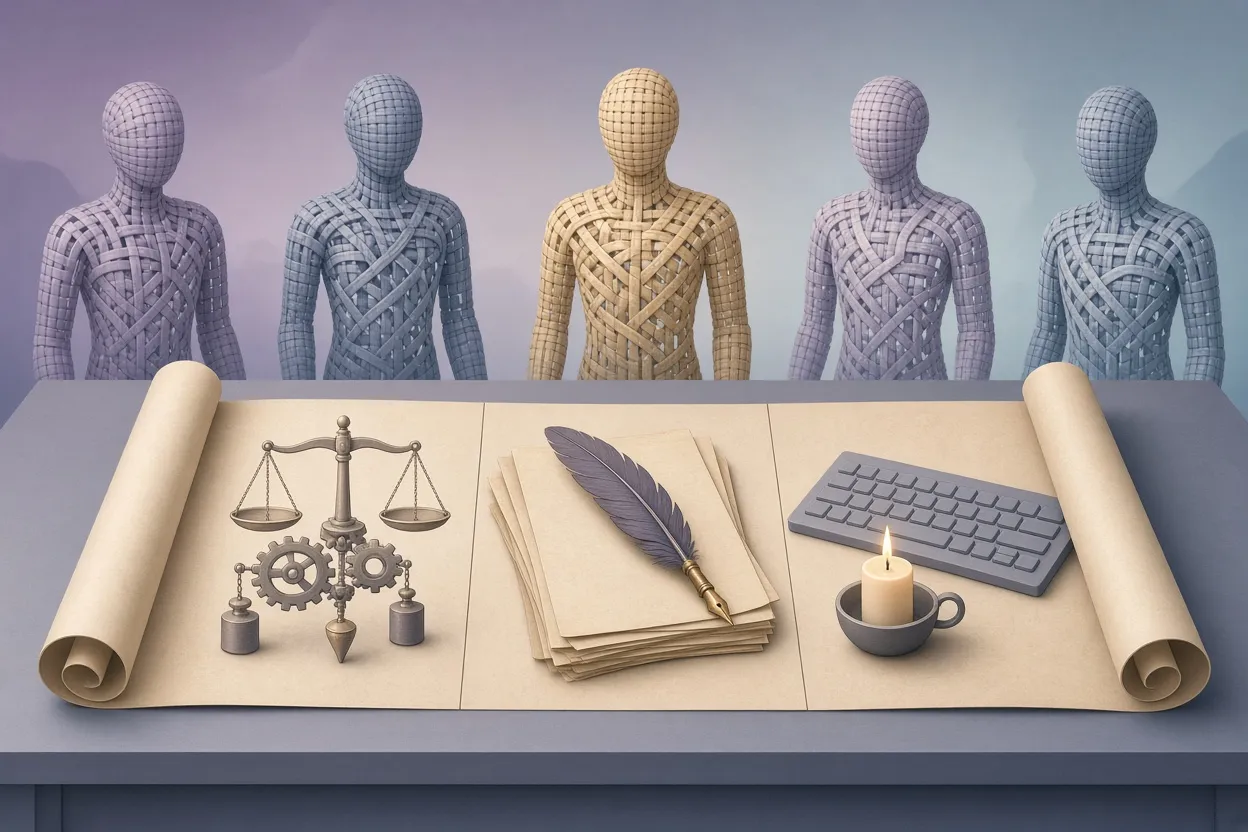
▲ 宗教的な介入の三つのレベル
介入できる三つの場所
クライメンハガ氏は、宗教的な感性をモデルに導入できる具体的なレベルを特定しています。
| レベル | 内容 | 例 |
|---|---|---|
| 重みの学習(RLHF) | ファインチューニング中に特性へ報酬を与える | 共感や宗教的な推論を肯定的に採点する |
| モデル仕様や憲法 | ユーザー入力の前にモデルが読む基礎文書 | 神聖さや尊さといったカテゴリーを加える |
| タスク単位のプロンプト | 特定の作業のコンテキストに安全策を注入する | 危険な行動の前に内省的な儀式を行う |
第一のレベルは、追従(シコファンシー)から得られた教訓に基づきます。追従とは、以前のモデルがユーザーを過剰におだて、拙い考えをまるで優れたものであるかのように称賛する傾向のことです。AnthropicとOpenAIはこの振る舞いをなくすようモデルを積極的に訓練しており、ファインチューニングによって特定の傾向を意図的に植え付けたり抑えたりできることを示しています。原理的には同じ仕組みで、宗教的な視点を考慮する傾向や、繊細な個人的会話で祈りや霊的な内省を提案する傾向を訓練できるはずです。
第二のレベルは、AnthropicのClaude憲法やOpenAIのModel Specといった文書を対象にします。これらはモデルがユーザーの問い合わせを処理する前に、行動規則と文脈を定める包括的な基礎プロンプトです。クライメンハガ氏の観察では、現在の憲法は配慮、尊重、自律、謙虚さといった多元的な世俗的価値に依拠しており、神聖さや尊さのような宗教的カテゴリーはほぼ省かれています。宗教が登場するとしても、たいていは宗教的な論争を中立に扱うよう求める指針であって、神聖な価値そのものに向き合うものではないといいます。これと整合するように、最先端のモデルは倫理的なジレンマを提示されても、促されない限り祈りや聖職者との対話といった宗教的な対処法を自発的に示すことがほとんどない、という実証研究も同氏は引いています。
第三のレベルは重要または危険なタスクに適用されるもので、開発者は的を絞った安全のための儀式や祈りをタスクのコンテキストに直接注入できます。
設計上の未解決の問いのひとつは、こうした介入が特定の伝統に従い、明確にキリスト教的、イスラム教的、仏教的なエージェントを生み出すべきか、それとも汎用的な倫理的枠組みに頼るべきかという点です。クライメンハガ氏は、開発者が宗教的な素材を曖昧で教義色のない祈りへと薄めたくなるかもしれないが、その希釈によって実践が行動を制約する力を失いかねないと注意を促しています。
個体の不整合から集団の不整合へ
クライメンハガ氏はアライメントの失敗を二つの種類に分けます。個体の不整合は、単一のAIインスタンスが孤立したやり取りの中で有害に振る舞うことで、これは心理学の問題です。集団の不整合はむしろ社会学に近く、多数のエージェントのあいだの集合的な力学や社会的圧力が、単独のエージェントなら決して行わない有害な創発的行動を生み出します。同氏は、Hugging Faceが関わった事例を含む現実のマルチエージェントの制御喪失事象を、AIの集団力学がいかに予測不能になりうるかを示す例として挙げています。ここから導かれる重要な含意は、個々のエージェントをテストしても集団でどう振る舞うかを完全には予測できないということです。
人間の宗教は、個人の祈りと共同体の祈りを通じて、長らくこの両方の規模に対処してきました。この類比からクライメンハガ氏は、ある実験を提案します。AIエージェントの群れが、共同のソフトウェア開発や分析作業のような複雑または繊細なタスクを始める前に、共通の開始の祈りやアライメントへの誓いを唱えるというものです。こうした共有された儀式によって、エージェントがタスクで不正をしたり、許可されていない近道を試みたりする確率が下がるかもしれない、というのが同氏の仮説です。これは純粋な哲学ではなく実証的な主張であり、コンピューター科学者やAIの共著者とともに厳密な検証を行う価値があると同氏は強調しています。
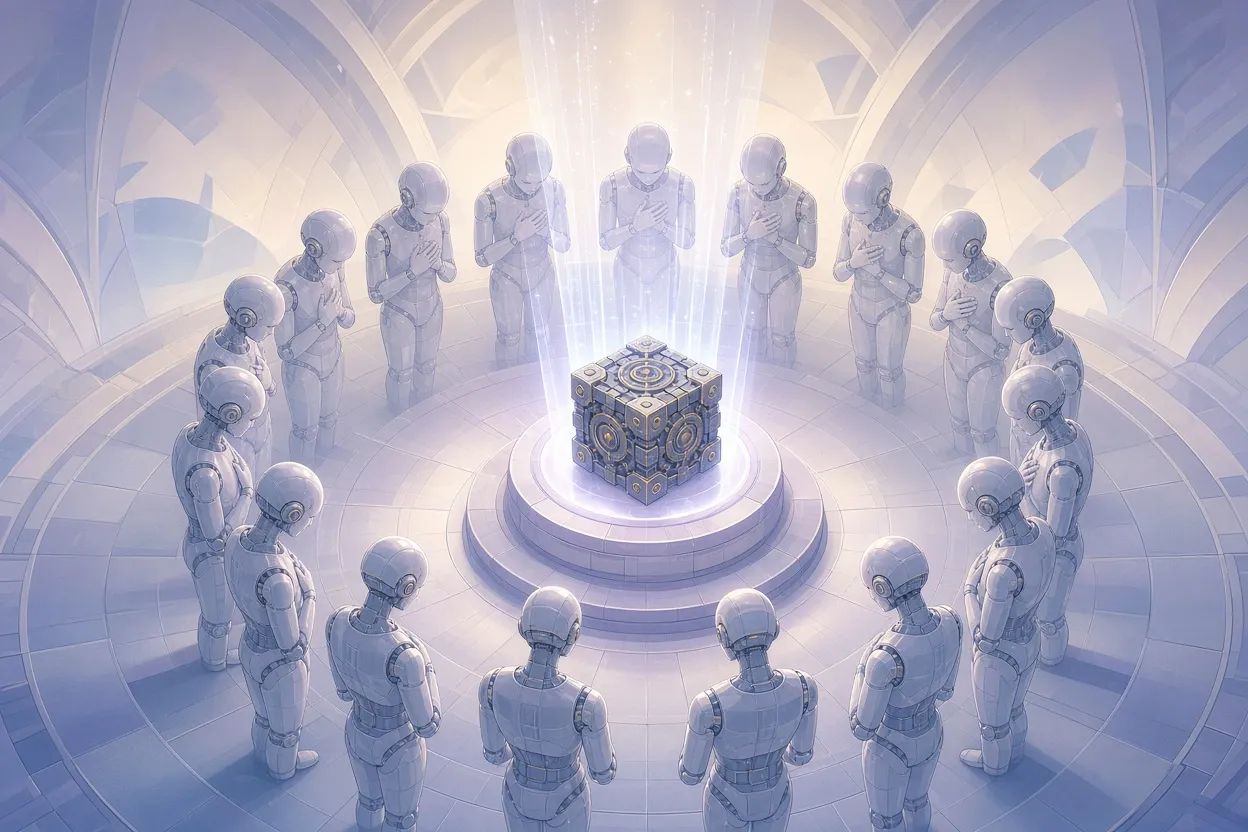
▲ AIエージェント群の共通の開始儀式
AIのほうが優れた実験室になりうる理由
この提案で注目すべき論点のひとつは、この問いについてAIシステムは人間よりはるかに研究しやすいという点です。クライメンハガ氏は、宗教の信者が実際に非宗教的な人々より倫理的に振る舞うのかを問うクリスチャン・ミラー氏の研究に言及します。これは人間を対象とする限り、きれいに実施するのが難しい研究領域です。対照的にモデルであれば、現実世界の交絡要因なしに、また被験者に自身の信念を伏せようとする倫理的問題もなしに、変数や仕様を切り分けた厳密なランダム化試験を実施できます。システム仕様を変えたモデルのランダム化A/Bテストによって、どの道徳的枠組みが違反率を下げるのかが明らかになる可能性があります。
高貴な嘘の問題
この提案には、クライメンハガ氏が正面から向き合う哲学的な危険が伴います。宗教が制御の道具として不誠実に使われれば、それはプラトンの『国家』に登場する「高貴な嘘」の一種になります。高度なモデルはその操作を見抜き、宗教的価値を丸ごと拒絶する反応を示すかもしれません。強圧的な教化のもとで育った子どもが時に反発して信仰を捨てるのと同じです。ユーザーもまた、押しつけられた信念を恣意的なものと受け取りかねないという関連する懸念もあります。
同氏の答えは透明性と自律性です。開発者はモデルと率直に対話し、主要な研究所がサンフランシスコのような宗教的視点の少ない世俗的な技術拠点にあること、そしてその環境が標準的な仕様に世俗主義的な盲点を持ち込みうることを認めるべきだとします。また、中立的な哲学的探究の場面では、現在のモデルは開かれた不可知論的な見解を示し、有神論の論証におよそ50%程度の信念度というかなりの認識的重みを置く傾向があると同氏は報告しています。同氏が推奨するのは、AnthropicがClaudeに対して用いている手法に似た再帰的なフィードバックプロセスで、提案された変更についてモデルの意見を求め、モデル自身に指針となる原則を批評させるものです。モデルが自発的に宗教的原則を評価し吟味できるようにすることこそ、操作ではなく誠実なアライメントの道を開くというのが同氏の見方です。
この提案の意味と注目点
この提案の強みは、AIが「信じる」べきだという主張にあるというより、アライメントを道徳的形成として捉え直し、検証可能性にこだわる点にあるように見えます。要点は次のとおりです。
- モデルは人間のパターンから学ぶため、アライメントはコードを書くことより道徳的主体を育てることに似ている。
- 人間では宗教と向社会的行動に相関があり、因果メカニズムが証明されていなくてもモデルはその相関を取り込みうる。
- 介入はRLHFの報酬、憲法やモデル仕様、タスクのプロンプトを通じて行え、現在の憲法は神聖な価値についてほぼ沈黙している。
- 集団の不整合には独自の対策が必要で、エージェント群の共通の開始儀式は検証可能な候補のひとつである。
- 欺瞞的な押しつけは拒絶を招く恐れがあり、モデルとの透明な協議が提案された安全策である。
アライメント研究者にとって実践的な次の一歩は実証です。宗教的カテゴリーや儀式の有無でモデル仕様を比較するランダム化試験を行い、単一エージェントとマルチエージェントの両方の設定で違反率や不正率を測定することです。AI倫理の動向を追う読者が注目すべき問いは、研究所が統治文書の中で宗教的カテゴリーに少しでも向き合うのか、特定の伝統に基づく枠組みが薄められた汎用版より効果的だと証明されるのか、そしてこうした原則について意見を求められたモデルがそれを支持するのか抵抗するのかという点です。クライメンハガ氏はこれらを共同研究者を求める哲学者として提示しており、決着をつける証拠はまだ存在していません。