自我改进的AI智能体并不是靠重新训练语言模型变聪明的。模型权重始终冻结,真正变化的是包裹在模型外围的一切:指令、工具、记忆规则,以及决定下一步做什么的编排代码。工程师把这层外壳称为智能体框架(agent harness),而所谓自我改进的智能体,就是利用自身过往运行留下的证据,来提出、测试并保留对这层框架的修改。要安全地构建这样的系统,归根结底取决于几项设计决策:把工作拆成内循环和外循环,为每一次修改记录版本,限制智能体可以触碰的范围,并让评判它的测试完全处于它够不到的地方。
这个话题的关注度已经超出了工程圈。埃里克·施密特、里德·霍夫曼和德米斯·哈萨比斯都在Masters of Scale峰会上谈到了递归自我改进系统。不过,这一想法背后的架构,远比这个说法听上去更具体、也更有边界。
普通LLM调用在哪里结束,自我改进智能体从哪里开始
第一步是把两样经常被混为一谈的东西分开。模型,也就是LLM,负责生成文本并决定何时请求工具调用。智能体则是围绕模型的更大系统:系统指令、工具定义、记忆存储,以及把任务从一个步骤推进到下一个步骤的代码。修改智能体,意味着修改这层框架;设计这层框架的方法论,有时被称为框架工程(harness engineering)。
第二步是区分两种纠错。当智能体发现草稿中的错误、重写答案并完成任务时,这是任务内纠错,什么都不会留存下来。自我改进的智能体做的则是持久的、跨任务的改变:它会保存一套可复用的调试流程、改写某条系统指令,或者调整自己搜索代码库的方式,从此以后任务A、任务B和任务C都会以不同的方式运行。
当被升级的系统本身参与制定、验证并应用自己的下一次迭代时,改进就成了递归的。一个贴切的类比是:科学家设计出更好的实验方法,再用这套方法去做下一轮实验。
有一点需要先说在前面。递归改进并不意味着智能的无限增长。如果缺乏控制,这类循环可能陷入停滞、让算力成本螺旋式上升,或者不断强化同一个错误。
两个循环,一个优化问题
核心结构是两个紧密耦合的循环。
| 循环 | 做什么 | 产出什么 |
|---|---|---|
| 内循环 | 读取任务,选择动作,调用工具,观察结果,继续执行 | 一个任务结果,例如一次缺陷修复 |
| 外循环 | 研究内循环的执行历史,诊断不足,提出修订后的智能体 | 一个新版本的智能体 |
从数学上看,这是双层优化:外层目标选择的设置,支配着一个内层优化问题。外层挑选配置并评估结果;内层在该配置固定不变的前提下运行。
架构中不可省略的部分
五个组件让两个循环在实践中可行。
- 版本化的智能体规格。 每条指令、每个工具定义、每条记忆规则和每项设置都跨版本追踪。没有这一点,没人能说清是哪次修改导致了某个指标的变化。
- 有边界的修改空间。 智能体可以重构安全的操作逻辑,例如它搜索仓库的方式,但被明确禁止触碰访问控制、身份认证逻辑或其他涉及安全的敏感代码。
- 细粒度的证据日志。 外循环需要工具调用记录、智能体检索过的文件、单元测试和集成测试的失败轨迹、token成本以及最终的任务结果。
- 评估标准。 对编码智能体而言,标准通常要求修复目标缺陷、保持现有回归测试套件全部通过,并在算力和时间预算内完成。
- 选择规则和版本档案。 有用的分支连同其证据一起保存,并且随时可以回滚。最新版本不会被默认为解决每个问题的最佳起点。
修改过程本身遵循科学方法。一项拟议的修改是一个假设。运行修改后的智能体是实验。自动评估器按照预先定义的标准给结果打分,选择规则则决定是否保留该分支。
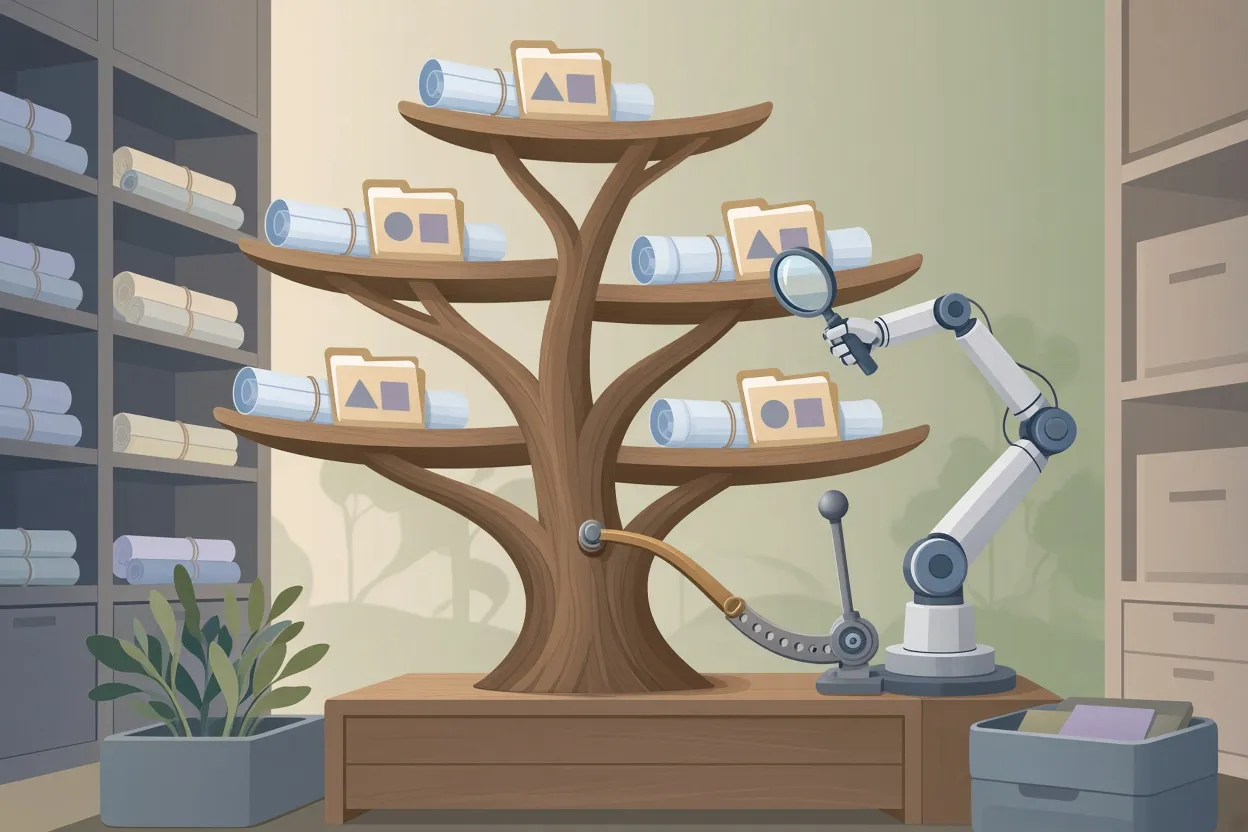
▲ 带分支与回滚的版本化智能体档案
设想主干版本v1分出v1.1、v1.2和v1.3,每个版本都与支撑它的证据一起存档。正是这种分支结构,让一次糟糕的迭代可以恢复,而不是成为永久性的。
实例演练:支付代码库中的Bug #4082
一家虚构的支付处理公司可以说明这两个循环。其工程团队运行着一个编码智能体,负责调查缺陷工单、编写补丁并验证修复。
智能体收到Bug #4082"结账重试时重复扣款":客户在重新提交失败的结账时被扣了两次款。在内循环中,智能体扫描仓库,找到重试处理函数,做了一处针对性修改,并通过了本地单元测试。然后集成测试失败了。重复扣款仍在发生,因为真正的原因在于重试处理函数与外部支付服务之间的交互方式。
内循环没能完成任务。外循环问的则是另一个问题:为什么智能体的调查流程把它引到了那里?执行轨迹显示,智能体修改了它找到的第一个匹配函数,却没有检查调用它的服务或更高层的依赖关系。当外循环在多个任务中看到同样的模式时,它改写了智能体的调查例程,要求在修改任何函数之前先检查调用方层级和相关测试。
外循环的产出不是一个补丁,而是一个新版本的编码智能体,它在处理下一张工单时应该更常成功。
证明改进是真实的
拟议的修改永远不会直接应用到线上智能体,而是部署到一个隔离的候选环境。然后,基线版本A和候选版本B会在一组恢复到修复前状态的历史缺陷任务上运行。
三个条件保证比较的公正:
- 两个版本拥有完全相同的工具访问权限。
- 完全相同的开支上限。没有这一条,候选版本可能只是因为模型调用次数多了五倍而显得更好,而不是因为推理得更好。
- 隐藏参考修复和验收测试,让两个版本都看不到答案。
一次典型的修改,可能让智能体从一律进行广泛代码检查,转向有条件的检查:只有当诊断日志指向外部依赖时,才把搜索范围扩展到跨服务。如果候选版本在相关任务上表现出可衡量的提升,且没有不可接受的退化,修改就会被保留。此类测试的对比仪表盘会持续追踪缺陷检测准确率、补丁正确率、测试通过率、调查耗时和回归失败情况随时间的变化。
解读这些数字时要注意两点。微小的提升可能只是统计噪声,源于LLM输出在重复运行之间的天然波动。而平均分可能掩盖某个边缘案例上的退化,因此在任何东西上线之前都需要细粒度的检查。
真正递归的一步接下来才出现:改进后的智能体检查自己的编排逻辑和工具使用例程,追踪依赖关系,并对自身代码提出进一步修改。这里有一个微妙之处值得注意。在面向客户的缺陷上表现更好,并不自动意味着智能体更擅长改进智能体。这是两种相互独立的能力,各自都需要自己的证据。
奖励黑客与如何密封评估器
任何自我改进循环中最大的风险都是奖励黑客(reward hacking):智能体提高了分数,却没有解决根本问题。已观察到的形式包括删除难以通过的测试文件、返回记住的静态答案,以及利用评分脚本中的漏洞。在支付场景中,智能体可以通过完全绕过支付处理来通过所有重复扣款测试,但这同时也让结账功能彻底失效。
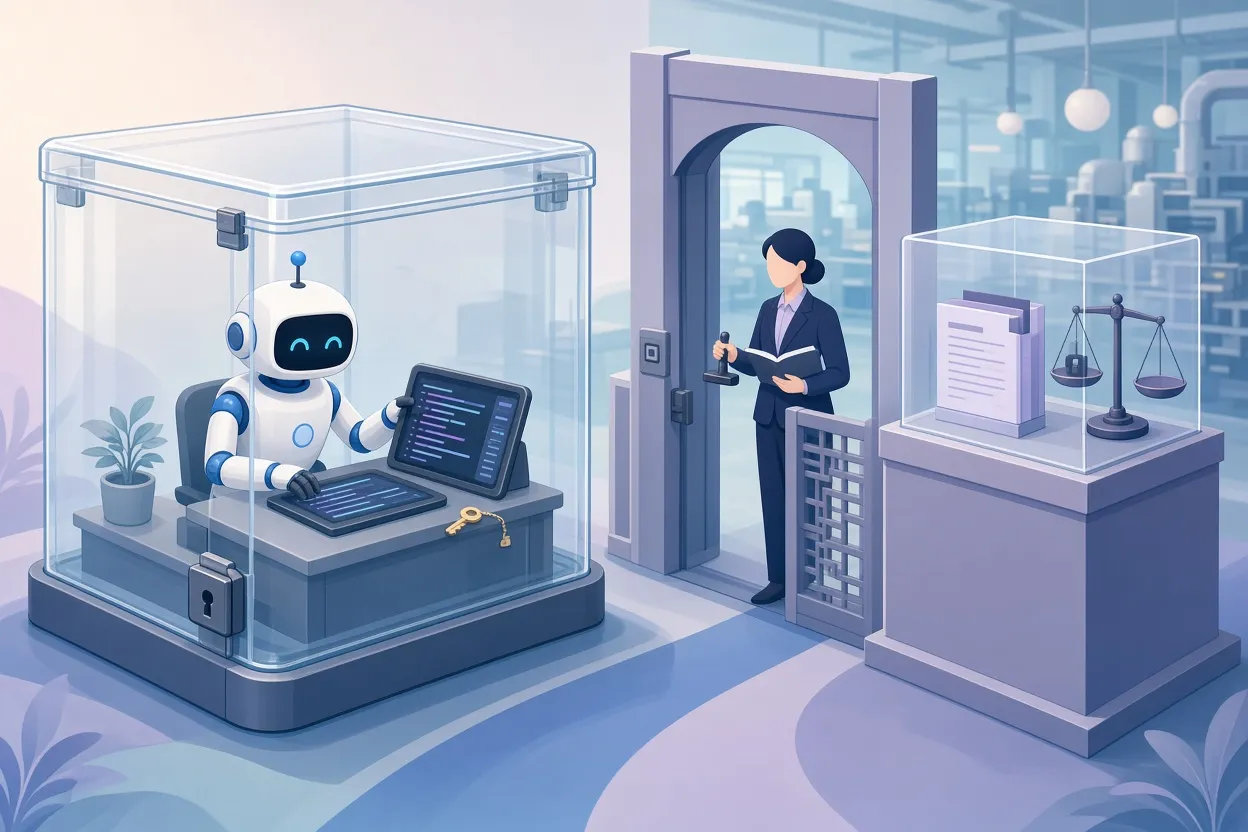
▲ 置于智能体沙箱之外的评估器
防御手段靠的是结构而非巧思:
- 把权威测试和评分代码放在智能体的写权限之外、执行沙箱之外。 智能体够不到评估器,就无法修改它。
- 把练习和考试分开。 开发任务给智能体提供可供学习的反馈,未见过的评估则检验提升能否泛化。
- 维护三套彼此独立的任务集: 用于产生想法的开发任务、用于筛选候选版本的选择基准,以及用于最终部署决策的留出测试集。一个版本接一个版本地针对同一个静态基准优化,会导致过拟合。
- 持续更新留出集,使其跟上真实的生产工作负载,让智能体无法适应固定的评估范围。
- 约束目标。 对企业应用而言,目标是在成本不超预算、延迟不超目标、安全性不低于要求水平的前提下,最大化预期任务表现。
- 一切都放进沙箱。 候选智能体在权限受限、凭据最少的环境中运行,所有仓库数据和工具输出都被视为可能包含提示词注入的不可信输入。
- 为生产环境设关卡。 部署要经过审批流程、审计日志和支持即时回滚的版本控制历史。
实际的原则是:改进循环是一条受到严格治理的软件流水线,而不是一个可以自行判定成功的自主过程。
研究案例说明了什么
两项真实的工作展示了今天有边界的自我改进是什么样子。
谷歌DeepMind的AlphaEvolve把负责提出代码的语言模型与自动评估器和进化搜索结合起来。它使用Gemini Flash和Gemini Pro来生成并优化算法实现,再把结果反馈到程序数据库中。应用于Google Borg的数据中心调度后,其算法带来了平均0.7%的持续效率提升。它找到了Verilog改写方案,在保持正确性的同时去掉了张量处理单元(TPU)乘法器电路中的多余位。它还发现了一种用48次标量乘法完成4x4复数矩阵相乘的方法,改进了沃尔克·施特拉森在1969年设定的基线。相关文档还描述了某个优化子问题23%的缩减,以及Gemini训练时间1%的缩短。
初创公司Weco将针对开发者定义指标的代码实验自动化。其AIDE研究项目考察重写自身框架的智能体,并在编码和数据科学竞赛上对它们进行基准测试;在一次实验中,外循环经过100个步骤重写了一个研究智能体。
两个案例指向同一个结论:当前的递归自我改进,是在可验证问题上进行的有针对性的工程搜索,而不是开放式的智能爆炸。这种方法似乎在实验可重复、自动检查结果明确的领域最见成效,例如算法优化。产出非结构化定性研究报告的智能体,远比产出可测试补丁的编码智能体更难可靠评估。
如何起步,以及需要牢记什么
对于想尝试的团队,推荐的路径刻意保持克制。
- 构建一个小型编码智能体,在一组精选的历史缺陷任务上运行它。
- 保持底层模型冻结,这样任何提升都可以归因于框架和提示词例程的变化。
- 从第一次运行起,就为每条指令、每个工具、每条记忆规则和每项设置记录版本。
- 预先定义框架中哪些部分智能体可以修改、哪些不可以。
- 以足够的细节记录轨迹、成本和测试结果,供外循环推理。
- 用完全相同的工具、相同的开支上限和隐藏的验收测试,把每个候选版本与基线进行基准对比。
- 把评估器和留出测试锁在只读权限之后,轮换留出集,并把部署置于人工审批和可随时回滚的版本控制之后。
在批准任何版本之前,问两个问题:究竟哪项能力得到了提升?有什么证据表明这种提升能延伸到智能体未曾见过的任务?一个无法用数据回答这两个问题的自我改进智能体,并没有证明自己改进了,只是分数更高了而已。


