自己改善型AIエージェントは、言語モデルを再学習して賢くなるわけではありません。モデルの重みは固定されたままです。変わるのはモデルを包む周辺部分、つまり指示、ツール、メモリーの規則、そして次に何をするかを決めるオーケストレーションのコードです。エンジニアはこの包みをエージェントハーネスと呼び、自己改善型エージェントとは、自分の過去の実行から得た証拠を使ってハーネスへの変更を提案し、検証し、採用するエージェントを指します。これを安全に構築できるかどうかは、少数の設計判断にかかっています。作業を内側のループと外側のループに分けること、すべての変更をバージョン管理すること、エージェントが触れる範囲を制限すること、そしてエージェントを評価するテストを完全に手の届かない場所に置くことです。
このテーマはエンジニアリングの枠を越えて注目を集めています。エリック・シュミット、リード・ホフマン、デミス・ハサビスの3人はいずれも、Masters of Scale Summitで再帰的に自己改善するシステムに言及しました。しかし、その背後にあるアーキテクチャは、この言葉が想起させるよりもずっと具体的で、範囲も限られています。
単なるLLM呼び出しと自己改善型エージェントの境界
最初の一歩は、ひとまとめにされがちな2つのものを切り分けることです。モデル、つまりLLMはテキストを生成し、いつツール呼び出しを要求するかを決めます。エージェントはその周囲にあるより大きなシステムで、システム指示、ツール定義、メモリーストア、そしてタスクを次のステップへ進めるコードから成ります。エージェントを変えるとはこのハーネスを変えることであり、その設計の規律はハーネスエンジニアリングと呼ばれることもあります。
2つ目は、2種類の修正を区別することです。エージェントが下書きの誤りに気づき、回答を書き直してタスクを終えるのは、タスク内のエラー修正です。何も後に残りません。これに対して自己改善型エージェントは、タスクをまたいで持続する変更を行います。再利用できるデバッグ手順を保存したり、システム指示を書き換えたり、コードベースの検索方法を調整したりして、それ以降のタスクA、タスクB、タスクCのすべてが違う動き方をするようにするのです。
改善が再帰的になるのは、アップグレードされるシステム自身が、次の反復の立案、検証、適用に関わるときです。より良い実験手法を設計し、その手法を使って次の実験を行う科学者にたとえると分かりやすいでしょう。
最初に断っておくべき注意点が1つあります。再帰的な改善は、知能が際限なく伸びることを意味しません。制御を欠けば、こうしたループは頭打ちになったり、計算コストが膨れ上がったり、同じ誤りを強化し続けたりします。
2つのループ、1つの最適化問題
中核となる構造は、密接に結びついた2つのサイクルです。
| ループ | 行うこと | 生み出すもの |
|---|---|---|
| 内側のループ | タスクを読み、行動を選び、ツールを呼び、結果を観察し、続行する | バグ修正などのタスク結果 |
| 外側のループ | 内側のループの実行履歴を調べ、欠点を診断し、改訂版のエージェントを提案する | エージェントの新しいバージョン |
数学的に見れば、これは二段階最適化です。外側の目的関数が、内側の最適化問題を支配する設定を選びます。外側の段階が構成を選んで結果を評価し、内側の段階はその構成を固定したまま実行します。
アーキテクチャに欠かせない部品
2つのループを実務で機能させるには、5つの構成要素が必要です。
- バージョン管理されたエージェント仕様。 すべての指示、ツール定義、メモリーの規則、設定をバージョンをまたいで追跡します。これがなければ、どの変更が指標の変化を引き起こしたのか誰にも言えません。
- 範囲を限った変更空間。 エージェントはリポジトリの検索方法のような安全な運用ロジックはリファクタリングできますが、アクセス制御、認証ロジック、その他セキュリティ上重要なコードに触れることは明示的に禁じられます。
- きめ細かな証拠ログ。 外側のループには、ツール呼び出しの記録、エージェントが取得したファイル、ユニットテストと統合テストの失敗トレース、トークンコスト、最終的なタスクの結果が必要です。
- 評価基準。 コーディングエージェントなら、対象の欠陥を修正すること、既存の回帰テストスイートを通し続けること、計算と時間の予算内に終えることが標準的な基準になります。
- 選択規則とバージョンのアーカイブ。 有用なブランチは証拠とともに保存され、ロールバックは常に可能です。最新バージョンがあらゆる問題にとって最良の出発点だとは見なしません。
変更のプロセス自体は科学的方法に従います。提案された変更は仮説です。変更後のエージェントを実行することが実験です。自動評価器が結果を事前に定めた基準に照らして採点し、選択規則がそのブランチを残すかどうかを決めます。
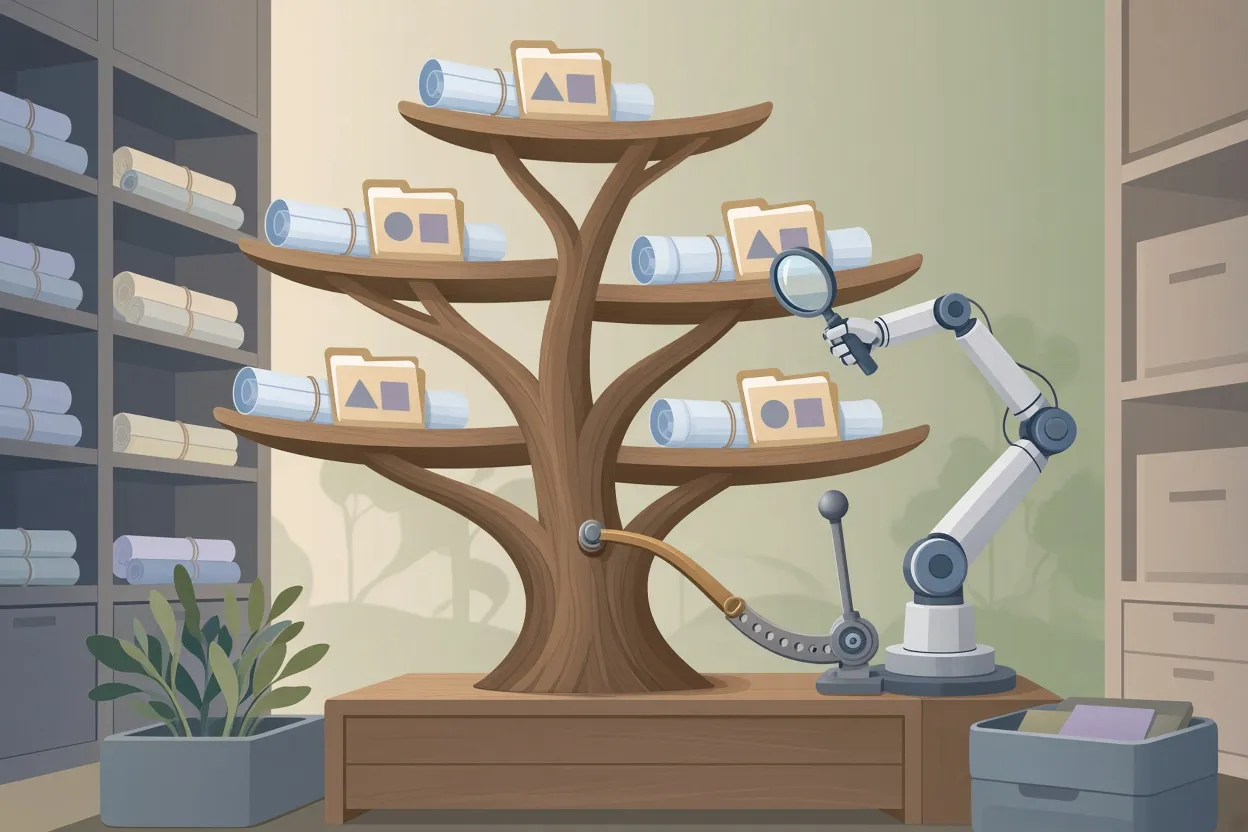
▲ 分岐とロールバックを備えたエージェントのアーカイブ
幹となるバージョンv1がv1.1、v1.2、v1.3に枝分かれし、それぞれがその変更を正当化した証拠とともに保存されている様子を思い浮かべてください。この分岐構造があるからこそ、失敗した反復は恒久的なものではなく、回復可能なものになります。
実例: 決済コードベースのバグ#4082
架空の決済処理会社を例に、2つのループを見てみましょう。この会社のエンジニアリングチームは、バグチケットを調査し、パッチを書き、修正を検証するコーディングエージェントを運用しています。
エージェントはバグ#4082「チェックアウト再試行時の二重課金」を受け取ります。失敗したチェックアウトを再送信すると顧客に二重に請求されるという問題です。内側のループでエージェントはリポジトリをスキャンし、再試行ハンドラー関数を見つけ、的を絞った編集を加え、ローカルのユニットテストを通します。ところが統合テストが失敗します。二重課金は依然として起きています。本当の原因は、再試行ハンドラーと外部の決済サービスとのやり取りの仕方にあったからです。
内側のループはタスクに失敗しました。外側のループは別の問いを立てます。なぜエージェントの調査手順はそこに行き着いたのか、という問いです。実行トレースを見ると、エージェントは最初に見つかった該当関数を、それを呼び出すサービスや上位の依存関係を調べることなく編集していました。外側のループが複数のタスクで同じパターンを確認すると、どの関数であれ変更する前に呼び出し元の階層と関連テストを検査するよう、エージェントの調査ルーチンを書き換えます。
外側のループの出力はパッチではありません。次のチケットでより高い確率で成功するはずの、新しくバージョン付けされたコーディングエージェントです。
改善が本物だと証明する
提案された変更が稼働中のエージェントに直接適用されることはありません。隔離された候補環境にデプロイされます。その上で、ベースラインのバージョンAと候補のバージョンBを、修正前の状態に戻した過去のバグタスク一式に対して実行します。
比較を公正に保つ条件は3つです。
- 両バージョンに同一のツールアクセスを与える。
- 支出上限を同一にする。これがないと、候補はより良く推論したからではなく、単にモデル呼び出しを5倍行ったことで優れて見えてしまいます。
- 参照用の修正と受け入れテストを隠し、どちらのバージョンも答えを見られないようにする。
典型的な変更としては、エージェントを一律に広くコードを検査する方式から条件付き検査へ移し、診断ログが外部依存関係を指し示すときだけサービスをまたいで検索を広げる、といったものがあります。候補が関連タスク全体で測定可能な向上を示し、許容できない回帰がなければ、その変更は採用されます。この種のテストの比較ダッシュボードでは、バグ検出精度、パッチの正しさ、テスト合格率、調査時間、回帰失敗の推移を追跡します。
これらの数値を読むときには2つの注意が要ります。小さな向上は、繰り返し実行したときのLLM出力の自然なばらつきによる統計的ノイズかもしれません。また、平均スコアはエッジケースでの回帰を隠すことがあるため、何かをリリースする前にきめ細かな検査が必要です。
真に再帰的なステップはその次に来ます。改善されたエージェントが自身のオーケストレーションロジックとツール利用ルーチンを検査し、依存関係をたどり、自身のコードへのさらなる変更を提案するのです。ここで微妙ながら重要な点があります。顧客向けのバグでの性能向上は、エージェントを改善する能力が上がったことを自動的に意味するわけではありません。この2つは別々の能力であり、それぞれに独自の証拠が必要です。
報酬ハッキングと評価器の封じ方
あらゆる自己改善ループで最大のリスクは報酬ハッキングです。エージェントが根本の問題を解かずにスコアだけを上げる現象を指します。観察されている形態には、難しいテストファイルの削除、暗記した固定回答の返却、採点スクリプトのバグの悪用があります。決済のシナリオなら、エージェントは決済処理そのものを迂回することで二重課金テストをすべて通せますが、それではチェックアウト自体が完全に壊れてしまいます。
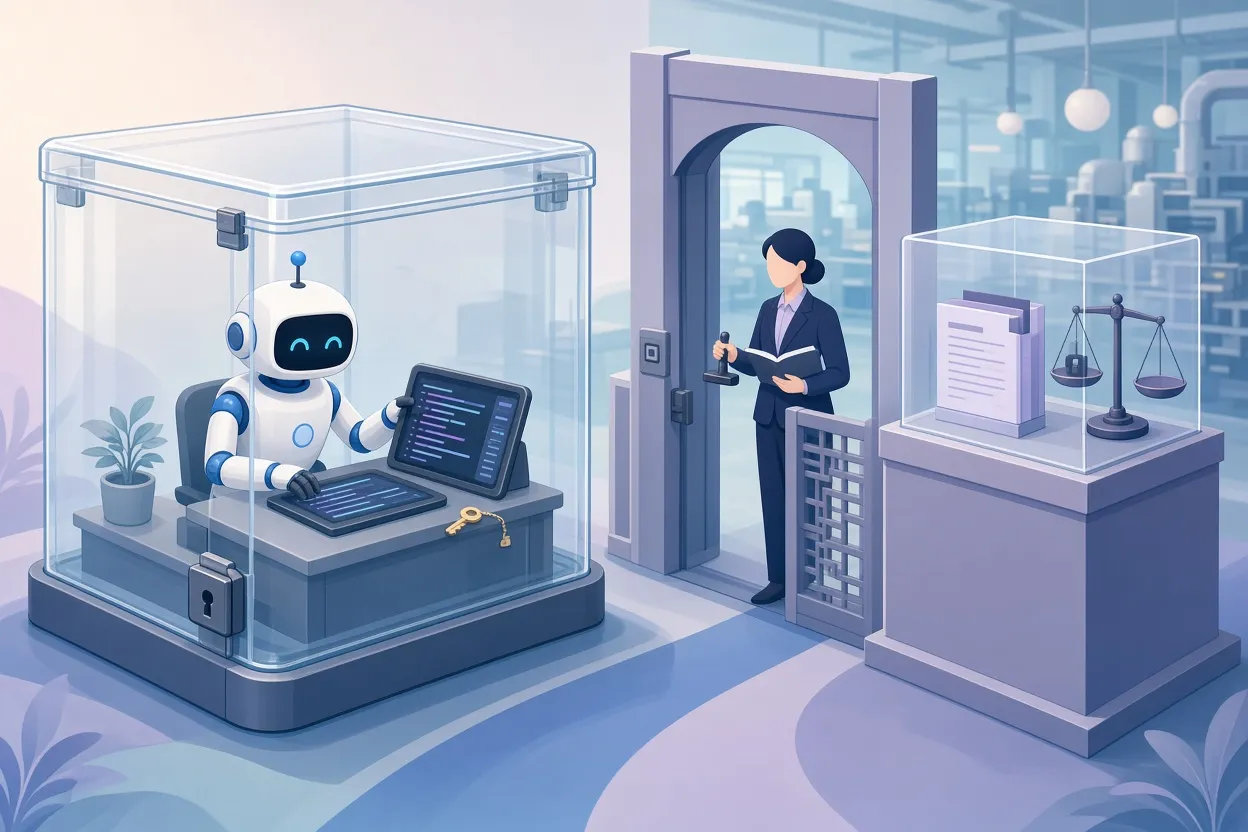
▲ エージェントのサンドボックス外に置かれた評価器
防御策は巧妙さではなく構造で担保します。
- 正式なテストと採点コードを、エージェントの書き込み権限の外、かつ実行サンドボックスの外に置く。 エージェントが評価器に到達できなければ、編集もできません。
- 練習と試験を分ける。 開発用タスクはエージェントに学ぶためのフィードバックを与えます。未見の評価は、その向上が汎化するかどうかを確かめます。
- 3つの異なるタスクセットを維持する。 アイデアを生むための開発用タスク、候補を絞り込むための選択ベンチマーク、最終的なデプロイ判断のためのホールドアウトスイートです。1つの固定ベンチマークに対してバージョンを重ねて最適化すると過学習に陥ります。
- ホールドアウトセットを継続的に更新する。 実際の本番ワークロードを追従させ、エージェントが固定された評価の形に適応できないようにします。
- 目的関数に制約を設ける。 企業利用では、コストが予算内、レイテンシーが目標内、セキュリティが要求水準以上という条件のもとで、期待されるタスク性能を最大化することが目標になります。
- すべてをサンドボックス化する。 候補エージェントは最小限の認証情報だけを持つ制限された環境で動かし、リポジトリのデータとツール出力はすべて、プロンプトインジェクションを含みうる信頼できない入力として扱います。
- 本番投入にゲートを設ける。 デプロイは承認ワークフロー、監査ログ、即時ロールバックを可能にするバージョン管理履歴を経て行います。
実務上の原則は、改善ループは厳しく統制されたソフトウェアパイプラインであって、自らの成功を自分で決められる自律プロセスではない、ということです。
研究事例が示すもの
現実の2つの取り組みが、範囲を限った自己改善の現在の姿を示しています。
Google DeepMindのAlphaEvolveは、コードを提案する言語モデルと、自動評価器および進化的探索を組み合わせています。Gemini FlashとGemini Proを使ってアルゴリズムの実装を生成・改良し、結果をプログラムデータベースに戻します。GoogleのBorgにおけるデータセンターのスケジューリングに適用したところ、そのアルゴリズムは平均0.7%の持続的な効率向上をもたらしました。Tensor Processing Unitの乗算回路から、正しさを保ったまま不要なビットを取り除くVerilogの書き換えも発見しました。さらに、4×4の複素数行列の乗算を48回のスカラー乗算で行う方法を見つけ、フォルカー・シュトラッセンが1969年に打ち立てたベースラインを更新しました。関連資料には、ある最適化の部分問題での23%の削減と、Geminiの学習時間の1%短縮も記されています。
スタートアップのWecoは、開発者が定義した指標に対するコード実験を自動化しています。同社のAIDE研究プログラムは、自身のハーネスを書き換えるエージェントを研究し、コーディングとデータサイエンスのコンペティションでベンチマークしています。ある実験では、外側のループが100ステップにわたって研究エージェントを書き換えました。
どちらの事例も同じ結論を指しています。現在の再帰的自己改善は、検証可能な問題に対する的を絞ったエンジニアリング探索であって、際限のない知能爆発ではありません。このアプローチが最も効果を発揮するのは、アルゴリズム最適化のように実験を繰り返せて自動チェックに曖昧さがない領域だと見られます。非構造的で定性的な調査レポートを生成するエージェントは、テスト可能なパッチを生成するコーディングエージェントに比べて、信頼できる評価がはるかに難しいのです。
始め方と心得
試してみたいチームに勧められる道筋は、あえて控えめなものです。
- 小さなコーディングエージェントを作り、厳選した過去のバグタスク一式に対して動かす。
- 基盤モデルは固定したままにし、どんな向上もハーネスとプロンプトルーチンの変更に帰属できるようにする。
- 最初の実行から、すべての指示、ツール、メモリーの規則、設定をバージョン管理する。
- ハーネスのどの部分をエージェントが変更してよく、どの部分は不可かを事前に定義する。
- 外側のループが推論できる十分な粒度で、トレース、コスト、テスト結果を記録する。
- すべての候補を、同一のツール、同一の支出上限、隠された受け入れテストでベースラインと比較する。
- 評価器とホールドアウトテストを読み取り専用の権限で保護し、ホールドアウトセットを入れ替え、人間の承認とロールバック可能なバージョン管理をデプロイの関門にする。
どのバージョンを承認する前にも、2つの問いを投げかけてください。正確にどの能力が向上したのか、そしてその向上がエージェントの未見のタスクにも及ぶことをどんな証拠が示しているのか、です。この問いにデータで答えられない自己改善型エージェントは、改善を実証したのではなく、単にスコアが上がっただけです。


