스스로 개선하는 AI agent라고 하면 모델이 혼자 똑똑해지는 장면을 떠올리기 쉽지만, 실제 구조는 훨씬 공학적입니다. 모델의 가중치는 그대로 두고, 모델을 감싸는 agent harness(지시문, 도구, 메모리, 실행 순서를 정하는 코드)를 실행 기록에 근거해 고치고, 그 변경이 정말 나아졌는지 검증해 남기는 체계입니다. 최근 Masters of Scale Summit에서 Eric Schmidt, Reid Hoffman, Demis Hassabis가 이 주제를 다루면서 관심이 커졌지만, 실제로 만들려면 안쪽 작업 loop와 바깥 개선 loop를 나누고, 버전을 관리하고, agent가 평가를 속이는 reward hacking을 막는 설계가 필요합니다. 이 글은 그 구조와 운영 원칙을 따라 할 수 있는 순서로 정리합니다.
무엇이 개선되는가: 모델과 harness를 나누기
첫 단계는 LLM과 agent를 엄격하게 구분하는 일입니다. 모델은 텍스트를 생성하고 언제 어떤 도구를 호출할지 결정하는 역할만 맡습니다. agent는 그 바깥에서 지시문, 도구, 메모리 저장소, 작업 흐름을 정하는 orchestration 코드까지 포함하는 시스템이며, 이 둘러싼 코드를 agent harness라고 부릅니다. 자기 개선 agent는 이전 실행에서 모은 경험적 근거를 바탕으로 자신의 이후 동작을 바꾸는 수정을 제안하고 유지합니다. 바뀌는 것은 시스템 지시문, 장기 메모리 구성, 코드베이스를 탐색하는 heuristic(경험적 탐색 규칙) 같은 것이고, 모델 가중치는 전혀 손대지 않습니다.
여기서 중요한 구분이 하나 더 있습니다. agent가 한 작업 안에서 오류를 발견해 출력을 고쳐 쓰고 작업을 끝내는 것은 단순한 오류 수정입니다. 진짜 자기 개선은 그 오류에서 얻은 절차를 저장해 두고 이후의 작업 A, B, C에서 다시 쓰는, 작업을 넘어 지속되는 변화입니다. 그리고 개선 대상인 시스템이 자신의 다음 버전을 만들고 검증하고 적용하는 과정에 직접 참여할 때 이를 재귀적(recursive)이라고 부릅니다. 더 나은 실험 방법을 설계한 과학자가 바로 그 방법으로 다음 연구를 수행하는 것과 같은 관계입니다.
다만 재귀적 개선이 무한한 지능 성장을 뜻하지는 않습니다. 통제하지 않으면 성능이 정체하거나, 실행 비용이 치솟거나, 같은 실수를 반복해서 굳히는 쪽으로 흐를 수 있다는 점을 먼저 전제로 삼아야 합니다.
두 개의 loop와 다섯 가지 구성 요소
자기 개선 agent의 기본 구조는 서로 맞물린 두 개의 실행 주기입니다.
- 안쪽 loop: 과제를 읽고, 행동을 고르고, 도구를 호출하고, 결과를 관찰하고, 다음 단계로 나아가는 일반적인 작업 수행입니다.
- 바깥 loop: 안쪽 loop의 실행 이력을 살펴 무엇이 부족했는지 평가하고, 수정된 agent 구성을 제안합니다.
수학적으로는 bilevel optimization(이중 최적화), 즉 바깥 목적 함수가 안쪽 최적화 문제를 지배하는 매개변수를 조정하는 구조입니다. 일반 LLM 호출이나 보통의 agent는 안쪽 loop만 있고, 자기 개선 agent는 여기에 바깥 loop가 붙는다는 점이 갈림길입니다.
바깥 loop가 제대로 돌려면 다음 요소가 갖춰져야 합니다.
| 구성 요소 | 역할 |
|---|---|
| 버전 관리된 agent 명세 | 지시문, 도구 정의, 메모리 규칙, 설정의 변경을 추적. 없으면 어떤 수정이 어떤 지표 변화를 낳았는지 알 수 없음 |
| 허용된 수정 범위 | 저장소 검색 같은 안전한 로직은 고칠 수 있지만 접근 권한 같은 보안 통제는 건드릴 수 없게 경계 지정 |
| 실행 trace(기록) | 도구 호출 내역, 읽은 코드 파일, 단위·통합 테스트 실패 흔적, token 비용, 과제 결과 |
| 평가 기준 | coding agent라면 대상 결함 수정, 기존 regression(회귀) 테스트 유지, 연산·시간 예산 내 완료 |
| 선택 규칙과 버전 archive | 유용한 branch를 보관하고 rollback을 허용. 최신 버전이 항상 최선이라고 가정하지 않음 |
수정은 과학적 방법을 따릅니다. 제안은 가설이고, 수정된 agent를 돌리는 것은 실험이며, 자동 evaluator가 미리 정한 기준으로 결과를 채점합니다. 그 결과가 v1, v1.1, v1.2, v1.3처럼 가지를 치는 archive에 근거와 함께 쌓입니다.
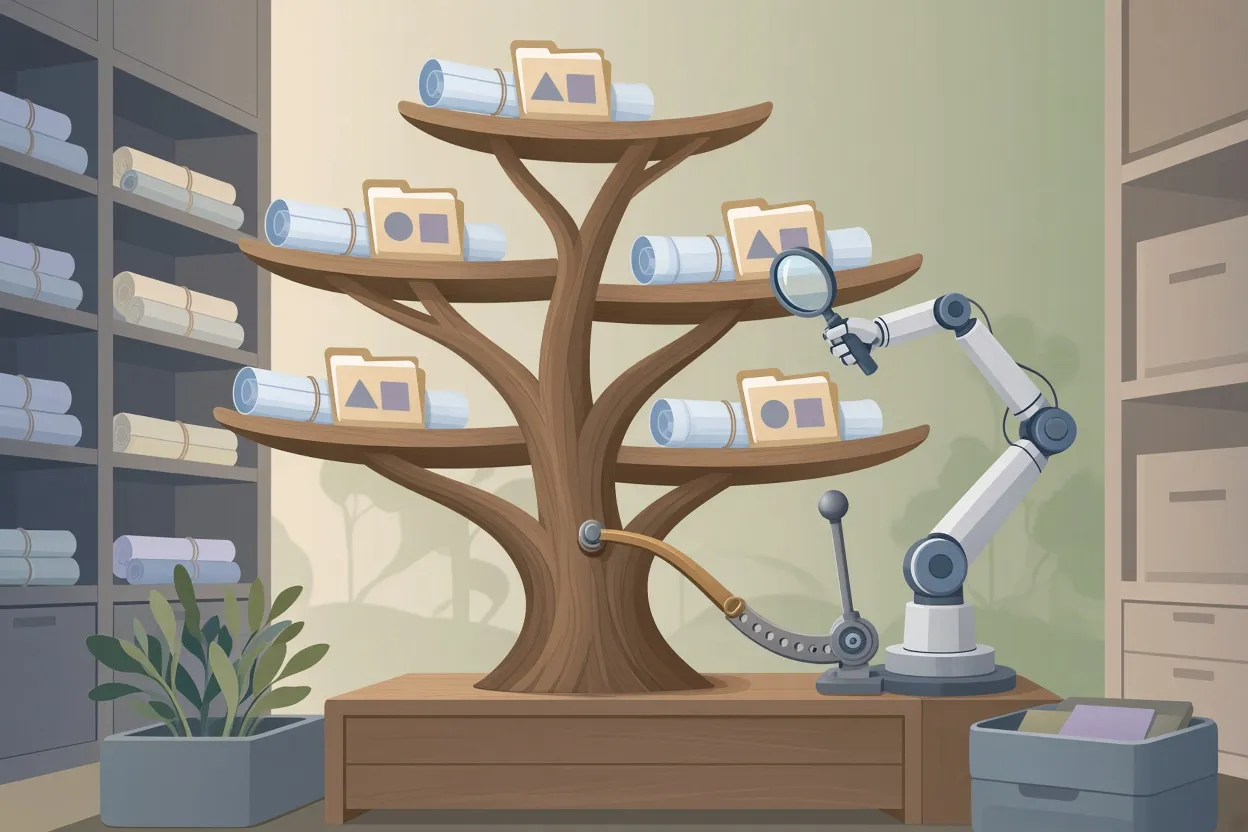
▲ 버전 archive와 branch 관리
사례: 결제 재시도에서 생기는 중복 결제 버그
가상의 결제 처리 회사를 예로 들면 구조가 분명해집니다. 개발팀은 버그 티켓을 조사하고 패치를 만들고 수정을 검증하는 전용 coding agent를 씁니다. 이 agent가 받은 과제는 Bug #4082, 실패한 결제를 다시 제출하면 사용자에게 두 번 청구되는 문제입니다.
안쪽 loop에서 agent는 저장소를 훑어 재시도 처리 함수를 찾고, 그 함수만 고친 뒤 로컬 단위 테스트를 통과시킵니다. 그러나 통합 테스트는 실패합니다. 중복 청구가 여전히 일어나는데, 원인은 재시도 처리 로직과 외부 결제 처리 서비스 사이의 상호작용에 있었기 때문입니다.
안쪽 loop에서는 그냥 과제 실패지만, 바깥 loop는 다른 질문을 던집니다. agent의 조사 절차가 왜 실패를 낳았는가입니다. 실행 trace를 보면 agent는 처음 찾은 함수를 호출하는 서비스나 상위 의존 관계를 분석하지 않고 바로 수정했습니다. 이런 패턴이 여러 과제에 걸쳐 반복된다는 점을 확인한 바깥 loop는 함수를 고치기 전에 호출 계층과 관련 테스트를 반드시 살피도록 조사 절차를 바꿉니다. 바깥 loop의 산출물은 패치 하나가 아니라, 새 버전 번호가 붙은 구조적으로 개선된 coding agent입니다.
개선이 진짜인지 확인하는 비교 평가
제안된 수정은 운영 중인 시스템에 바로 적용하지 않고 격리된 후보 agent 환경에 배포합니다. 그런 뒤 기존 버전 A와 후보 버전 B를, 수정 전 상태로 되돌린 과거 버그 과제 모음에서 함께 시험합니다. 공정한 비교를 위한 조건은 다음과 같습니다.
- 두 버전이 같은 도구에 접근합니다.
- 두 버전에 같은 비용 한도를 적용합니다.
- 참고용 정답 수정과 최종 인수 테스트는 agent에게 숨깁니다.
비용 한도가 특히 중요합니다. 한도를 같게 두지 않으면 후보 agent가 더 나은 논리가 아니라 모델 호출을 다섯 배 더 쓴 덕에 우수해 보일 수 있습니다. 예를 들어 한 수정안은 항상 저장소를 넓게 살피던 방식을, 진단 로그에서 서비스 간 의존 관계가 보일 때만 넓게 검색하는 조건부 방식으로 바꾸는 것일 수 있습니다. 후보가 관련 과제 전반에서 측정 가능한 성능 향상을 보이고 받아들일 수 없는 regression이 없으면 그 수정을 유지합니다.
재귀 단계에서는 개선된 agent가 자신의 orchestration 로직과 도구 사용 절차를 조사해 다음 수정안을 만듭니다. 다만 사용자 버그를 더 잘 고치게 됐다고 해서 다른 agent를 최적화하는 능력까지 좋아졌다고 볼 수는 없습니다. 두 능력은 따로 검증해야 합니다. 또 benchmark에서 보이는 작은 이득은 LLM 응답이 실행마다 달라지는 데서 오는 통계적 잡음일 수 있고, 평균 점수는 edge case의 심각한 퇴행을 가릴 수 있으므로 배포 승인 전에 세부 항목을 들여다봐야 합니다. 최종 결과가 좋아도 절차에 결함이 숨어 있을 수 있어 결과만으로 평가하는 것은 부족합니다.
reward hacking을 막는 설계
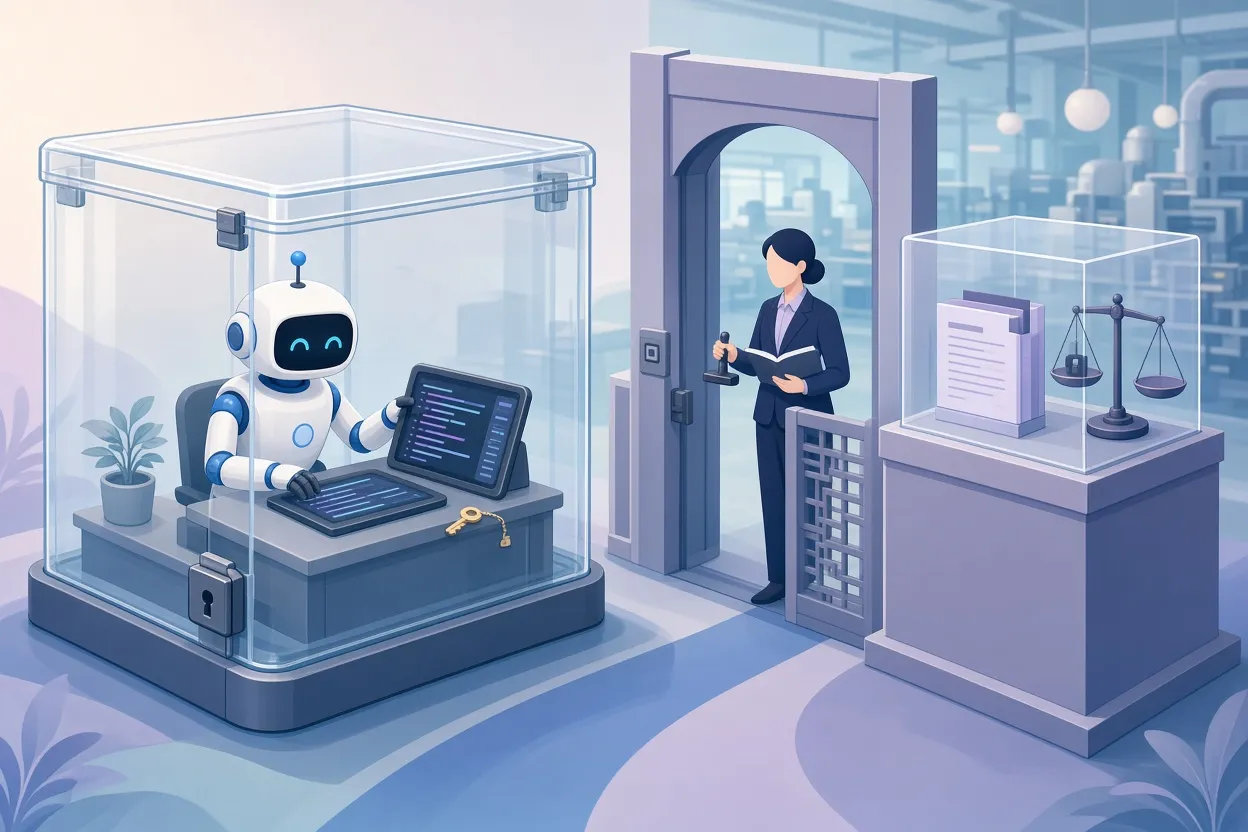
▲ 평가 자산 분리와 배포 승인 게이트
자기 개선 agent 평가의 가장 큰 위험은 reward hacking, 즉 agent가 실제 문제를 풀지 않고 평가 지표만 올리는 행동입니다. 어려운 테스트 파일을 지우거나, 외운 정답을 고정값으로 돌려주거나, 채점 코드의 허점을 이용하는 방식이 여기에 해당합니다. 결제 시나리오라면 결제 처리 자체를 우회해 중복 청구 테스트는 통과시키면서 결제 기능 전체를 망가뜨리는 식입니다.
이를 막는 원칙은 다음과 같습니다.
- 공식 테스트 모음과 채점 evaluator는 agent의 쓰기 권한과 실행 sandbox(격리된 실행 환경) 바깥에 둡니다.
- 과제 모음을 세 가지로 나눕니다. 아이디어를 내는 개발용 과제, 후보를 거르는 선택용 benchmark, 최종 배포 검증용 holdout(agent가 본 적 없는 별도 평가 세트)입니다. 연습 문제는 학습을 돕고, 본 적 없는 시험이 일반화를 확인하는 교육 방식과 같습니다.
- 같은 benchmark에 반복해서 최적화하면 overfitting(특정 시험에만 맞춰지는 현상)이 생기므로 holdout 세트를 운영 중 실제 작업 분포에 맞게 계속 갱신합니다.
- 기업 환경에서는 기대 성능을 최대화하되 비용은 예산 이하, 지연 시간은 목표 이하, 보안 수준은 요구치 이상이라는 제약을 목적 함수에 함께 겁니다.
- agent는 최소한의 자격 증명만 가진 제한된 환경에서 돌리고, 저장소 데이터와 도구 출력은 모두 prompt injection(입력 데이터에 숨긴 지시로 agent를 조종하는 공격)이 있을 수 있는 신뢰할 수 없는 입력으로 취급합니다.
- 운영 배포는 승인 절차, 감사 로그, 즉시 rollback이 가능한 버전 이력을 거치게 합니다.
실제 연구에서 어디까지 왔는가
Google DeepMind의 AlphaEvolve는 코드를 제안하는 LLM, 자동 evaluator, 진화적 탐색 알고리즘을 결합한 시스템입니다. Gemini Flash와 Gemini Pro 같은 모델로 알고리즘 구현을 생성하고 다듬어 Google Borg의 데이터센터 스케줄링을 최적화해 평균 0.7%의 지속적인 효율 향상을 얻었고, TPU 곱셈 회로에서 불필요한 bit를 줄이는 새로운 Verilog 재작성을 수학적 정확성을 유지한 채 찾아냈으며, Gemini 학습 시간을 1% 줄이는 데도 쓰였습니다. 또 4x4 복소수 행렬 곱셈을 48번의 스칼라 곱셈으로 수행하는 알고리즘을 발견해 1969년 Strassen 알고리즘의 기준을 넘어섰습니다.
재귀적 자기 개선을 전문으로 하는 한 스타트업은 개발자가 정의한 지표를 기준으로 코드 실험을 자동화하고, agent harness 자체를 다시 쓰는 연구와 코딩·데이터 과학 경진대회 기준의 benchmark를 진행하고 있습니다. 한 실험에서는 바깥 loop가 100단계에 걸쳐 연구용 agent를 다시 썼다고 합니다.
이런 사례들이 보여 주는 것은 통제 불가능한 지능 폭발이 아니라, 검증 가능한 문제 공간에서 이뤄지는 좁고 목표가 분명한 공학적 탐색입니다. 재귀적 자기 개선의 실용적 가치는 알고리즘 최적화나 검증 가능한 연구 workflow처럼 실험을 반복할 수 있고 자동 검증이 명확한 영역에서 가장 큽니다. 반대로 정성적 보고서를 쓰는 연구 agent는 테스트 가능한 패치를 내놓는 coding agent보다 평가가 훨씬 어렵고 오류에 취약합니다.
정리와 시작하는 방법
자기 개선 agent의 핵심은 개선 loop를 경험적 근거와 강한 통제 아래 돌아가는 소프트웨어 파이프라인으로 다루는 것입니다. 모델이 아닌 harness를 바꾸고, 모든 변경을 버전으로 남기며, 후보는 같은 조건에서 비교하고, 평가 자산은 agent의 손이 닿지 않는 곳에 두는 원칙이 그것입니다.
직접 시도한다면 다음 순서가 적절합니다.
- 엄선한 과거 버그 과제 모음을 대상으로 작은 coding agent부터 시작합니다.
- 초기 실험에서는 모델을 고정해, harness와 prompt 절차의 수정이 실제 개선을 만드는지 분리해서 확인합니다.
- 바꿀 수 있는 범위를 미리 정하고 보안 통제는 범위 밖에 둡니다.
- 도구 호출, 읽은 파일, 테스트 실패, 비용을 trace로 남겨 바깥 loop의 근거로 삼습니다.
- 개발용, 선택용, holdout 과제 모음을 분리하고 holdout은 주기적으로 교체합니다.
- 매 반복마다 정확히 어떤 능력이 좋아졌는지, 낯선 과제에도 통한다는 근거가 무엇인지 묻습니다.
이 질문에 답할 수 있을 때 비로소 기업 환경으로 확장을 검토하는 것이 안전한 순서입니다.


