在再造一个AI智能体之前,或许值得先问一问:一个整理得当的文件夹能否完成同样的工作。让通用AI“给我的投资人做一份幻灯片”,它并不知道你是谁、你喜欢怎样制作演示文稿,也不知道你的投资人是谁。过去两三年,标准的解决办法是为每项任务单独打造一个智能体,并把它接入数据库、连接器和导出工具。一种更简单的模式把这套做法反了过来:把指令、偏好和参考数据保存在文件夹里的纯文本文件中,给一个AI模型配上几个基本工具,让它按每次请求读取所需的内容。
一句话请求缺了什么
把这条投资人演示文稿请求拆开来看,会发现三处空白。每一处都对应一个可以创建的文件夹。
| 请求的部分 | AI需要知道什么 | 存放位置 |
|---|---|---|
| “给我做” | 你是谁:品牌语气、所在地、工作经历 | “Me”文件夹 |
| “一份幻灯片” | 你希望怎样做演示文稿:版式、规则、图片素材 | “Build”文件夹 |
| “给我的投资人” | 投资人是谁:背景笔记、网站链接 | “Me”中的“Investors”子文件夹 |
开箱即用的模型对这些一无所知。没有数据、上下文和工具同时到位,输出往往流于泛泛,甚至干脆是错的。两三年前,在没有任何支撑结构的情况下发出这条请求,得到的正是这种平淡而无用的结果。
智能体方案如何变得复杂
传统做法是一项任务一项任务地给模型外围加上定制部件:
- 访问私有数据。 模型没有用个人或公司的私有数据训练过,因此开发者把它连接到SQL数据库、Google Drive、SharePoint,或者JSON和YAML存储库。
- API网关和连接器。 要访问这些数据,就得搭建一个规定查询语法和参数的API网关,再用Python或C#编写连接模型与数据库的连接器代码。
- 文档工具。 制作幻灯片需要一个能操作PowerPoint的工具。由于AI模型难以直接控制演示软件,早期Microsoft Copilot生成的演示文稿质量似乎非常差。常见的变通办法是让AI用HTML写出幻灯片再用脚本转换,或者渲染网页、截图后把图片贴到幻灯片上。
- 网页爬虫。 调研投资人需要用Python或C#编写定制爬虫(从网页上抓取信息的程序),并加入错误处理,确保找到的是正确的人。随后智能体会把抓取的数据与内部数据库交叉核对,再生成演示文稿。
微调,也就是用特定数据对模型做进一步训练,是另一种选择。而在请求发出时通过数据管道把数据送进去,往往要可靠得多。
更深层的弱点在于脆弱。把“幻灯片”换成“PDF”,为幻灯片打造的智能体就无法完成任务,必须有人再造一个带PDF管道的智能体。这种情况在公司里一再重复,最后就要维护几十个用途狭窄的智能体。
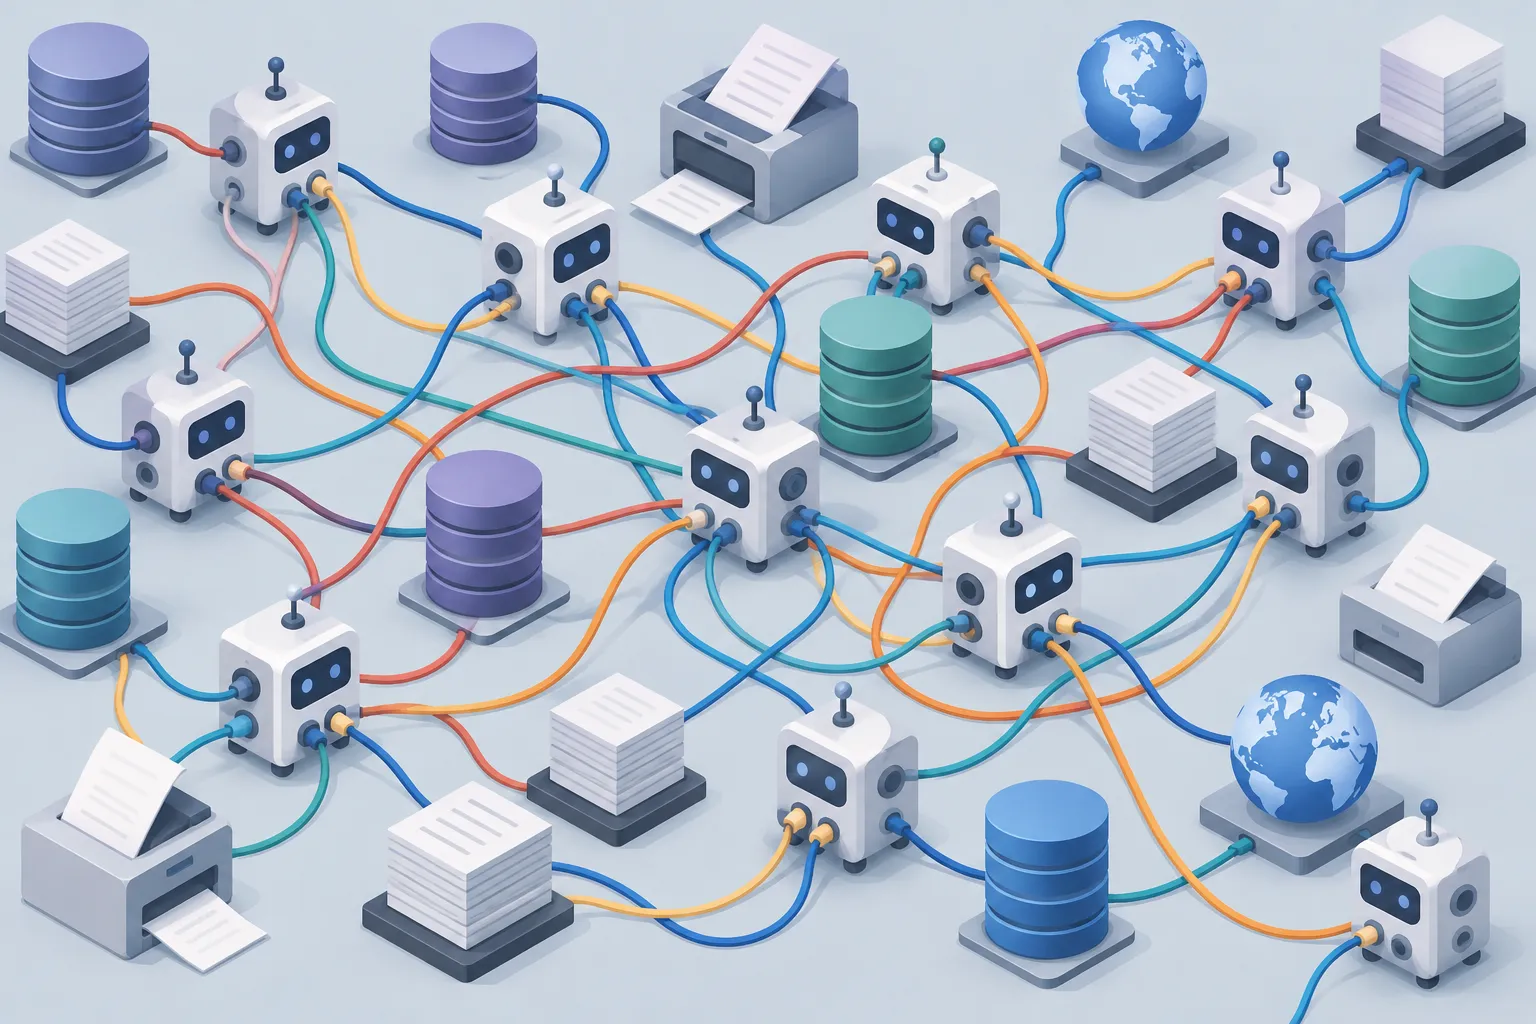
▲ 按任务不断增加的专用智能体
让文件夹充当智能体
替代方案借鉴了Unix。1969年至1970年间,肯·汤普森和丹尼斯·里奇围绕一个理念打造了操作系统:按层级文件树组织的数据,可以通过文本来浏览和操作。文件夹和文件是有意为之的发明,至今仍基础到大公司离开它们就无法运转。AI模型不过是这一结构的最新使用者。
不必为每项任务单独配一个智能体,而是给模型一套几乎适用于所有工作的小而通用的工具。这套工具可以称为AI harness,即包裹在基础模型外的一层通用工具。它需要三种能力:
- 读取文件夹中的文件
- 向文件夹写入文件
- 搜索网络
谷歌、Anthropic和OpenAI都在朝这种更简单的工具使用方式发力。Claude、Codex和Gemini还允许用户下载或自建模块化技能,比如幻灯片生成器。典型的幻灯片技能会先用HTML排版,再转换成PDF或PowerPoint。
按用途拆分文件
在每个文件夹内,把文件分成三类会有帮助,这样模型知道自己在看什么:
- 指令: 成品应当怎样制作
- 观点: 你的偏好、语气和立场
- 数据: 原始素材,比如投资人简介或公司历史
请求到来时,模型会把每个短语对应到一个文件夹:“给我做”指向你的背景和偏好,“一份幻灯片”指向制作规则和素材,“给我的投资人”指向投资人记录。同一个通用模型读哪些文件,就可以充当PDF智能体、幻灯片智能体或营销智能体。增加新能力只需添加一个子文件夹和一个指令文件,而不必重建软件管道。
这种设置还让人保持主导。模型看到哪些上下文由你决定,因此AI是拓展思考的工具,而不是不透明的自主系统。让模型在毫无人工监督的情况下以完全自主的循环运行,正是这种方法想要避免的做法。
上下文为何会改变答案
看看语言模型如何生成文本,就更容易理解文件夹为何有效。AI研究始于20世纪50年代,神经网络研究在80年代和90年代不断推进,2017年谷歌的论文《Attention Is All You Need》提出了Transformer架构。Transformer会给接下来可能出现的token(模型处理的小段文本单位)分配概率,并在写作过程中把这种选择重复数千次。
以未完成的句子“The sky is ___”为例:
| 句子前的上下文 | 可能的下一个词 |
|---|---|
| 无 | blue(60%)、beautiful(50%)、grey(40%) |
| “UK”或“night” | 分布发生变化;若是UK,则偏向grey |
| 一名在爱丁堡、遇上难得晴朗春日的学生 | beautiful超过grey |
每加入一点上下文,概率都会随之重塑。文件夹里的指令、观点和数据文件,正是这样的上下文。由此看来,尽管这些模型仍会出错,把它们贬为“只是单词预测器”,似乎低估了数十年的数学研究。
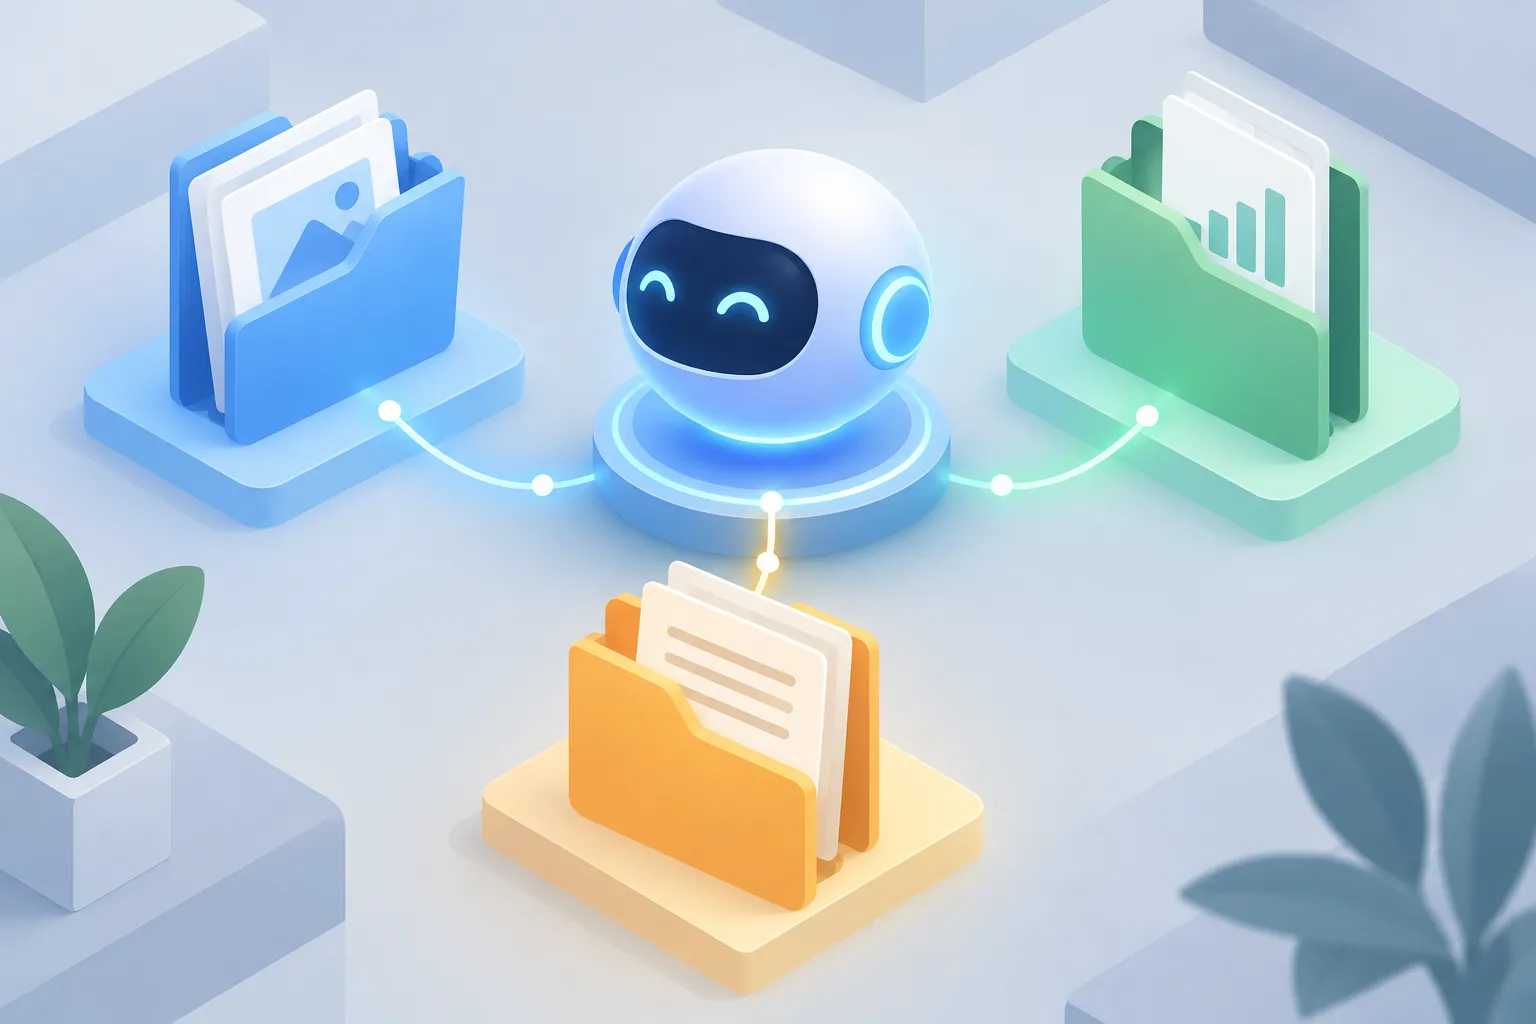
▲ 读取文件夹的通用模型
平实英语成为最新的编程层
计算机的历史可以看作一长串抽象,每一层都把复杂的步骤压缩成更短的表达:
- 19世纪初: 约瑟夫·玛丽·雅卡尔的织布机用打孔卡片自动织出图案。有孔或无孔就是指令。
- 19世纪30至40年代: 阿达·洛夫莱斯翻译了一部关于查尔斯·巴贝奇分析机的120页著作,并附上自己写的470页注释,追问这样的机器能否作曲或思考。
- 20世纪40至50年代: 艾伦·图灵提出了模仿游戏,也就是如今所说的图灵测试;克劳德·香农奠定了信息论的基础。Anthropic的Claude正是以香农的名字命名。
- 编译器: 格蕾丝·霍珀从Flow-Matic开始的工作,让程序员可以用接近英语的关键词代替原始机器码。当时许多工程师坚持计算机只该用来算数,拒绝使用它,但这一思路催生了FORTRAN等语言,NASA至今仍在使用FORTRAN。
- C语言、面向对象编程和Python: 每一层都让print这样的一个关键词代替数百个更底层的步骤。
一行Python的print语句看似微不足道,背后却是40多年的工程积累。由此看来,像“给我的投资人做一份PDF”这样的请求,就是以英语为语言的最新一类代码。不过,与结果唯一确定的代码不同,一句平实的英语请求会留下空白:AI模型无法自行知道你的目标和质量标准。文件夹结构正是把这种意图以统一形式打包交付的方法。
如何自己搭建
在动手打造新智能体之前,先从文件夹做起:
- 建立一个工作文件夹,在里面放一个“Build”文件夹和一个“Me”文件夹。
- 在“Build”中用Markdown或纯文本文件写明常用成品(比如幻灯片、PDF或营销文案)该怎样制作,并放入它们要用到的图片和素材。
- 在“Me”中写下你的语气、背景和公司历史。为投资人或客户这类经常打交道的对象建立子文件夹,每人一份简介,附上其网站链接。
- 把文件标注为指令、观点或数据,让模型清楚各自的边界。
- 只给模型读取、写入和搜索这些基本工具,然后提出请求。
- 出现新类型的任务时,添加一个子文件夹和一个指令文件。如果模型难以直接生成原生办公文档格式,就让它先生成HTML,再转换成PDF或幻灯片。
AI产出的质量在很大程度上取决于它得到的上下文。决定提供什么上下文、如何组织这些上下文,仍然是人的工作。