新しいAIエージェントを作る前に、整理されたフォルダーで同じ仕事ができないかを考えてみる価値がありそうです。汎用AIに「投資家向けのスライド資料を作って」と頼んでも、AIはあなたが誰なのか、どんな資料の作り方を好むのか、投資家が誰なのかを知りません。この2~3年、定番の解決策はタスクごとに専用のエージェントを作り、データベースやコネクター、出力ツールにつなぐことでした。これを逆転させるのがよりシンプルな方法です。指示、好み、参考データをフォルダー内のプレーンテキストファイルにまとめ、1つのAIモデルに基本的なツールをいくつか与え、依頼ごとに必要なものを読ませます。
1行の依頼に欠けているもの
投資家向け資料の依頼を分解すると、3つの欠落が見えてきます。それぞれが作成できるフォルダーに対応します。
| 依頼の部分 | AIが知るべきこと | 置き場所 |
|---|---|---|
| 「作って」 | あなたが誰か:ブランドの語り口、所在地、職歴 | 「Me」フォルダー |
| 「スライド資料」 | 資料の作り方:レイアウト、ルール、画像素材 | 「Build」フォルダー |
| 「投資家向け」 | 投資家が誰か:経歴メモ、Webサイトのリンク | 「Me」内の「Investors」サブフォルダー |
初期状態のモデルはこのいずれも知りません。データ、コンテキスト、ツールがそろっていなければ、出力はありきたりなものになるか、単に間違ったものになりがちです。2~3年前、裏付けとなる構造なしにこの依頼を送ると、まさにそうした平凡で使えない結果が返ってきました。
エージェント方式が複雑になった経緯
従来の答えは、タスクごとにモデルの周りへ独自の部品を足していくことでした。
- 非公開データへのアクセス。 モデルは個人や企業の非公開データで学習していないため、開発者はSQLデータベース、Google Drive、SharePoint、JSONやYAMLのリポジトリに接続しました。
- APIゲートウェイとコネクター。 これらのデータに届くには、クエリの構文とパラメーターを定めるAPIゲートウェイを構築し、さらにモデルとデータベースをつなぐコネクターのコードをPythonやC#で書く必要がありました。
- 文書作成ツール。 スライドを作るにはPowerPointを操作できるツールが必要でした。AIモデルはプレゼンテーションソフトを直接制御するのが難しかったため、初期のMicrosoft Copilotが作った資料の出来は非常に悪かったようです。よく使われた回避策は、AIにスライドをHTMLで書かせてスクリプトで変換するか、Webページを描画してスクリーンショットを撮り、その画像をスライドに貼り付けるというものでした。
- Webスクレイパー。 投資家を調べるには、PythonやC#で独自のスクレイパー(Webページから情報を集めるプログラム)を作り、正しい人物を見つけられるようエラー処理を組み込む必要がありました。エージェントはその後、収集したデータを内部データベースと照合してから資料を作りました。
特定のデータでモデルをさらに学習させるファインチューニングも選択肢の一つでした。ただ、パイプラインを通じて依頼の時点でデータを渡すほうが、はるかに信頼できる場合が多いのです。
より根本的な弱点はもろさです。「スライド資料」を「PDF」に変えると、スライド用に作ったエージェントでは仕事を終えられません。誰かがPDFのパイプラインを備えた2つ目のエージェントを作らなければなりません。これが社内で繰り返されると、用途の狭いエージェントを何十個も保守することになります。
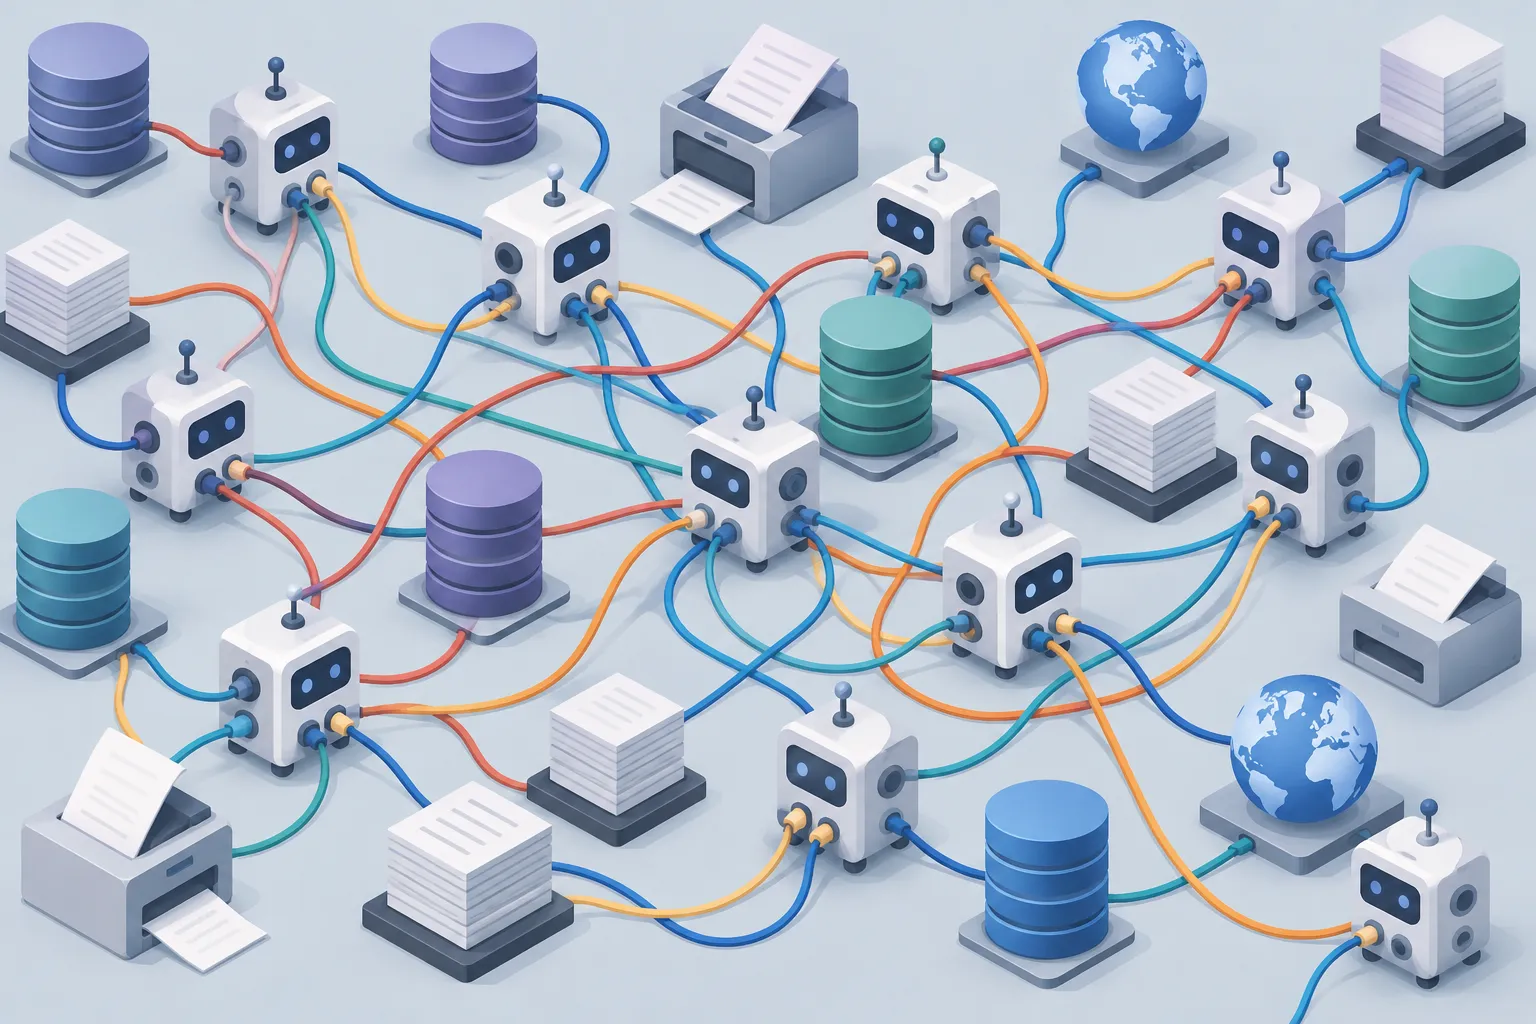
▲ タスクごとに増える専用エージェント
フォルダーをエージェントにする
代わりの方法はUnixに学ぶものです。1969年から1970年にかけて、ケン・トンプソンとデニス・リッチーは、階層型のファイルツリーとして整理したデータはテキストでたどり、操作できるという考え方を軸にOSを作りました。フォルダーとファイルは意図して生み出された発明であり、今も大企業がそれなしでは立ち行かないほど基本的な仕組みです。AIモデルは、その構造を使う最も新しい利用者にすぎません。
タスクごとに別のエージェントを用意する代わりに、モデルにはほぼあらゆる作業に使える小さく汎用的なツール一式を持たせます。この一式は、ベースモデルを包む汎用ツールの層という意味でAIハーネスと呼べます。必要な機能は次の3つです。
- フォルダー内のファイルを読む
- フォルダーにファイルを書く
- Webを検索する
Google、Anthropic、OpenAIはいずれも、こうしたより単純なツール利用の方向へ力を入れています。Claude、Codex、Geminiでは、スライド資料ビルダーのようなモジュール型のスキルをダウンロードしたり自作したりすることもできます。典型的なスライド用スキルは、HTMLでスライドをレイアウトしてからPDFやPowerPointに変換します。
役割ごとにファイルを分ける
各フォルダーの中では、ファイルを3種類に分けておくと、モデルが何を見ているのかを把握しやすくなります。
- 指示: 成果物をどう作るか
- 意見: あなたの好み、語り口、視点
- データ: 投資家のプロフィールや会社の沿革といった素材
依頼が届くと、モデルは各フレーズをフォルダーに対応づけます。「作って」はあなたの経歴と好みへ、「スライド資料」は作成ルールと素材へ、「投資家向け」は投資家の記録へと向かいます。同じ汎用モデルが、どのファイルを読むかによってPDFエージェントにも、スライド資料エージェントにも、マーケティングエージェントにもなります。新しい機能を加えるには、ソフトウェアのパイプラインを作り直すのではなく、サブフォルダーと指示ファイルを追加すればよいのです。
この構成は主導権を人の側に残します。モデルが目にするコンテキストを決めるのはあなたなので、AIは中身の見えない自律システムではなく、思考を広げる道具として働きます。人の監督なしにモデルを完全に自律したループで動かすことは、この方法が避けようとするやり方です。
コンテキストが答えを変える理由
フォルダーが機能する理由は、言語モデルが文章を生成する仕組みを見るとはっきりします。AI研究は1950年代に始まり、ニューラルネットワークの研究は1980年代から1990年代に進展しました。そして2017年、Googleの論文「Attention Is All You Need」がTransformerアーキテクチャを発表しました。Transformerは次に来る可能性のあるトークン(モデルが処理する小さなテキストの単位)に確率を割り当て、文章を書く間にその選択を何千回も繰り返します。
「The sky is ___」という未完成の文を例に取ります。
| 文の前にあるコンテキスト | 次に来やすい単語 |
|---|---|
| なし | blue(60%)、beautiful(50%)、grey(40%) |
| 「UK」または「night」 | 分布が変わる。UKならgreyの方向へ |
| 珍しく晴れた春の日のエディンバラにいる学生 | beautifulがgreyを上回る |
コンテキストを少し加えるたびに、確率は形を変えます。フォルダー内の指示、意見、データのファイルは、まさにそうしたコンテキストです。こう考えると、こうしたモデルを「単なる単語予測器」と片づけるのは、モデルが今も間違いを犯すとはいえ、数十年にわたる数学研究を過小評価しているように見えます。
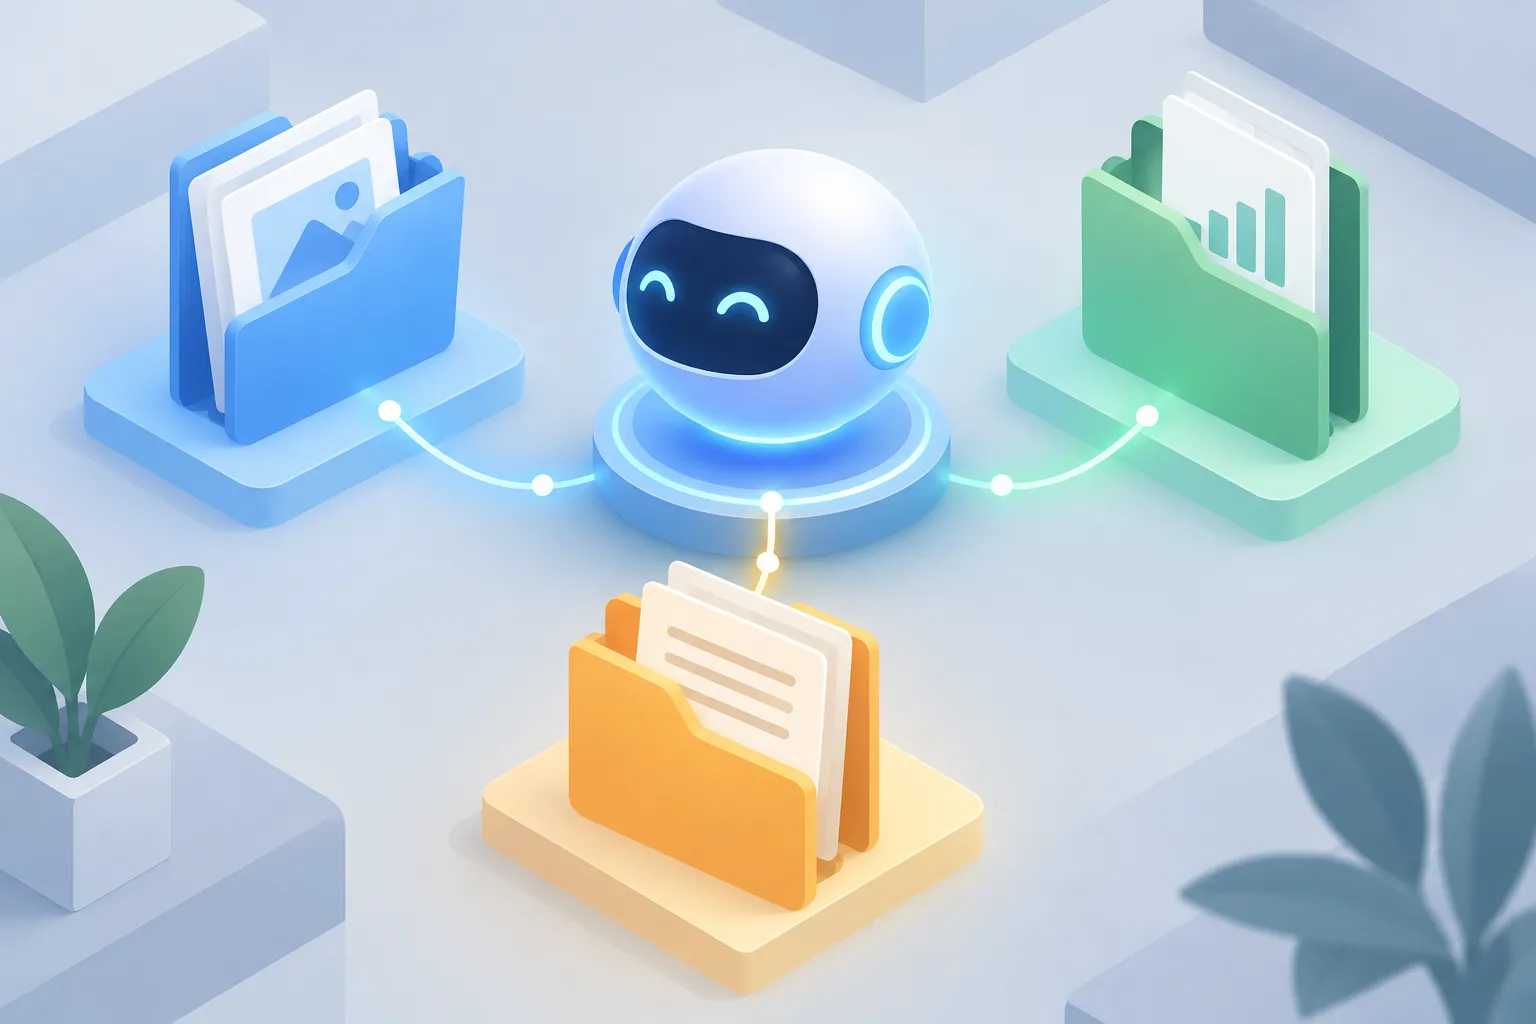
▲ フォルダーを読む1つの汎用モデル
新しいプログラミング層としての平易な英語
コンピューティングの歴史は、複雑な手順をより短い表現に詰め込んでいく抽象化の長い連なりとして読むことができます。
- 1800年代初め: ジョゼフ・マリー・ジャカールの織機は、穴を開けたカードで模様を自動的に織りました。穴があるかないかが命令でした。
- 1830年代から1840年代: エイダ・ラブレスはチャールズ・バベッジの解析機関に関する120ページの著作を翻訳し、自身による470ページの注釈を加えて、そうした機械が作曲や思考をできるのかを問いました。
- 1940年代から1950年代: アラン・チューリングは現在チューリングテストとして知られるイミテーションゲームを提唱し、クロード・シャノンは情報理論の基礎を築きました。AnthropicのClaudeはシャノンにちなんで名づけられています。
- コンパイラー: Flow-Maticに始まるグレース・ホッパーの仕事により、プログラマーは生の機械語の代わりに英語に近いキーワードを使えるようになりました。当時の多くのエンジニアはコンピューターは計算のためだけのものだと主張して使おうとしませんでしたが、この考え方はFORTRANのような言語につながり、NASAは今もFORTRANを使っています。
- C、オブジェクト指向プログラミング、Python: どの層も、printのような1つのキーワードで何百もの下位の手順を代わりに表せるようにしました。
1行のPythonのprint文は些細に見えますが、その下には40年以上のエンジニアリングが積み重なっています。そう考えると、「投資家向けのPDFを作って」のような依頼は、英語を言語とする最も新しい種類のコードとして働きます。ただし、結果が1つに定まるコードとは違い、平易な英語の依頼には空白が残ります。AIモデルは、あなたの目的や品質基準を自分では知り得ません。フォルダー構造は、その意図を一貫した形にまとめて渡す方法です。
自分で構築する手順
新しいエージェントに手を伸ばす前に、まずフォルダーから始めます。
- 作業用フォルダーを作り、その中に「Build」フォルダーと「Me」フォルダーを置きます。
- 「Build」には、スライド資料、PDF、マーケティング文案など、よく作る成果物をどう作りたいかをMarkdownやプレーンテキストのファイルに書き、使う画像や素材も入れます。
- 「Me」には、あなたの語り口、経歴、会社の沿革を書きます。投資家や顧客のように繰り返し相手にする人たちはサブフォルダーにまとめ、1人につき1つのプロフィールとWebサイトのリンクを置きます。
- ファイルに指示、意見、データのラベルを付け、それぞれの範囲をモデルが把握できるようにします。
- モデルには読む、書く、検索するという基本的なツールだけを与え、依頼を出します。
- 新しい種類のタスクが出てきたら、サブフォルダーと指示ファイルを追加します。モデルがOfficeの形式をそのまま作るのに苦労する場合は、まずHTMLを作らせ、それをPDFやスライドに変換します。
AIが生み出すものの質は、受け取るコンテキストに大きく左右されます。そのコンテキストを何にし、どう構造化するかを決めることは、今も人が担う仕事です。