AI 모델의 내부는 사람이 들여다볼 수 없는 black box라는 말은 수십 년 동안 거의 상식처럼 통했습니다. 그런데 OpenAI에서 초기 mechanistic interpretability(모델 내부 회로를 부품 단위로 분석해 동작 원리를 밝히는 연구) 연구에 참여했고 지금은 interpretability 연구소 Goodfire에 몸담은 Nick Cammarata 연구진이 'Neural Networks Are Already Clean'이라는 연구 에세이에서 정반대의 주장을 내놓았습니다. 신경망 내부는 이미 정돈돼 있고, 최대 90%는 사람이 읽을 수 있다는 것입니다. 이 주장이 맞다면 "모델이 무엇을 하는지 모른다"는 AI 안전의 가장 큰 불안 요소가 상당 부분 해소될 수 있습니다. 이 글에서는 black box 통념이 어떻게 만들어졌는지, 새 연구가 무엇을 뒤집었는지, 그리고 더 안전한 모델로 이어지려면 무엇이 더 필요한지 따져 봅니다.
black box 통념은 어디서 왔나
기계 내부를 알 수 없을 것이라는 예감은 오래됐습니다. Alan Turing은 1950년에 이미 지능을 가진 기계 안에서 무슨 일이 일어나는지 우리는 대체로 모를 것이라고 썼습니다. 이후 AI 분야는 모델을 더 크고 똑똑하게 만드는 데 집중했고, 모델을 신뢰하는 데 필요한 interpretability는 뒤로 밀려났습니다.
구조적인 출발점은 1980년대의 표현 방식 논쟁입니다. 당시 인지과학과 AI는 지식을 저장하는 두 가지 방식을 놓고 맞섰습니다.
| 구분 | localist representation(국소 표현) | distributed representation(분산 표현) |
|---|---|---|
| 개념 저장 방식 | 개념마다 전용 unit 하나를 배정 | 여러 neuron에 걸친 활성 패턴으로 개념이 드러남 |
| 예시 | 고양이 unit, 개 unit, 자동차 unit이 각각 존재 | 한 neuron이 여러 개념에 걸쳐 활성화 |
| 사람이 읽기 | 고양이 unit이 켜지면 고양이를 처리 중이라고 바로 알 수 있음 | neuron 하나만 봐서는 의미를 알 수 없음 |
Geoffrey Hinton이 강하게 밀었던 분산 표현이 승리했습니다. 이유는 분명했습니다. 특징을 사람이 일일이 프로그래밍하지 않아도 자동으로 학습하고, N개의 unit으로 N개보다 훨씬 많은 개념을 담을 수 있으며, unit 일부가 손상돼도 개념이 사라지지 않고 흐려지는 데 그치고, 공유 특징을 통해 자동으로 일반화하며, 일부 패턴만 주어져도 전체 표현을 꺼내는 content-addressable memory가 가능했습니다. 오케스트라에 비유하면 어떤 연주자 한 명도 곡 자체는 아니고, 선율은 전체의 합주 속에만 존재하는 방식입니다.
대가는 가독성이었습니다. 네트워크가 커지고 연결이 깊어질수록 사람은 개별 node와 activation(neuron이 입력에 반응해 내는 활성값)이 무엇을 뜻하는지 해독할 수 없게 됐고, black box라는 평판이 굳어졌습니다.
superposition, 피할 수 없는 구조로 여겨지다
1980년대부터 2020년대 사이의 실증 연구는 더 깊은 혼란을 드러냈습니다. polysemanticity(다의성), 즉 neuron 하나가 서로 무관한 여러 대상에 동시에 반응하는 현상입니다. 같은 neuron이 여우, 픽업트럭, 고속열차에 모두 반응하는 식입니다.
2022년 Anthropic이 발표한 'Toy Models of Superposition'은 이 현상을 수학적으로 설명했습니다. 원래 superposition(겹쳐 담기)이 결함이 아니라 의도된 기능일 수 있는지 살피려는 연구였는데, 분석 결과는 이렇습니다. 한 층이 가진 기하학적 차원보다 담아야 할 개념의 수가 많아지면 개념을 서로 직교하게 저장할 수 없습니다. 모델은 통계적으로 덜 중요한 특징을 버리거나, 남는 개념을 서로 겹치는 비직교 방향에 밀어 넣어야 합니다. 겹침은 개념끼리 서로 번지는 노이즈를 만들지만, 작은 네트워크가 훨씬 큰 네트워크를 흉내 내기 위해 감수하는 비용입니다.
이 연구로 superposition은 현대 신경망 구조에서 사실상 피할 수 없는 것으로 받아들여졌고, AI 안전 분야는 black box를 넘을 수 없는 구조적 현실로 보게 됐습니다. 여기에 더해 OpenAI가 2023년에 진행한 첫 자동 interpretability 프로젝트에서 뚜렷하게 읽히는 neuron이 약 2%에 그쳤다는 결과도 비관론에 힘을 보탰습니다. Cammarata 본인도 당시 이 결과를 보고 비관적인 쪽으로 기울었던 연구자입니다.
'신경망은 이미 깨끗하다'는 주장
전환점은 도구였습니다. Claude와 GPT 같은 agent형 모델(목표를 받아 스스로 여러 단계의 작업을 수행하는 AI)이 등장하면서 사람이 손으로 하던 interpretability 감사를 대규모로, 훨씬 짧은 시간에 수행할 수 있게 됐습니다. Cammarata 연구진은 이 도구로 신경 회로를 다시 조사했고, 과거에 '임의의 개념 뭉치기'로 보였던 것이 실제로는 'recursive generalization(재귀적 일반화)'이라는 구조적인 메커니즘이었다고 주장합니다. 초기 모델에서 관찰된 superposition과 polysemanticity의 상당 부분은 당시의 원시적인 분석 도구가 만든 착시였다는 해석입니다.
여우, 트럭, 고속열차가 공유한 V자
연구진은 여우, 픽업트럭, 고속열차에 반응하던 유명한 다의성 neuron을 다시 살폈습니다. agent 기반 검사 도구로 확인하니 세 이미지에서 가장 높은 activation은 모두 같은 기하학적 특징, 즉 뾰족한 V자 윤곽에 대응했습니다. 여우의 주둥이와 귀, 트럭의 쐐기형 보닛, 고속열차의 유선형 앞부분이 그 위치입니다.
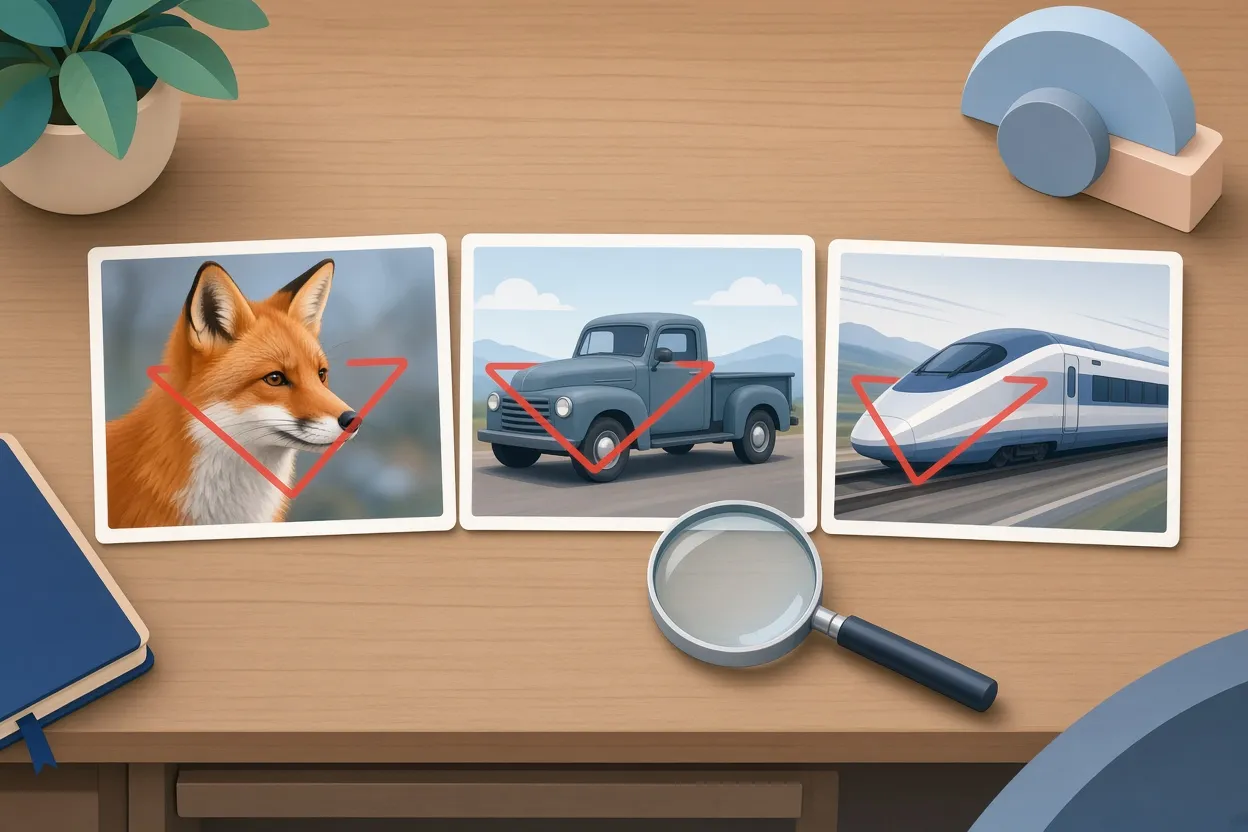
▲ 세 이미지가 공유한 V자 특징
가설을 검증하기 위해 연구진은 neuron의 음의 극도 분석했습니다. neuron은 양으로 활성화만 하는 것이 아니라 반대되는 특징을 억제하기도 하기 때문입니다. V자 윤곽의 반대편에는 둥근 O자 윤곽이 있었습니다. 동물로 시험하니 주둥이가 뾰족한 개에는 양으로 반응하고, 프렌치 불도그처럼 얼굴이 납작하고 둥근 개에는 음으로 반응하며 밀어냈습니다. 하나의 neuron이 양극과 음극으로 하나의 스펙트럼을 담고 있던 셈입니다.
용량을 일부러 제한한 네트워크에서도 임의의 개념 섞기는 나타나지 않았습니다. 대신 공간 해상도를 낮춰 더 넓은 범주 구분을 만들었습니다. 병목 층이 지상 차량(소방차, 견인차, 버스, 전차)을 양극에, 배와 비행기(구명정, 여객선, 군용기)를 음극에 배치하는 식입니다.
한 neuron이 철자 조각에서 개념으로 자라는 과정
신경망이 사전 계획 없이 어떻게 스스로 정리되는지 보기 위해 연구진은 neuron 하나를 학습 과정 내내 추적했습니다.
- 학습 초기에는 단순한 맞춤법 검사기처럼 'Miyazaki' 같은 단어의 'iy' 철자 묶음에만 반응했습니다.
- 학습 token이 늘자 약어 'DIY'에도 반응하기 시작했습니다. 아직 'iy'가 포함된 단계입니다.
- 학습 후반에는 'i'나 'y'가 전혀 없는 'Do It Yourself'라는 문장과, 사람이 전동 공구로 가구를 조립하는 사진에도 강하게 반응했습니다.
token 조각에서 약어로, 다시 넓은 개념 추상화로 계층적으로 자라나는 이 과정이 recursive generalization의 실제 모습이라는 설명입니다.
수치로 본 가독성: 90%와 75%
Qwen3-32B에 대한 예비 감사 결과는 다음과 같습니다.
| neuron 극의 유형 | 비율 |
|---|---|
| 하나의 뚜렷한 주 역할(밀접한 파생 역할 동반) | 약 90% |
| 서로 관련된 두 가지 역할 | 약 7% |
| 특성이 규명되지 않거나 이해가 어려움 | 2~4% |
수조 개 parameter 규모의 Kimi K3 같은 더 큰 모델에서도 비슷한 가독성 수치가 관찰됐다고 합니다.
약하고 노이즈처럼 보이는 activation이 왜 그렇게 많은지 설명하기 위해 ablation(특정 요소를 제거하고 성능 변화를 보는 실험)도 수행했습니다.
| 제거 대상 | 정확도 변화 |
|---|---|
| 가장 약한 activation 75% | 72%에서 71%로, 1%p 하락 |
| 가장 강한 activation 7% | 72%에서 4%로 급락 |
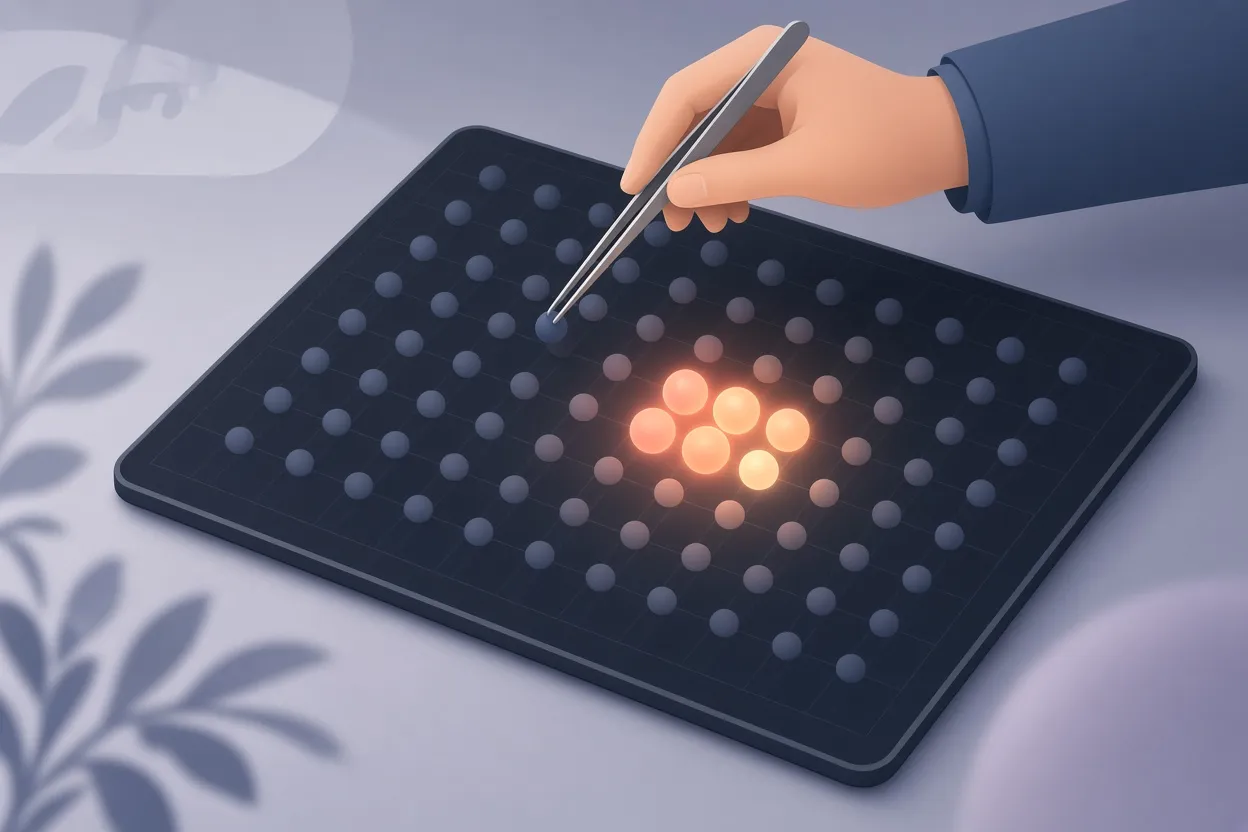
▲ 약한 activation 제거 실험
약한 activation의 대부분은 최종 출력에 기여하지 않는 배경 노이즈이고, 모델의 핵심 결정은 소수의 강한 activation이 좌우한다는 뜻입니다. 모델이 생각보다 훨씬 덜 얽혀 있다는 주장을 뒷받침하는 결과로 읽힙니다.
국소와 분산은 같은 구조의 두 얼굴
이 결과는 1980년대 논쟁에 대한 하나의 답으로도 읽힙니다. 국소 표현과 분산 표현은 서로 배타적인 선택지가 아니라 같은 구조를 보는 두 가지 상호보완적 설명이라는 것입니다. 털이 있음, 다리 넷, 짖음, 바퀴, 금속 같은 개별 특징 감지 unit 수준에서 보면 표현은 국소적입니다. 그 공유 unit들에 걸친 조합 패턴으로 개, 고양이, 자동차 같은 복합 개체를 나타낸다고 보면 표현은 분산적입니다. 개는 털 1, 다리 넷 1, 짖음 1, 바퀴 0, 금속 0이고 자동차는 그 반대인 식입니다. 한때 신경과학에서 조롱받던 '할머니 세포'(할머니 한 사람만 알아보는 전용 neuron) 발상이 완전히 틀린 것은 아니었을 수 있다는 해석도 가능합니다.
연구진은 신경망을 유기적으로 자라난 도시에 비유합니다. 복잡하고 빽빽하지만 무질서하게 엉킨 것이 아니라 내부 질서에 따라 구조화돼 있고, 따라서 의미 있게 해석하고 유도하고 지킬 수 있다는 것입니다.
안전한 모델로 이어질까: 남은 조건과 할 일
이 연구가 중요한 이유는 분명합니다. 모델 내부를 읽을 수 있다면 안전 위험을 추적하는 정밀한 모니터링 도구를 만들고, 쓸모없는 연산을 걷어내 에너지를 아끼고, 고장 난 계산 경로를 고치는 일이 가능해집니다. alignment(모델이 사람의 의도와 가치에 맞게 행동하도록 맞추는 일)를 체계적으로 유도할 길도 열립니다. 보안 관점에서는 모델이 의도치 않은 행동을 내부적으로 어떻게 만드는지 회로 단위로 추적할 길이 열린다는 점이 특히 의미 있어 보입니다.
다만 단서가 있습니다.
- 이 연구는 정식 논문이 아니라 비공식 연구 에세이이자 작동 가설이며, 엄격한 peer review를 아직 거치지 않았습니다. Anthropic이 수학적으로 보인 superposition 이론과 어떻게 양립하는지도 검증이 필요합니다.
- neuron 극의 2~4%는 여전히 전혀 규명되지 않았고 더 깊은 연구가 필요합니다.
- 분류 기준은 고차원 특징 공간을 단순한 통계로 압축하므로, '하나의 특징'을 어떻게 정의하느냐에 따라 정확한 백분율은 달라질 수 있습니다.
따라서 지금 시점에서 독자가 취할 태도는 "black box 문제가 끝났다"는 결론이 아니라, 전제가 흔들리고 있다는 사실을 인지하고 검증 과정을 지켜보는 것입니다. 모델 내부를 직접 다루는 연구자나 엔지니어라면 이 연구가 쓴 분석 방법 자체를 참고할 수 있습니다. neuron 하나를 하나의 개념과 짝짓기보다 고차원 벡터 패턴으로 activation을 보고, 다의성으로 보이는 neuron은 양극과 음극을 함께 분석해 밑바탕의 스펙트럼을 찾고, 텍스트 라벨의 의미보다 실제 입력 이미지의 윤곽을 살피고, 감사 과정에서 크기가 작은 activation은 노이즈로 걸러내고, 학습 checkpoint를 따라 neuron을 추적해 추상화가 어떻게 생겨나는지 확인하는 방식입니다. AI 안전을 지켜보는 독자라면 이 에세이에 대한 peer review 결과와 다른 모델에서의 재현 여부를 다음 확인 지점으로 두면 됩니다.


