解釈可能性研究者のニック・カマラタ氏とそのチームが執筆した研究エッセイ「Neural Networks Are Already Clean」は、AI研究で数十年にわたり前提とされてきた考え方に真っ向から異を唱えています。ニューラルネットワークの内部は、手に負えないもつれではないというのです。エッセイによれば、現代の言語モデルではニューロン極のおよそ90%が人間に読める単一の役割を担っており、その逆を証明しているかに見えた厄介な「多義的」ニューロンの多くは誤読だったといいます。この主張が査読に耐えるなら、AIシステムを透明で安全なものにしようとするすべての人にとって、出発点そのものが変わることになります。
この研究は、査読済みの成果ではなく、非公式なエッセイにおける作業仮説であると明確に位置づけられています。しかし、再検証されたニューロンから枝刈り実験に至るまで、示されている証拠は具体的で、詳しく理解する価値があります。
ニューラルネットワークがブラックボックスになった理由
機械論的解釈可能性とは、ニューラルネットワークの内部構成要素が実際に何を計算しているのかを説明し、人間がモデルを信頼し制御できるようにすることを目指す分野です。その難しさの根源は、1980年代に下された設計上の選択にさかのぼります。
当時、認知科学とAIの分野では、ネットワークに知識を蓄える二つの方式が議論されていました。
- 局所表現は、概念ごとに専用のユニットを割り当てます。あるノードは「猫」に、別のノードは「車」に、また別のノードは「犬」に反応します。猫のノードが活性化していれば、ネットワークは間違いなく猫について考えているといえます。
- 分散表現は、ジェフリー・ヒントン氏が提唱したもので、各概念を多数のニューロンにまたがる活動パターンとして広げます。単一のニューロンはそれ自体では何の意味も持たず、概念は組み合わさったパターンの中にのみ存在します。旋律が一人の演奏者ではなくオーケストラ全体にのみ宿るのと同じです。
勝ったのは分散表現で、それには十分な理由がありました。特徴量を手作業でプログラムせずに自動で学習でき、N個のユニットで組み合わせによりN個をはるかに超える概念を符号化でき、ユニットが失われても性能が緩やかにしか落ちず、共有する特徴を通じて汎化でき、部分的なパターンから全体を取り出す内容参照型の記憶も実現できます。その代償が可読性でした。ネットワークが大きくなるにつれ、個々の活性化が何を意味するのか誰にも言えなくなり、「ブラックボックス」という評判が定着しました。アラン・チューリング氏は1950年という早い時期にこれを予見し、知的な機械の内部で何が起きているかについて、私たちは大部分を知らないままになるだろうと記しています。
重ね合わせが決定打に見えた
1980年代から2020年代にかけて、研究者が個々のニューロンに目を向けると、さらに混乱させる現象が見つかりました。多義性です。一つのニューロンが、キツネ、ピックアップトラック、高速列車という、明らかな関係のない対象に反応することがあるのです。
2022年、Anthropicは「Toy Models of Superposition」を公開し、この現象に数学的な説明を与えました。ある層が持つ次元数より多くの概念を表現しなければならないとき、すべての概念をそれぞれ独立した直交軸に置くことはできません。まれな特徴量を捨てるか、余分な概念を重なり合う非直交の方向に押し込むかのどちらかになります。この重なりによって概念同士が互いににじみ出し、ノイズが生じます。小さなネットワークは、はるかに大きなネットワークを近似する見返りとしてこのノイズを許容しているというわけです。概念の数はほぼ常に次元数を上回るため、重ね合わせは事実上避けられないものに見え、安全性分野の多くはブラックボックスを構造上の宿命として受け入れるようになりました。
カマラタ氏自身もその悲観論を共有していました。OpenAIで初期の機械論的解釈可能性研究に携わっていた同氏は、2023年の自動解釈の取り組みで、明確に読み取れるニューロンが約2%しか見つからないのを目にしています。
何が変わったのか:大規模なエージェント型監査
新しいエッセイは、変化の要因をツールの進歩に求めています。ClaudeやGPTのようなエージェント型AIアシスタントは、人間の研究者が必要とする時間のほんの一部で、膨大な数のニューロンに対して解釈可能性の監査を実行できるようになりました。この能力を使い、カマラタ氏のチームは多義性の古典的な事例に立ち返ったところ、詳しく調べると見かけ上の無秩序さは消えてしまったといいます。
キツネ、トラック、列車
チームは、キツネ、ピックアップトラック、新幹線型の列車に反応することで知られる有名なニューロンを再検証しました。各画像のどこで活性化がピークに達するかを調べると、共通する幾何学的特徴が見つかりました。はっきりしたV字型の輪郭です。それはキツネの鼻先と耳、トラックのくさび形のボンネット、列車の空力的な先頭部に現れていました。このニューロンは無関係な三つの概念を抱えていたのではなく、たまたま三種類の物体に現れる一つの形状を検出していたのです。
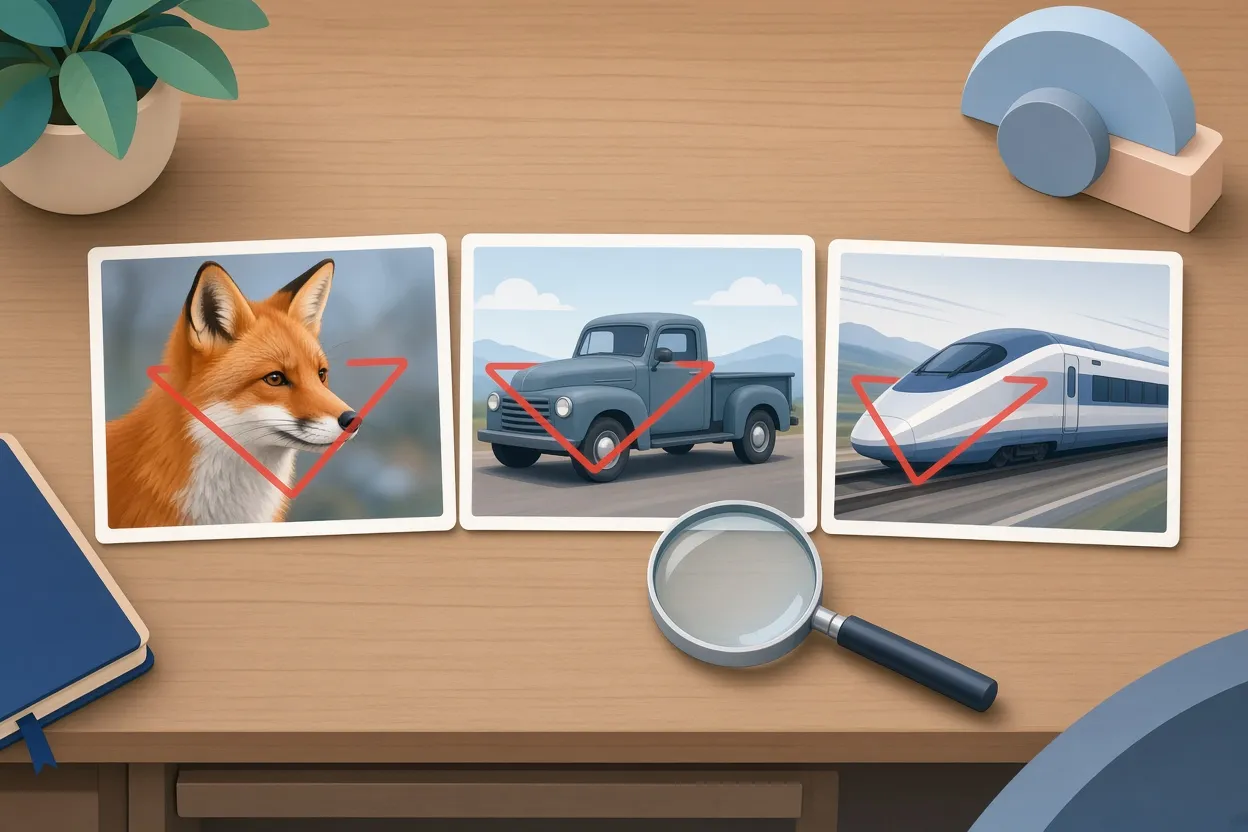
▲ V字輪郭を共通して検出する一つのニューロン
この仮説を検証するため、研究者はニューロンの負の極を調べました。ニューロンは活性化するだけでなく、反対の特徴に対して押し返す働きもします。正の極がV字形を符号化しているなら、負の極はその反対を符号化しているはずです。実際にそうでした。丸みを帯びたO字型の輪郭がニューロンを負の方向に駆動したのです。とがった口元を持つ犬は正の活性化を生み、平らな顔のフレンチブルドッグは負の活性化を生みました。
エッセイはさらに、ネットワークを意図的に圧縮して容量を制限しても、恣意的な概念の混合には頼らないと報告しています。その代わりに空間分解能を落とし、より大きなカテゴリー分割を形成します。たとえば、消防車、レッカー車、バス、路面電車といった地上の乗り物を一方の極に、船と飛行機をもう一方の極に置くといった具合です。
学習中の再帰的汎化
事前の計画なしにこうした構造がどう形成されるのかを理解するため、チームは一つのニューロンを学習の全過程にわたって追跡しました。その変化は段階を踏んでいました。
- 初期には、ニューロンは粗いスペルチェッカーのように振る舞い、「Miyazaki」という名前に含まれるような文字の並び「iy」にだけ反応していました。
- 学習が進むと、やはり「iy」を含む頭字語「DIY」へと汎化しました。
- さらに後には、「Do It Yourself」という語句全体や、電動工具で家具を組み立てる人々の写真に強く反応するようになりました。文字の「i」も「y」も含まれていないにもかかわらずです。
カマラタ氏はこのパターンを「再帰的汎化」と呼びます。ニューロンはトークンの断片から始まり、関連する記号へ広がり、最終的に広い概念に落ち着くというものです。エッセイは、かつてのツールが重ね合わせと見なしたものの背後にある仕組みとして、恣意的な詰め込みではなくこの階層的な成長を提示しています。
監査から得られた数値
Qwen3-32Bに対する予備的な監査では、ニューロン極の内訳は次のようになりました。
| 分類 | ニューロン極に占める割合 |
|---|---|
| 特定可能な主要な役割が一つ(近縁の派生を伴うことが多い) | 約90% |
| 明確に関連する二つの役割 | 約7% |
| 未分類または十分に理解できていない | 2%から4% |
エッセイは、Kimi K3を含め、数兆パラメータ規模のはるかに大きなアーキテクチャを調べた場合でも、同様の可読性が見られたと報告しています。
二つ目の実験は、ネットワークを雑然と見せる多数の弱くノイズの多い活性化を扱っています。チームは活性化を強さに応じて枝刈りし、ImageNetのクラスに対する精度を測定しました。
| 枝刈りの条件 | 枝刈り前の精度 | 枝刈り後の精度 |
|---|---|---|
| 最も弱い75%の活性化を除去 | 72% | 71% |
| 最も強い7%の活性化を除去 | 72% | 4% |
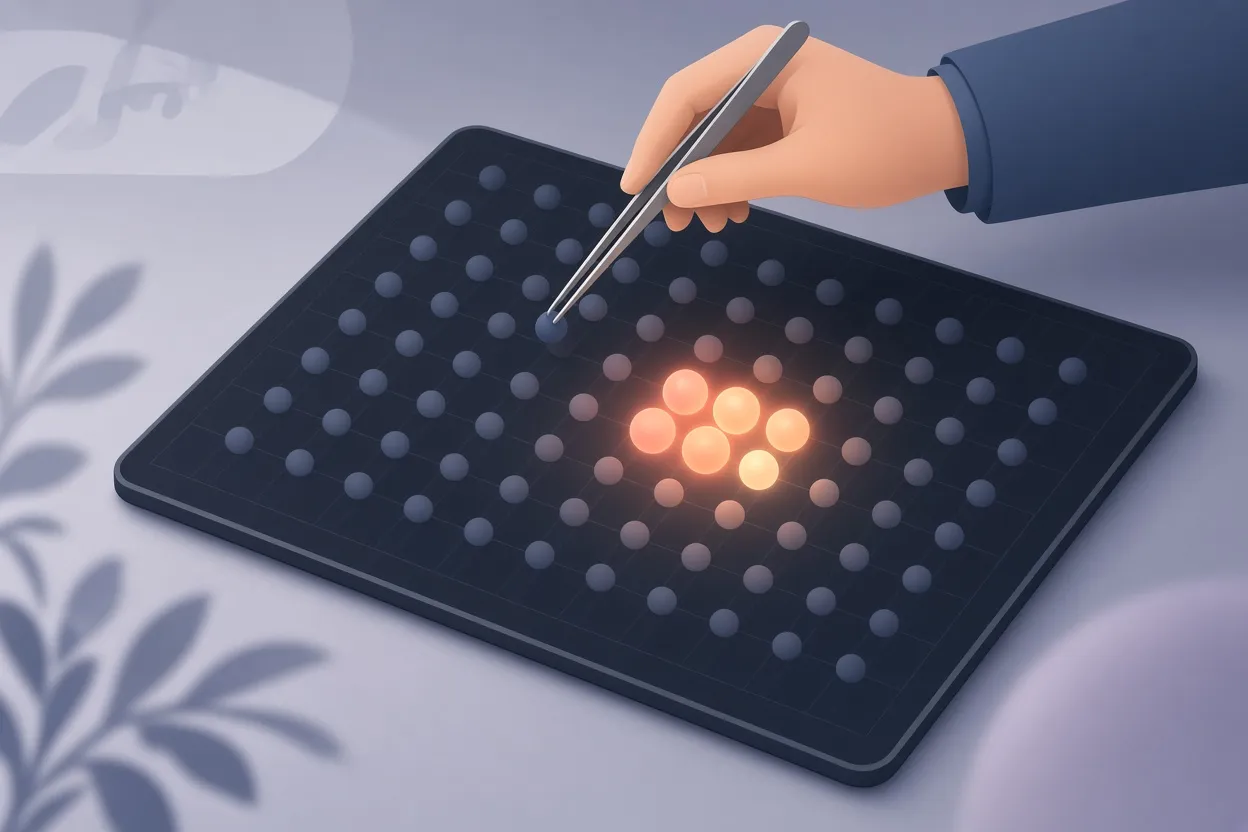
▲ 弱い活性化を除いた後に残る強い活性化の塊
エッセイが示す解釈は、大量の低強度の活性化は出力にほとんど影響しない背景ノイズであり、少数の強い活性化が実際の計算を担っているというものです。解釈可能性の観点からは、監査者が弱い活性化を取り除いて強いものに集中しても、モデルが何をしているかという筋書きを見失わずに済むことを示唆しています。
局所と分散は一つのシステムの二つの見方
エッセイは、古い論争の勝者を宣言するのではなく、局所表現と分散表現は同じアーキテクチャを異なる水準で記述したものだと論じています。個々の特徴検出器(毛皮がある、四本足、吠える、車輪がある、金属製)の水準では、表現は局所的で、各ユニットは一つの役割を持ちます。複合的な物体(犬、猫、車)の水準では、表現は分散的です。犬は「毛皮=1、四本足=1、吠える=1、車輪=0、金属=0」というパターンであり、車は同じユニット上の補完的なパターンになります。
そこから浮かび上がるネットワークの姿は、有機的に成長した都市です。密集し、複雑で、全体計画なしに築かれていながら、無秩序なもつれではなく内的な秩序に支配されています。振り返れば、1980年代に局所表現の考え方を完全に退けたことは、十分に正当化されていなかったのかもしれません。
なお重要な留保
熱狂を抑えるべき制約がいくつかあります。
- この研究は非公式な研究エッセイであり、作業仮説です。厳密な査読をまだ経ておらず、重ね合わせの確立された数学との整合も取る必要があります。
- ニューロン極の2%から4%は依然としてまったく特徴づけられておらず、より深い研究が必要です。
- 割合は分類のしきい値に依存します。高次元の特徴空間を少数の要約統計量に圧縮する以上、研究者が「別個の特徴」をどう定義するかによって正確な数値は変わり得ます。
- 枝刈りと監査の結果は特定のモデルとベンチマークから得られたもので、すべての知見があらゆるアーキテクチャに当てはまるかは未解決の問題です。
安全性にとっての意味と、いま取るべき行動
AI安全性のコミュニティがエッセイの示す構造を検証して認めれば、実務上の影響は大きいものになるでしょう。エンジニアは、読み取れる回路を通じて安全上のリスクを追跡する精密な監視ツールを構築し、エネルギーを浪費する計算を特定して取り除き、基盤モデル内部の壊れた経路を修復できるようになります。モデルを信頼できるほど理解することは、AI開発に欠けていた半分だったといえ、内部が整然としていればその半分はずっと扱いやすくなります。
解釈可能性に携わる、あるいは関心を持つ読者に向けて、エッセイはいくつかの具体的な実践を示唆しています。
- 活性化を高次元のパターンとして分析し、高水準のラベルだけに頼らず、トリガーとなる入力の視覚的・テキスト的な輪郭を調べる。
- ニューロンが多義的に見えるときは、正と負の両極を調べて、そのニューロンが符号化している根底のスペクトルを見つける。
- 監査では低強度の活性化を除外する。最も弱い75%は大部分がノイズと見られるためです。
- 学習のチェックポイントをまたいでニューロンを追跡し、トークン水準の経験則から抽象概念がどう育つかを確認する。
現時点で責任ある姿勢は慎重な楽観です。「Neural Networks Are Already Clean」を有望な初期証拠を伴う強力な仮説として扱い、独立した再現と査読を見守り、定義が精緻化されるにつれて具体的な割合が動くことを想定しておくことです。


