可解释性研究者Nick Cammarata及其团队撰写的研究随笔《神经网络早已清晰》(Neural Networks Are Already Clean)提出了一个与AI研究数十年来的既有假设背道而驰的论断:神经网络的内部并不是一团无望解开的乱麻。随笔称,现代语言模型中大约90%的神经元极点只承担一项人类可读懂的任务,而那些曾被视为反证的、杂乱的"多义"神经元,在很大程度上是被误读了。如果这一论断能经受住同行评审,任何试图让AI系统透明、安全的人,起点都将随之改变。
这项工作明确定位为非正式随笔中的工作假设,而非经过同行评审的成果。但它给出的证据,从重新审视的神经元到剪枝实验,都足够具体,值得仔细了解。
神经网络为何成了黑箱
机械可解释性研究的目标,是解释神经网络内部各个组件究竟在计算什么,以便人类能够信任并引导模型。这项任务之所以困难,可以追溯到上世纪80年代的一个设计选择。
当时,认知科学和AI领域围绕在网络中存储知识的两种方式展开争论:
- 局部表示为每个概念分配一个专属单元。一个节点对应"猫",另一个对应"汽车",再一个对应"狗"。只要猫节点被激活,网络就毫无歧义地在"想"猫。
- 分布式表示由杰弗里·辛顿倡导,把每个概念分散到许多神经元的活动模式之中。任何单个神经元本身都没有意义,概念只存在于组合起来的模式里,就像一段旋律只存在于整个乐团,而不在某一位乐手身上。
分布式表示胜出了,而且理由充分。它无需手工编程就能自动学习特征;N个单元通过组合能编码远多于N个的概念;单元丢失时性能平稳下降;能够跨共享特征泛化;还支持按内容寻址的记忆,即凭部分模式检索出整体。代价是可读性。随着网络越来越大,没人能说清任何一个激活值意味着什么,"黑箱"的名声就此形成。艾伦·图灵早在1950年就预见了这一点,他写道,我们将对智能机器内部发生的事情基本一无所知。
叠加似乎为此盖棺定论
从上世纪80年代到2020年代,研究者在放大观察单个神经元时发现了更令人困惑的现象:多义性。同一个神经元可能同时对狐狸、皮卡车和高速列车产生响应,而这些东西之间看不出明显关联。
2022年,Anthropic发表了《Toy Models of Superposition》,为这一现象给出了数学解释。当一层网络需要表示的概念数量超过它拥有的维度时,就无法让每个概念各占一条正交的轴。它要么舍弃稀有特征,要么把多出来的概念挤进相互重叠、非正交的方向。这种重叠让概念彼此渗透,产生噪声,而小网络容忍这种噪声,以换取对更大网络的近似。由于概念几乎总是多于维度,叠加看起来在实践中不可避免,安全领域的很多人因此把黑箱视为一种结构性的既定事实。
Cammarata本人也曾持这种悲观看法。作为OpenAI早期的机械可解释性研究者,他看到2023年一项自动化可解释性工作只找到约2%的神经元是明确可读的。
转折点:规模化的智能体审计
这篇新随笔把转变归功于工具的变化。Claude、GPT等智能体AI助手如今可以对海量神经元进行可解释性审计,所需时间只是人类研究者的一小部分。凭借这种能力,Cammarata的团队回头重新检视多义性的经典案例,发现所谓的随机性在更仔细的观察下烟消云散。
狐狸、卡车与列车
团队重新审视了那个著名的、同时对狐狸、皮卡车和子弹头列车响应的神经元。检查每张图片中激活峰值出现的位置后,他们发现了一个共同的几何特征:一条鲜明的V形轮廓。它出现在狐狸的口鼻和耳朵、卡车楔形的引擎盖,以及列车流线型的车头。这个神经元并不是在同时处理三个毫不相关的概念,而是在检测一种恰好出现在三类物体上的形状。
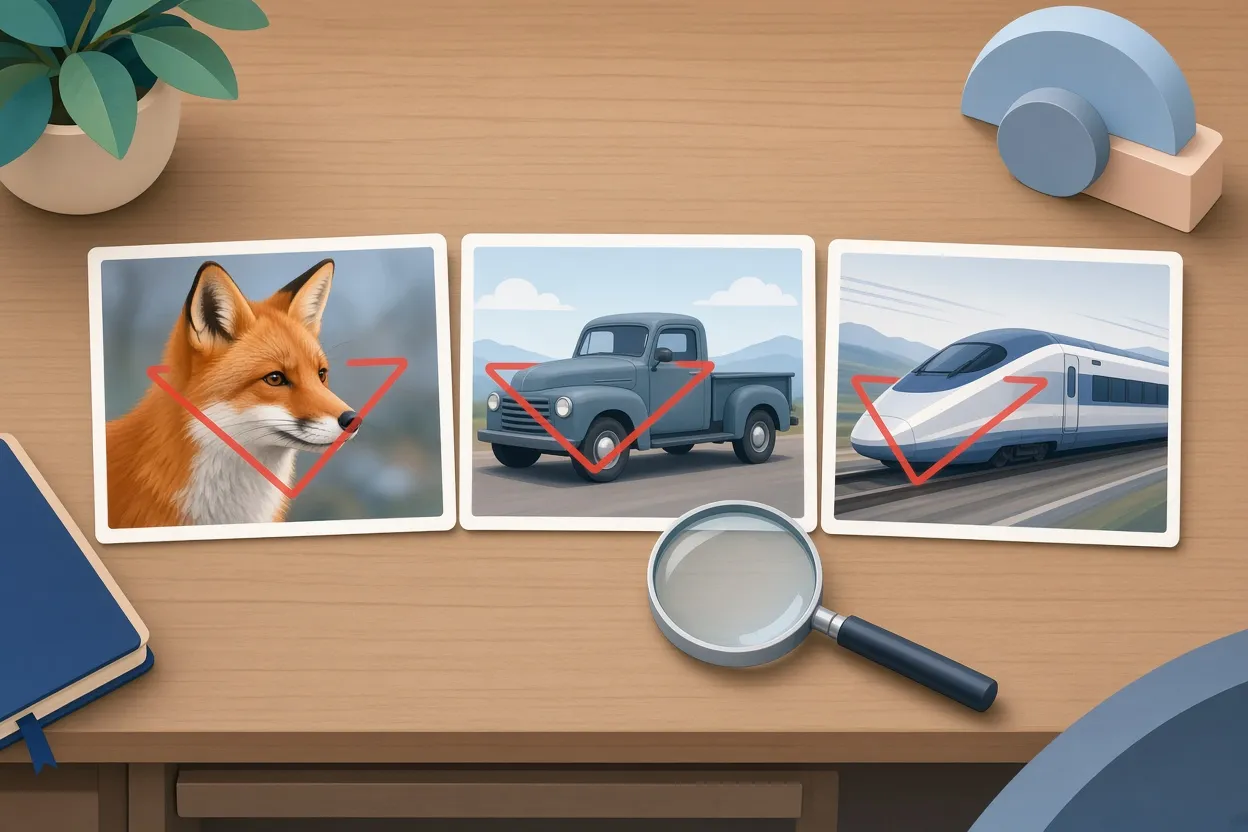
▲ 一个神经元检测共同的V形轮廓
为了验证这一假设,研究者检查了该神经元的负极。神经元不只会激活,还会抵制相反的特征。如果正极编码的是V形,负极就应当编码其反面。结果确实如此:圆润的O形轮廓会把该神经元推向负值。口鼻尖长的狗产生正激活,而脸部扁平的法国斗牛犬则产生负激活。
随笔还报告,即便刻意压缩网络以限制其容量,它也不会诉诸任意的概念混合,而是降低空间分辨率,形成更宽泛的类别划分,例如把消防车、拖车、公共汽车、有轨电车等地面车辆放在一极,把船和飞机放在另一极。
训练过程中的递归泛化
为了理解这种结构如何在没有任何预先规划的情况下形成,团队追踪了单个神经元在整个训练过程中的变化。其演进分为几个阶段:
- 早期,该神经元表现得像一个粗糙的拼写检查器,只对字母组合"iy"响应,例如名字"Miyazaki"中的"iy"。
- 随着训练继续,它泛化到了缩写"DIY",其中仍然包含"iy"。
- 再往后,它对完整短语"Do It Yourself"以及人们用电动工具组装家具的照片产生强烈响应,即便其中根本没有字母"i"或"y"。
Cammarata把这种模式称为"递归泛化":神经元从一个词元片段起步,扩展到相关符号,最终落脚于一个宽泛的概念。随笔认为,正是这种层级式生长,而非任意的塞挤打包,才是早期工具所观察到的"叠加"背后的机制。
审计给出的数字
在Qwen3-32B上进行的初步审计,给出了神经元极点的如下分布:
| 类别 | 神经元极点占比 |
|---|---|
| 一项主要的、可识别的任务(常伴有密切相关的分支) | 约90% |
| 两项明显相关的任务 | 约7% |
| 未归类或理解不足 | 2%到4% |
随笔报告,在检查规模达万亿参数的更大架构(包括Kimi K3)时,也观察到类似的可读性。
第二项实验针对的是大量微弱、嘈杂的激活,正是它们让网络显得杂乱。团队按强度对激活进行剪枝,并测量在ImageNet类别上的准确率:
| 剪枝条件 | 剪枝前准确率 | 剪枝后准确率 |
|---|---|---|
| 移除最弱的75%激活 | 72% | 71% |
| 移除最强的7%激活 | 72% | 4% |
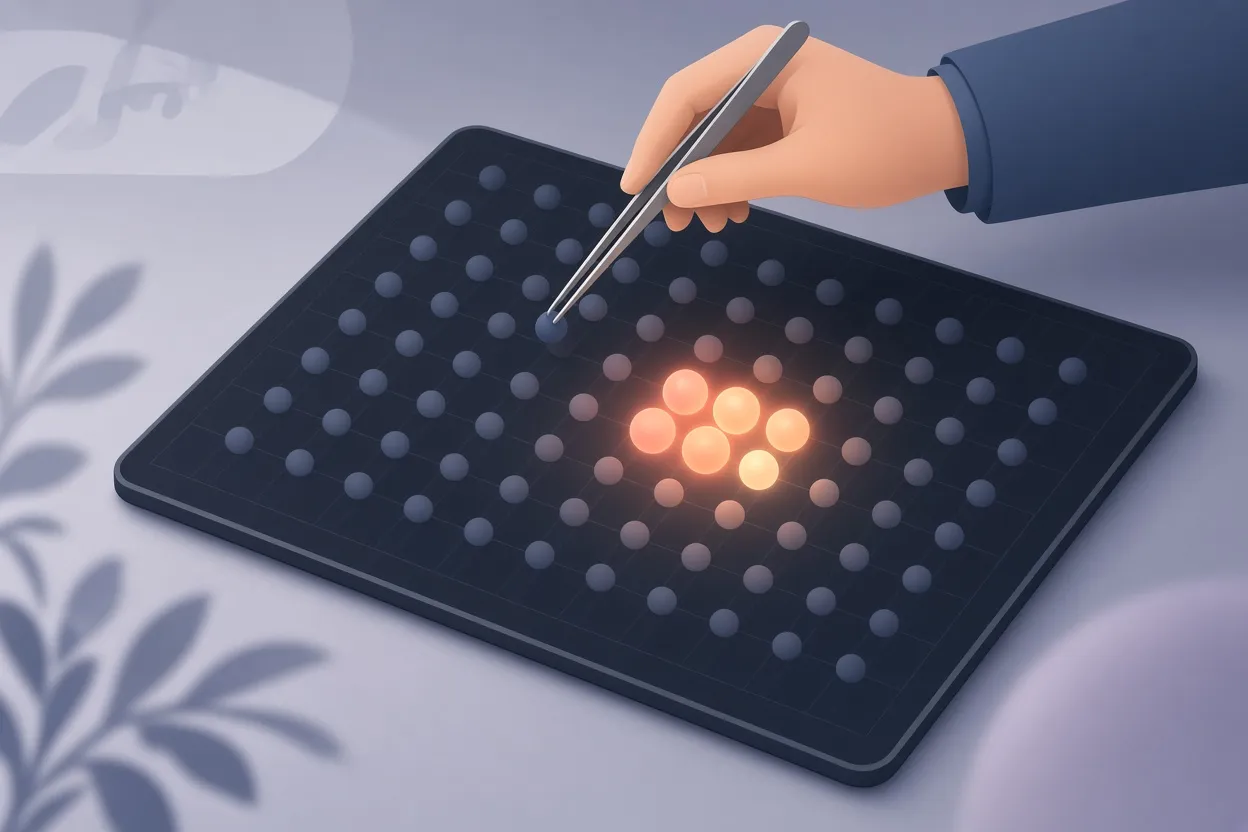
▲ 剪除弱激活后留下的强激活簇
随笔给出的解读是,绝大多数低幅度激活只是背景噪声,对输出几乎没有影响,而真正的计算由一小组强激活承载。对可解释性而言,这意味着审计者可以过滤掉弱激活、专注于强激活,而不会丢失模型行为的主线。
局部与分布式:同一系统的两种视角
随笔没有在旧争论中宣布胜者,而是主张局部表示和分布式表示描述的是同一架构的不同层级。在单个特征检测器的层级(毛茸茸、四条腿、会叫、轮子、金属),表示是局部的:每个单元只做一件事。在复合对象的层级(狗、猫、汽车),表示是分布式的:狗是"毛茸茸=1、四条腿=1、会叫=1、轮子=0、金属=0"这一模式,而汽车则是同一组单元上的互补模式。
由此得到的网络图景,是一座自然生长出来的城市:稠密、精巧、没有总体规划,却受内在秩序支配,而非随机缠绕。回过头看,上世纪80年代对局部表示思想的彻底否定,或许并不完全站得住脚。
仍需重视的局限
有几项限制应当为这份热情降温:
- 这项工作是一篇非正式研究随笔,是一个工作假设。它尚未经过严格的同行评审,也还需要与已经确立的叠加数学理论相互调和。
- 2%到4%的神经元极点仍然完全未被归类,需要更深入的研究。
- 百分比取决于分类阈值。把高维特征空间压缩成几个汇总统计量,意味着具体数字会随着研究者对"独立特征"的定义而变化。
- 剪枝和审计结果来自特定模型和基准,每一项发现是否都能迁移到所有架构,仍是一个悬而未决的问题。
对安全意味着什么,以及现在能做什么
如果AI安全社区验证了随笔所描述的结构,其现实影响将十分重大。工程师可以构建精确的监测工具,沿着可读的回路追踪安全风险;识别并移除浪费能耗的计算;修复基础模型内部损坏的通路。对模型理解到足以信任它的程度,可以说一直是AI开发中缺失的那一半,而一个更清晰的内部结构会让这一半容易得多。
对于从事或关注可解释性研究的读者,随笔给出了几条具体的做法:
- 把激活当作高维模式来分析,检查触发输入的视觉或文本轮廓,而不是只依赖高层标签。
- 当某个神经元看起来具有多义性时,同时检查其正极和负极,找出它所编码的底层谱系。
- 审计时过滤掉低幅度激活,因为最弱的75%看起来大多是噪声。
- 跨训练检查点追踪神经元,观察抽象概念如何从词元层面的启发式规则中生长出来。
眼下负责任的态度是谨慎乐观:把《神经网络早已清晰》视为一个有初步证据支持、颇具前景的强假设,关注独立复现和同行评审的进展,并预期随着定义的细化,具体百分比还会变动。


