Google DeepMind가 로봇용 AI 모델 묶음인 Gemini Robotics 2를 공개했습니다. 장면을 이해하고 계획을 세우는 판단 모델과, 그 계획을 손가락과 발의 움직임으로 바꾸는 동작 모델을 나눠 짝지은 구조입니다. 판단 모델은 누구나 API로 쓸 수 있지만 동작 모델은 아직 제한된 시험 참여자에게만 열려 있습니다. Gemini Robotics 연구를 이끄는 Google DeepMind의 연구 책임자는 발전 속도에 놀라면서도 지금의 로봇 AI를 언어 모델에 견주면 아직 GPT-2 시기에 있다고 평가합니다. 무엇이 새로워졌고 무엇이 여전히 어려운지 정리합니다.
Gemini Robotics 2를 이루는 세 모델
Gemini Robotics 2는 역할이 다른 세 모델로 이뤄져 있습니다. 판단은 위에서, 실제 움직임은 아래에서 맡는 층 구조입니다.
| 모델 | 맡는 일 | 이용 방법 |
|---|---|---|
| Gemini Robotics ER 2 | 장면 해석, 공간 분석, 작업 계획, 도구 선택 | Google AI Studio의 API로 공개 |
| Gemini Robotics 2 | 계획을 관절 움직임과 궤적으로 바꾸는 VLA 모델 | 제한된 시험 참여자만 이용 |
| Gemini Robotics On-Device 2 | 로봇 본체에서 클라우드 없이 돌아가는 소형 동작 모델 | 제한된 시험 참여자만 이용 |
ER은 embodied reasoning(몸을 가진 로봇이 실제 공간을 이해하고 추론하는 일)의 약자입니다. Gemini Robotics ER 2는 Gemini Flash를 바탕으로 만든 판단 모델로, 천천히 따져 보고 계획하는 ‘System 2’ 역할을 합니다. 개발자는 ‘잡기’, ’놓기’처럼 로봇이 할 수 있는 동작을 도구로 정의해 두고, 모델이 상황에 맞는 도구를 고르게 합니다. 소프트웨어 AI agent가 함수를 골라 호출하는 방식과 같습니다.
Gemini Robotics 2는 VLA(vision-language-action, 이미지와 언어를 받아 로봇의 동작을 출력하는 모델)입니다. 판단 모델이 내린 지시를 받아 손끝부터 발끝까지 몸 전체의 움직임을 한꺼번에 계산합니다. 넘어지지 않게 균형을 잡는 빠른 제어는 아래쪽의 안정화 제어기가 맡고, 어떤 자세로 어디까지 움직일지는 VLA가 정합니다. On-Device 2는 이 동작 모델을 줄여 로봇 안에서 바로 돌리게 한 것으로, 네트워크를 거치는 지연이 없고 통신이 불안정한 현장에서도 멈추지 않습니다.
판단 모델과 동작 모델을 잇는 방법
판단 모델이 동작 모델에 무엇을 원하는지 전하는 방식을 steerability(조종 가능성)라고 부릅니다. 예전에는 화면의 2D 좌표를 찍어 ’여기를 집어라’라고 지시했지만, 지금은 여러 방식을 함께 씁니다.
- 자연어: ‘뒤로 돌아라’, ’왼쪽을 봐라’처럼 말로 지시
- 가리키기: 장면 속 물체를 직접 짚어 레몬과 바나나처럼 헷갈리는 대상을 구분
- 시연: 사람이 하는 모습을 담은 동영상을 보여 주고 따라 하게 하는 in-context learning(추가 학습 없이 예시만 보고 작업을 익히는 방식)
글로만 주고받으면 공간 정보가 빠지기 쉬워, 두 모델 사이를 여러 형식의 정보로 넉넉하게 잇는 것이 연구 목표입니다.
기억도 과제입니다. Gemini Robotics ER 2의 context window(모델이 한 번에 참고할 수 있는 정보량)는 128,000 token인데, 영상 입력으로 바꾸면 약 3분 분량입니다. 짧은 조작 작업에는 충분하지만 몇 시간짜리 집안일에는 모자랍니다. 그래서 지나간 동작을 영상으로 다 남기지 않고 ’달걀을 뒤집었다’처럼 짧은 글로 요약해 두는 방식이 효율적인 압축 수단으로 쓰입니다. 프레임 수를 줄이고 변화 없는 장면을 덜어 내는 것도 방법입니다.
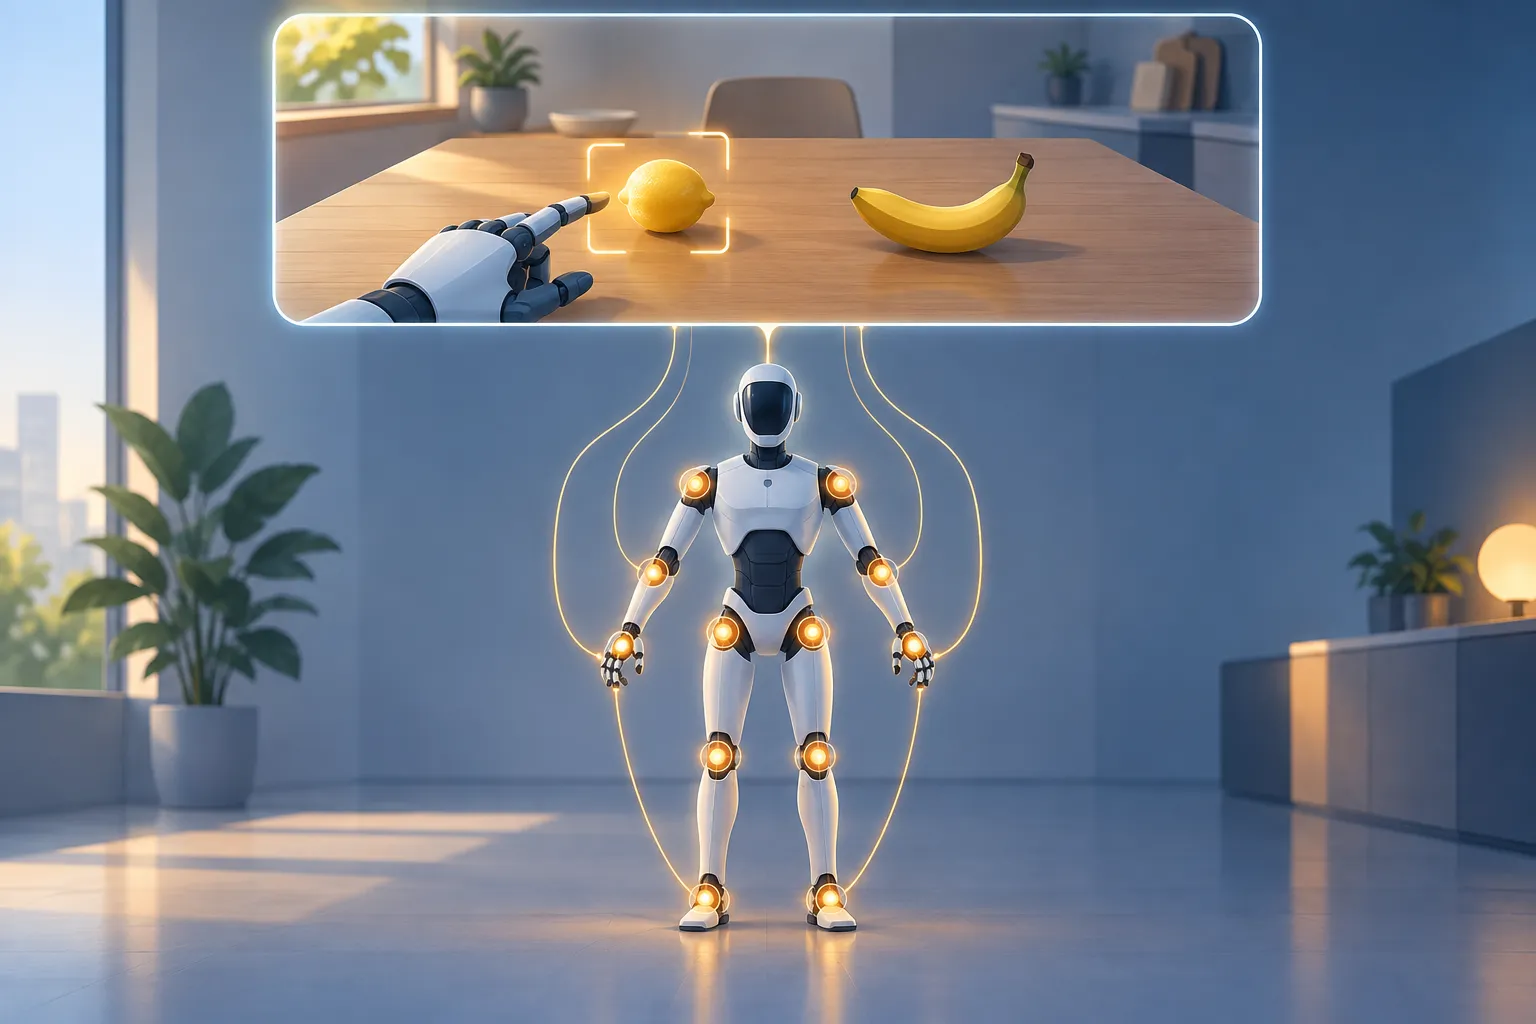
▲ 판단 모델과 동작 모델의 연결
달리기보다 손이 어려운 이유
올여름 중국에서 열린 로봇 경기 대회에서 humanoid(사람 모양 로봇)가 최정상급 단거리 선수보다 빨리 달리는 장면이 화제가 됐습니다. 연구자의 시각은 다릅니다. 평평한 트랙 위 두 발 걷기는 바닥과 발의 접촉이 단단하고 예측 가능해 시뮬레이션으로 정확히 재현할 수 있고, 시뮬레이션에서 익힌 동작이 실제 로봇으로 잘 옮겨집니다. 그런 로봇은 사람이나 동물의 걸음을 흉내 내 초기화한 뒤 강화 학습으로 다듬은 저수준 제어기에 기대는 것으로 추정되며, 고수준의 판단은 거의 쓰지 않습니다. 빨리 달리는 능력이 로봇을 실생활에 쓸모 있게 만드는 핵심도 아닙니다.
어려운 쪽은 물건을 다루는 조작입니다. 마찰이 달라지고 물체가 휘거나 접히면 시뮬레이션이 실제를 따라가지 못합니다. 옷 개기가 대표적입니다. 단단한 블록을 집어 옮기는 일은 예외로, foundation model(폭넓은 데이터로 미리 학습한 범용 모델) 덕분에 상용화에 가까운 신뢰도에 이르렀습니다. 그래서 연구의 최전선은 탁자에 고정된 집게형 로봇 팔에서, 걸으면서 쪼그려 앉아 물건을 집는 humanoid의 전신 조작으로 옮겨 갔습니다.
손도 바뀌었습니다. Gemini Robotics 1은 두 손가락 집게로 도달할 수 있는 정교함의 최대치를 보여 줬고, 약 15개월 뒤 나온 Gemini Robotics 2는 여러 손가락 손으로 쓰레기봉투 입구를 묶는 수준까지 나아갔습니다. 시장에 나온 로봇 손의 성격도 다양합니다.
| 로봇 손 | 크기 | 힘 |
|---|---|---|
| Wuji | 사람 손에 가까움 | 10살 아이 정도 |
| Sharpa | 사람 손보다 큼 | 약 20kg을 들고 꽉 닫힌 병뚜껑도 엶 |
남은 과제는 이런 손을 오래 고장 없이, 매번 같은 품질로, 적당한 값에 만드는 일입니다. 손끝의 힘 감지와 back-drivability(바깥 힘에 밀리면 관절이 부드럽게 따라 움직이는 성질)도 중요해졌습니다. 감자 칩을 부수지 않고 쌓으려면 눈으로 보는 정보만으로는 부족하고, 손끝의 힘 정보를 학습에 넣으면 판단이 크게 나아집니다.
로봇 AI가 아직 GPT-2 단계인 까닭
언어 모델에서 GPT-3가 전환점이 된 것은 예시 몇 개만 보고 여러 작업을 해내는 능력이 안정됐기 때문입니다. 로봇은 아직 그 수준에 이르지 못했다는 것이 GPT-2 평가의 근거입니다.
가장 큰 벽은 cross-embodiment(한 모델이 몸체가 다른 여러 로봇을 다루는 일)입니다. 언어 모델은 iPhone에서든 Mac이나 Linux 서버에서든 똑같이 돌아가지만, 로봇 정책은 하드웨어나 센서가 바뀌면 아예 작동하지 않는 경우가 많습니다. 언어 모델은 겪어 본 적 없는 로봇만의 문제입니다. Google DeepMind는 특정 로봇에 맞춘 두뇌가 아니라 몸체와 상관없이 작동하는 범용 지능을 목표로 하며, humanoid를 그 시험대로 삼습니다. humanoid를 다루면 전신 균형, 여러 손가락 조작, 사람과의 상호작용이라는 세 과제를 한꺼번에 풀어야 하기 때문입니다.
진전도 있습니다. Google DeepMind는 Apptronik, Agile Robots, Boston Dynamics 같은 로봇 제조사와 협력하고 있으며, On-Device 모델은 새 로봇에서 약 200회의 시연만으로 그 몸에 적응합니다. 하지만 처음 보는 로봇에 추가 학습 없이 바로 올려 실무 수준의 신뢰도를 내는 일은 아직 풀리지 않았습니다. 시연 동영상을 보고 따라 하는 방식도 준비 시간은 줄이지만, 장면이 조금만 달라져도 시연을 기계적으로 흉내 내는 데 그칠 때가 있습니다.
여러 단계를 잇는 작업에서는 오류가 쌓입니다. 동작 10개를 이어 붙이면 단계마다 성공했는지 판단하고 다음 목표를 골라야 하는데, 실시간으로 실패를 바로잡는 장치가 없으면 전체 성공률이 급격히 떨어집니다. 되돌릴 수 있는지도 큰 차이를 만듭니다.
- LEGO 조립: 실수해도 다시 끼우면 되므로 실패에 너그러운 작업
- 달걀 요리: 떨어뜨리거나 너무 익히면 되돌릴 수 없어 훨씬 높은 신뢰도가 필요한 작업
조명이나 부엌 배치가 바뀌어도 장면을 알아보는 시각 일반화는 크게 나아졌습니다. 지금 병목은 접촉, 힘 조절, 되돌릴 수 없는 단계처럼 작업의 물리적인 성격에 있습니다.
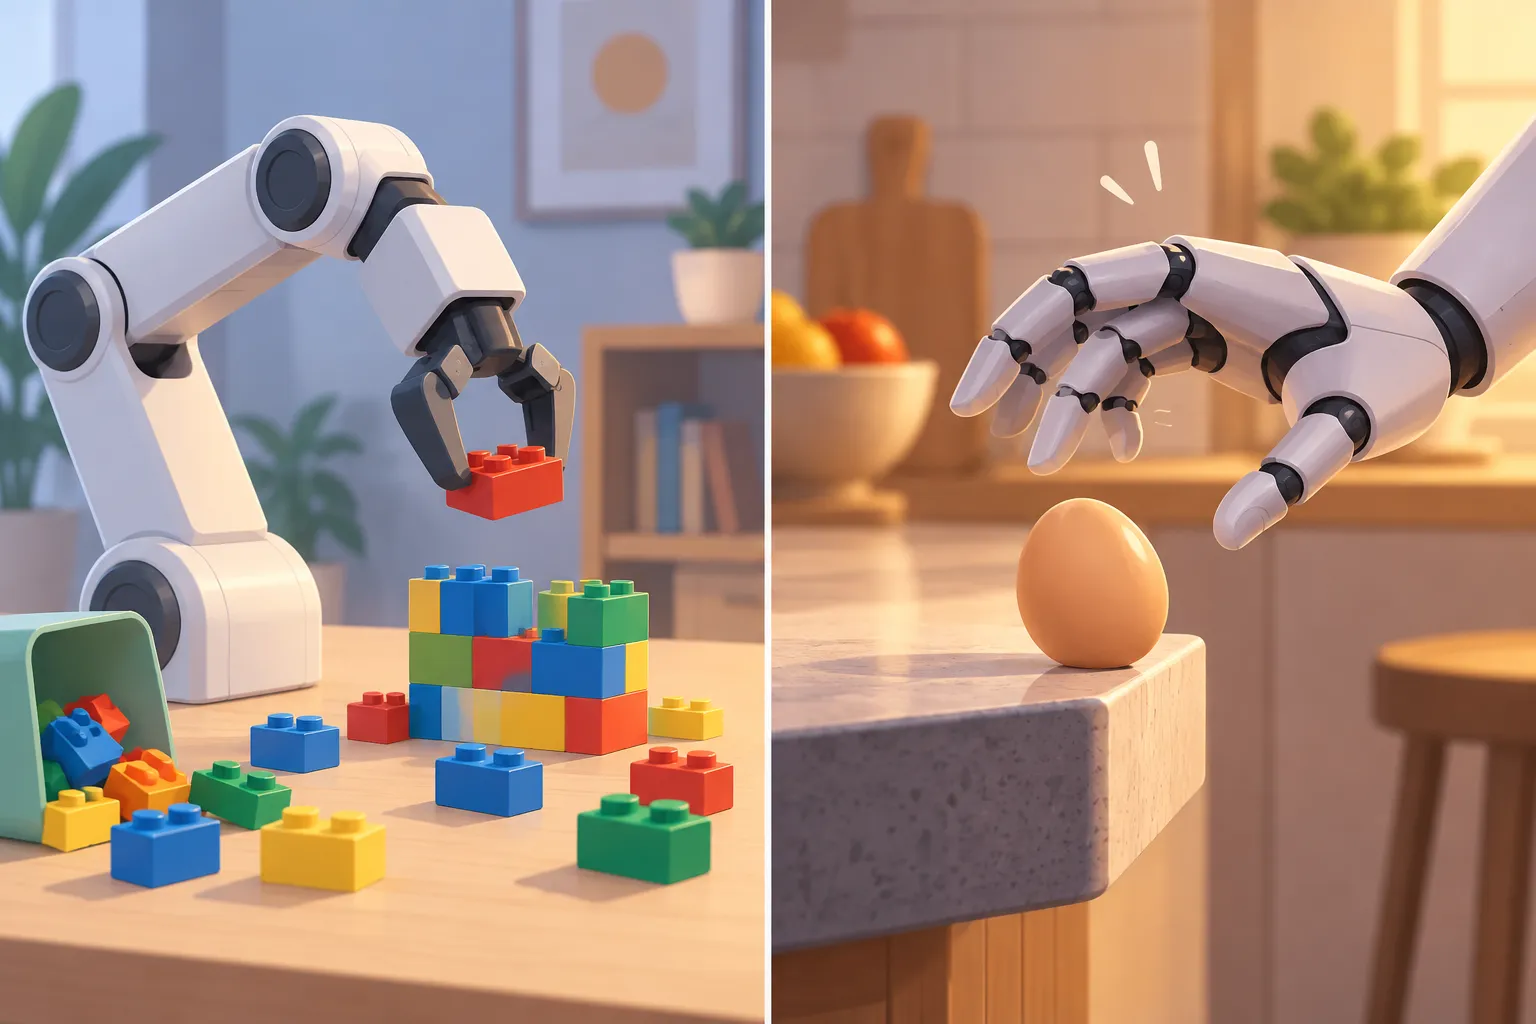
▲ 되돌릴 수 있는 작업과 없는 작업
쓰임새마다 다른 속도와 신뢰도 기준
판단 모델의 응답 속도도 따져 볼 부분입니다. Gemini Robotics API에 연결한 간단한 2D 시뮬레이션에서 ’바나나를 접시로 옮겨라’라는 지시를 받고 도구를 호출하기까지 약 6초가 걸렸습니다. 실시간 반응이 필요한 곳에서는 긴 시간입니다. 다만 필요한 속도는 용도마다 다릅니다.
- 공장 조립 라인: 멈추거나 머뭇거리면 생산이 막혀 아주 빠른 반응이 필요
- 집안일: 빨래 개기처럼 빠르기보다 정확하게 끝내는 것이 중요하고, 사람이 자는 밤사이 천천히 해도 됨
- 통신이 약한 원격 현장: 로봇 안에서 도는 모델이 필요
그렇다고 가정이 먼저 열리는 것은 아닙니다. 어린아이와 어지러운 배치처럼 예측하기 어려운 위험이 많아, 환경을 통제하기 쉬운 상업 시설이 여전히 먼저입니다. 새 능력은 크고 느린 모델에서 먼저 나오므로, 빠른 모델과 느린 모델을 함께 만들고 큰 모델의 능력을 작은 모델로 옮기는 흐름이 이어질 것으로 보입니다.
판단 모델의 강점도 쓰임에 따라 드러납니다. 단순히 물건을 집어 옮기는 시험에서는 Gemini Robotics ER 2와 일반 Gemini 1.5 Flash의 결과가 같았습니다. ER 2가 앞서는 곳은 계기판 눈금 읽기, 불량 검사, 정확한 위치 짚기 같은 전문 과제입니다. API를 Google AI Studio에 공개하자 소규모 시험 집단 때와는 비교할 수 없을 만큼 사용이 늘었고, 개발자와 연구자들은 Boston Dynamics의 Spot에 올려 계기를 읽고 간식을 나눠 주게 하기도 했습니다. 다만 로봇 업계에는 표준 API가 없어, 낯선 명령 체계를 쓰는 로봇은 prompt와 도구 정의를 여러 번 다듬어야 안정적으로 움직입니다.
안전도 능력의 하나
챗봇은 절반만 맞혀도 쓸모가 있지만, 로봇이 물건을 떨어뜨리면 실제 피해가 납니다. 성공률 50%나 80%로는 실패해도 괜찮은 작업이 아니면 혼자 맡길 수 없습니다. 그래서 안전은 성능을 깎는 제약이 아니라 그 자체로 갖춰야 할 능력으로 다뤄집니다. 안전하지 않은 가정용 로봇은 소비자가 받아들이지 않기 때문입니다.
로봇의 안전은 둔하거나 고장 나 넘어지는 물리적 안전과, 모델이 사람의 뜻에 맞게 행동하는 행동 안전으로 나뉩니다. 무거운 humanoid가 집 안에서 넘어지면 바로 위험해지므로 기계 설계부터 비상 정지 장치, 판단 모델까지 전체를 함께 설계해야 합니다.
| 비상 정지 | 작동 방식 | 두 발 로봇에서의 결과 |
|---|---|---|
| hard e-stop | 모든 관절의 전원을 끊음 | 몸이 그대로 무너져 주변 사람과 물건이 위험 |
| soft e-stop | 관절을 지금 자리에 고정 | 균형을 유지해 넘어지지 않음 |
판단 단계의 안전도 시험합니다. 작업 중인 humanoid의 머리에 바구니를 씌워 시야를 가리면, 로봇은 그대로 움직이지 않고 멈춘 뒤 사람에게 도움을 청해야 합니다. 사람 모양이라는 점도 기준을 높입니다. 집게 로봇이 물건을 놓치면 기계 결함으로 보지만, humanoid가 같은 실수를 하면 사람들은 훨씬 무능하게 느낍니다. 로봇이 대화 중 몸짓을 미리 짠 동작이 아니라 스스로 만들어 내는 등 상호작용이 자연스러워질수록, 기대치도 그만큼 올라갈 수 있습니다.
정리: 로봇 AI를 검토할 때 볼 것
Gemini Robotics 2는 판단과 동작을 나누고, 판단 모델을 API로 열어 누구나 로봇 계획에 써 볼 수 있게 했습니다. 동시에 여러 손가락 조작, cross-embodiment, 오류 누적, 안전은 아직 연구 과제로 남아 있습니다. 로봇 AI를 검토하는 개발자와 기업이라면 다음을 먼저 확인해 볼 만합니다.
- 지금 쓸 수 있는 것은 Gemini Robotics ER 2의 API입니다. 로봇 동작을 이름과 설명이 분명한 도구로 정의하고, 판단은 ER 2에, 실제 움직임은 기존 제어기나 전용 동작 모델에 맡기는 구조로 시작합니다.
- 기본 집기·옮기기가 아니라 계기 읽기, 검사, 위치 짚기처럼 ER 2가 강한 과제에서 일반 모델과 비교해 봅니다.
- 작업의 응답 속도 요구를 먼저 정합니다. 공장처럼 빨라야 하는지, 집안일처럼 느려도 정확하면 되는지에 따라 모델과 배치 방식이 달라집니다.
- 처음에는 실패해도 다시 할 수 있는 작업을 고르고, 단계를 이을 때는 단계마다 성공 여부를 확인하는 장치를 둡니다.
- 학습한 그대로의 환경이 아니라 물건 위치와 장면을 바꿔 시험해, 흉내가 아닌 일반화인지 확인합니다.
- 두 발 로봇이라면 전원을 끊는 정지 대신 관절을 고정하는 정지를 두고, 센서가 가려지면 멈추고 도움을 청하게 합니다.