コンサルティング会社AlixPartnersのチームが、合併後に積み上がった4万件超のサプライヤー契約書をClaude Codeに分析させたところ、最初に返ってきた答えは整った書式で、自信に満ちたものでした。しかし、主要な5つの数値のうち2つが間違っていました。ある修正契約が親契約に紐付けられていなかったため、エージェントは契約総額を$80万少なく見積もり、さらに実際には11月1日までに通知が必要な契約について、更新通知の期限を2026年12月1日と算出していたのです。出力のどこにも、こうした問題をうかがわせる手がかりはありませんでした。この事例が示すのは、大量の文書分析をAIエージェントに任せる人なら誰もが想定しておくべきパターンです。答えがもっともらしく見えるほど慎重な検証が必要であり、その検証はプロンプトではなくコードで行わなければなりません。
ビジネス上の課題
案件の対象は、より小規模な専門事業を買収した大手ヘルスケア企業でした。調達部門は数百に及ぶ重複ベンダーと、一度も接続されたことのない3つのデータベースシステムに分散した4万件超の契約文書を引き継ぎました。統合後の会社が特定のサプライヤーにいくら支払っているのか、全体像を把握している人は誰もいませんでした。
顧客の機密を守るため、チームは問題を再現した合成データを構築しました。買収側をHarbor Health、被買収企業をSummit Health Plan、両社が利用していたベンダーをAcme Health Servicesとしています。合併前、HarborはAcmeに対して2件の契約で年間$464万を、Summitは別の2件で$306万を支払っており、合計すると共通条件のない4件の有効契約で$770万になります。
調達部門の経営層が求めたのは2つです。この取引量を合算すれば、より有利な料率やリベートを引き出せるのかを知ること、そしてどの契約も自動更新日を迎える前に再交渉するための正確なスケジュールです。基準は厳格でした。すべての数値は、特定の契約書ページと請求書の明細行に裏付けられ、ベンダーの前で通用するものでなければなりません。
最初の実行で何が間違っていたか
最初のテストは、Acmeに対する自社の立場を分析するようClaude Codeに直接問いかけるものでした。エージェントは4件の有効契約を正しく特定し、合算した年間支出額を算出しました。しかし、元文書と照合した監査では、2つの重大な誤りが見つかりました。
| 指標 | エージェントの回答 | 検証後の値 |
|---|---|---|
| 現行契約の総額 | $1,670万 | 約$1,750万 |
| 次の通知期限 | 2026年12月1日 | 2026年11月1日 |
欠けていた$80万は、親契約フィールドが空だったために合計に集計されなかった修正契約によるものでした。期限の誤りはさらに危険なものでした。エージェントは90日前の解約条項をもとに日付を算出していましたが、同じ契約の別の箇所にある自動更新条項は、2027年3月1日の満了日の120日前までの通知を求めていました。エージェントの日付に従って動いていれば、本当の締め切りをまる1か月過ぎ、望まない自動更新が発生していたでしょう。
実際の契約書が単純なパースを破綻させる理由
失敗の原因は、エージェントの推論ではなく生データにありました。繰り返し現れたエッジケースは4つです。
- 非常に長い文書は前処理中にタイムアウトしてインデックスされず、エージェントから見れば存在しないも同然でした。
- インデックス処理が修正契約を基本契約(MSA)、つまり取引関係全体を規定する包括契約に対応付けられなかった場合、修正契約が孤立しました。こうして数十万ドル規模の金額が消えていました。
- 修正契約は、契約総額に加算するのではなく、総額そのものを書き直して再提示することがよくあります。当初$400万のMSAに$600万と$700万の修正契約を単純に足し合わせるパーサーは$1,700万という答えを出しますが、実際には最後の修正契約が総額を$700万にリセットしていました。
- ページをまたぐ料率表で列見出しが繰り返されていないと、後続ページにはOCR(光学文字認識)、つまりスキャンしたページをテキストに変換する技術のための文脈が残りませんでした。
言語モデルに生のPDFを解釈させるのではなく、チームは2週間をかけて、エージェントが触れる前に文書を構造化する専用パイプラインを構築しました。完成したパイプラインはリポジトリ全体を一晩で処理し、10人のレビューチームで数週間かかると見積もられていた作業を置き換えました。
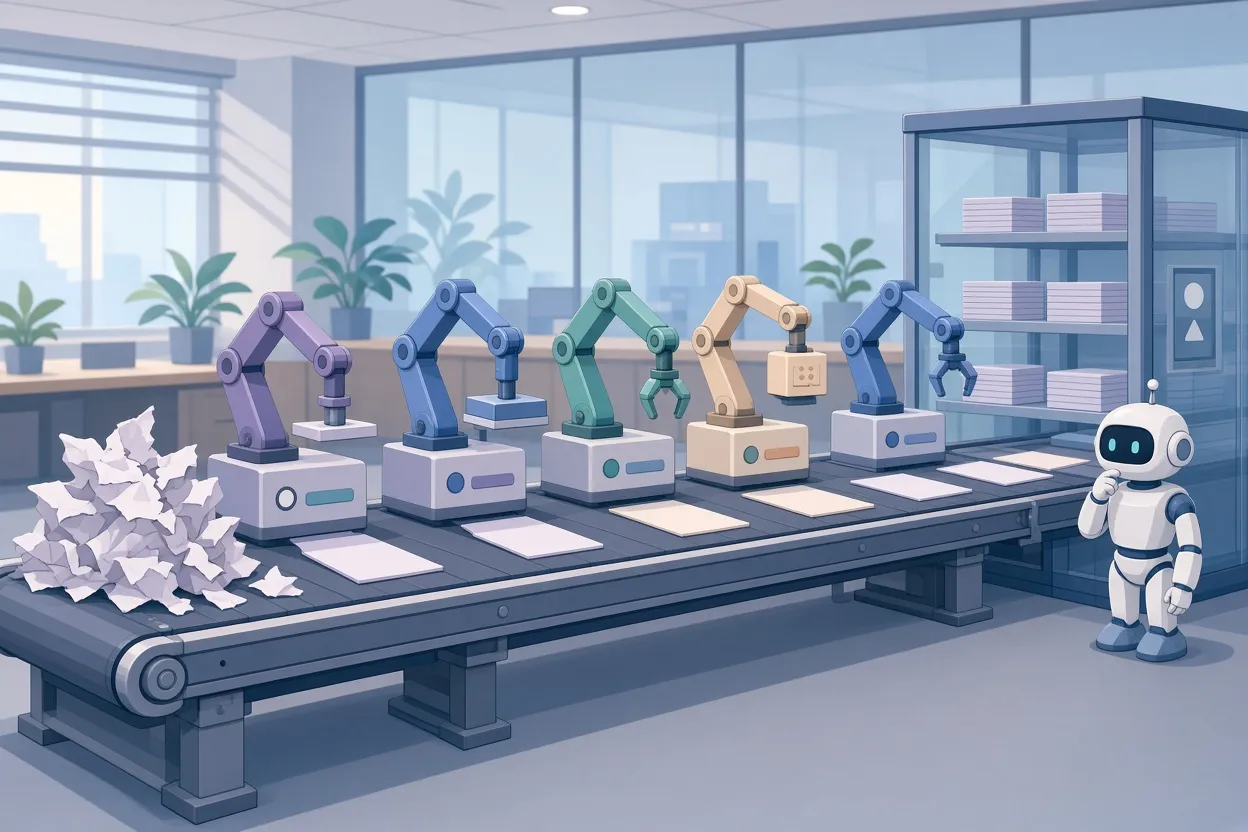
▲ 分析前に契約書を構造化する5段階パイプライン
5段階のパイプライン
パイプラインは次の5段階を順に実行します。
- ドキュメントインテリジェンスツール、OCR、そしてプロンプトと言語モデルのパイプラインをプログラムで最適化するフレームワークであるDSPyによる前処理。
- 各文書をMSA、作業範囲記述書(SOW)、修正契約、秘密保持契約のいずれかに分類。
- 契約条件、料率ティア、過去の支出を抽出し、統一クロスウォークを通じて3つのデータベース間で突合。
- SOWに記載されたサービスを標準的な企業支出カテゴリーに対応付け。
- 得られた構造化データをカスタムツール経由で照会するClaude Codeのアナリストエージェント。
抽出品質に関わる重要な点が1つありました。段階的な数量リベートのような条件は図表としてしか記載されていないことが多く、OCRは目盛りや金額のしきい値は拾うものの、リベート率の曲線を取りこぼしがちです。チームはこうしたページを画像に変換し、DSPyとマルチモーダルモデルの呼び出しを組み合わせて、各支出しきい値とそのリベート率を列挙した型付きスキーマオブジェクトを出力させました。スキーマを事前に定義しておくことで、自由形式で読み取るよりも一貫した結果が得られました。ただし、マルチモーダル抽出の手法は急速に変化しており、現在のアプローチも6か月から12か月のうちに時代遅れになる可能性があります。
データを先に構造化することには、もう1つの目的がありました。契約条件がデータベースのテーブルに収まれば、自動テストスクリプトでエージェントの回答を検証できるようになるのです。
MCPツールによる統制されたアクセス
ウェアハウスにデータが入った後も、Claude Codeが生のテーブルに直接触れることは一切許されませんでした。データは、AIエージェントを外部ツールやデータに接続するための標準規格であるModel Context Protocol(MCP)経由で公開されたカスタムツールを通じてのみ参照できます。MCP統合の構築には3日ほどかかりました。ツールはexecute_sql、list_tables、get_rate_card_page、get_amendment_chain、get_vendor_spendの5つで、それぞれに、エージェントが本来なら毎回自力で再発見しなければならないビジネスロジックを持たせることができます。
制限はプロンプトに任せるのではなく、サーバー側で強制しました。
- 接続は読み取り専用。
- 1回の呼び出しで実行できるSQL文はちょうど1つ。
- 結果は1,000行までに制限し、エージェントのコンテキストウィンドウがあふれないようにする。
- 許可されていない操作はデータベースに届く前に拒否する。
- すべてのツール呼び出しとクエリをログに記録し、どんなエラーも決定論的に再現できるようにする。
エージェントにClaude Codeを選んだのは、雑然としたコードベースを探索し推論することに長けているためで、契約と支出のテーブルからなるリポジトリは、実際のところコードベースによく似ているからです。
本番運用から得た5つの教訓
期限のルールをコードに落とし込む
12月1日という誤りが起きたのは、解約条項と更新条項が契約書の別々の場所にあり、エージェントが両方を正しく読むことに頼った結果、エラー率が積み重なったためです。対策として、クエリログを検査し、更新条項を確認せずに解約条項の文言だけを確認した実行にフラグを立てるテストハーネスを用意しました。漏れが見つかると、タスクをエージェントに差し戻して該当条項の引用を抽出させ、その後、モデルに推定させるのではなく決定論的なコードで日付を計算します。
契約の階層構造を修復する
契約ライフサイクル管理システムは本来、MSA、SOW、修正契約を紐付けて管理するはずのものですが、実際には適切に保守されていることはまれです。今回の事例では、修正契約INTAKE-2026-6447がSummitの契約を$540万から$620万へ更新していたにもかかわらず、親IDがnullだったためレポートから無視されていました。チームは、紐付けのない修正契約を読み、親契約への言及を探す補助的なClaudeプロセスを追加しました。その後、決定論的なチェックで、候補となる親契約が検索結果に含まれていること、抽出した引用が文書の本文と一字一句一致することを確認してから、リンクを確定します。修正契約の紐付けにより、評価額は$1,670万から$1,740万へ、最終的に$1,750万へと修正されました。
権限エラーをはっきり表に出す
支出の統合作業中、エージェントはSummitのAcmeに対する支出を$0と結論づけました。実際の数値はHarborの$4,635,096と並んで$3,064,117でした。Summitの請求書テーブルにかかっていた行レベルセキュリティがエラーを出さずに空の結果セットを返し、エージェントはその空をゼロと読んだのです。ツールは、空の結果とアクセス制限を区別し、権限によって取得が阻まれた場合には有益なフィードバックを返すように書き直され、承認済みの集計ビューへのフォールバック経路も用意されました。
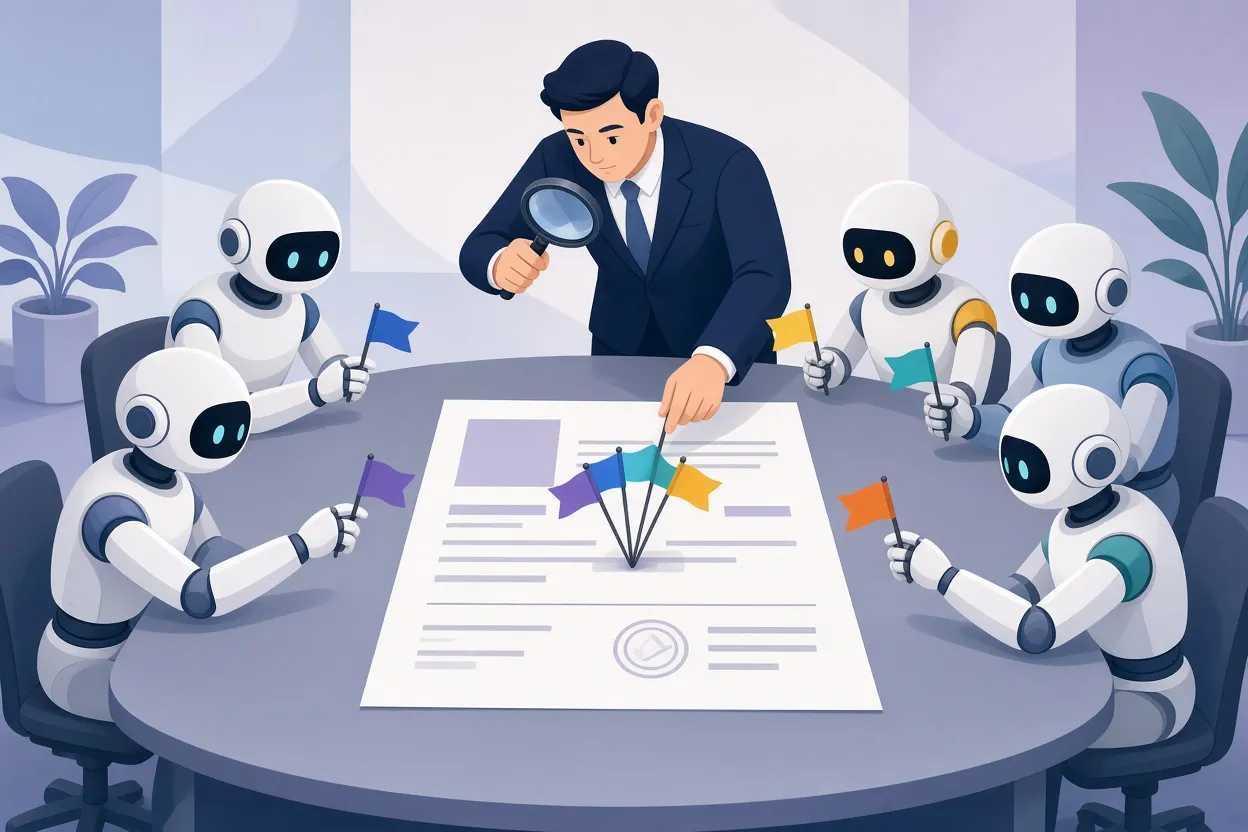
▲ 並列エージェントの削減主張の重複排除
並列エージェントの重複を排除する
削減機会の規模を見積もるため、5つのClaudeエージェントを並列で実行し、それぞれに1つのレバーを担当させました。冗長なサービス($40万)、使われていない契約($50万)、重複ベンダー($70万)、契約条件のアービトラージ($70万)、料率ベンチマーク($10万)で、単純合計は$290万です。しかし、エージェントは互いの作業を見られないため、複数のエージェントが同じ請求書明細行について削減を主張し、予測はおよそ$140万 ~ $150万ほど膨らんでいました。現在は後処理ハーネスが各発見の請求書明細行IDを突き合わせ、商務チームと合意した優先順位に基づいて1件につき1回しか計上できないルールを適用しているため、どの金額も一度しか数えられません。
ビジネスの文脈を与える
エージェントは上位30社のベンダーとの取引関係を並列で分析しました。人間のアナリストなら通常、1ベンダーあたり1日ほどかかる作業です。計算は正確でしたが、エージェントはコールセンター事業者の統合を提案しました。これは経営層が3か月前にすでに着手していたプロジェクトでした。進行中の施策や廊下での交渉は、どんなモデルにも見えません。現在は人間のアナリストが発見事項に案件の文脈を注記し、それが構造化されたルールセットに反映されて、以降の実行ではすでに進行中の施策が除外されるようになっています。
この事例から学ぶべきこと
この事例は2つの原則に集約できます。第1に、雑然としたデータを構造化するために前もってトークンとエンジニアリングの時間を費やすことは報われます。実行のたびにスキーマを再発見しなければならないエージェントは推論を浪費し、それでも見落としを残すからです。第2に、コンテキストウィンドウがどれほど大きくなっても、ビジネスの文脈は省略できません。
AIエージェントによる大量文書分析を計画しているチームに向けて、この事例から浮かび上がったチェックリストは次のとおりです。
- エージェントに見せる前に文書を構造化テーブルへ前処理する。複数ページのPDFから直接数値を集計するようモデルに求めない。
- 総額を書き直す修正契約、孤立した修正契約、長文文書のタイムアウト、見出しのない表の続きページを明示的に処理する。
- データは読み取り専用で、1回に1つのSQL文のみ実行でき、行数に上限のあるツール経由でのみ公開し、すべての呼び出しをログに記録する。
- 通知期間のロジックのようなビジネスルールはツールのコードに組み込み、必要な条項をすべてエージェントが取得したかをクエリログで検証する。
- 空の結果ではなく明示的な権限エラーを返し、エージェントが制限されたデータをゼロと取り違えないようにする。
- 並列エージェントの結果は請求書明細行IDのような細かいキーで、固定した優先順位に基づいて突合する。
- 文書に含まれていない業務上の文脈を補うため、人間をループに置き続ける。
最終的なアーキテクチャは簡潔に言い表せます。構造化データ、読み取り専用ツール、追跡可能な証拠に裏付けられた回答、ビジネスルールの自動レビュー、そして判断を下す人間です。確率的なモデルを決定論的なエンジニアリングで包み込むことこそが、もっともらしく見える答えを、根拠をもって説明できる答えへと変えたのです。


