咨询公司AlixPartners的一个团队让Claude Code处理一家企业并购后留下的4万多份供应商合同时,第一次得到的答案格式整洁、措辞笃定。然而在五个核心数字中,有两个是错的。由于一份修订协议始终没有与其主合同关联,智能体把合同总价值少算了$80万;它给出的续约通知截止日期是2026年12月1日,而合同实际要求在11月1日前发出通知。输出中没有任何迹象提示这两个问题。这个案例揭示了一种规律,任何把批量文档分析交给AI智能体的人都应有所预期:答案看起来越合理,就越需要仔细核查,而且核查必须用代码完成,而不是依靠提示词。
业务问题
此次项目涉及一家大型医疗企业,它收购了一家规模较小的专业化公司。采购部门接手了数百家相互重叠的供应商,以及分散在三个从未打通的数据库系统中的4万多份合同文件。没有人能一眼看清合并后的公司究竟向某一家供应商支付了多少钱。
为保护客户机密,团队搭建了一个合成的复刻场景:Harbor Health为收购方,Summit Health Plan为被收购方,Acme Health Services则是双方都在使用的供应商。合并前,Harbor每年通过两份合同向Acme支付$464万,Summit通过另外两份合同支付$306万,两家合计$770万,分布在四份有效合同中,且没有任何共同条款。
采购部门的管理层想要两件事:一是弄清合并采购量能否换来更优惠的价格或返利;二是在任何一份合同触发自动续约之前,拿到一份精确的重新谈判时间表。标准很严格:每一个数字都要经得起供应商的质询,并能追溯到具体的合同页码和发票行。
第一次运行错在哪里
最初的测试是直接向Claude Code提问,要求它分析公司与Acme的合作状况。智能体正确识别出四份有效合同,并给出了合并后的年度支出数字。但对照源文件审核后,发现了两个严重错误:
| 指标 | 智能体的答案 | 核实后的答案 |
|---|---|---|
| 当前合同总价值 | $1670万 | 约$1750万 |
| 下一个通知截止日期 | 2026年12月1日 | 2026年11月1日 |
少掉的$80万来自一份修订协议,其主合同字段为空,因此从未被汇总进总额。日期错误则更危险。智能体依据的是一条90天的终止条款,而同一份合同另一处的自动续约条款要求在2027年3月1日到期前120天发出通知。若按智能体给出的日期行事,公司将整整错过真正的截止日一个月,并触发一次不想要的自动续约。
真实合同为何会让简单解析失效
这些失误的根源在原始数据,而非智能体的推理。四类边缘情况反复出现:
- 篇幅极长的文件在预处理阶段超时,从未被索引,对智能体来说它们根本不存在。
- 索引未能把修订协议映射到其主服务协议(MSA,即约束整个合作关系的总括性合同)时,修订协议就成了"孤儿"。数十万美元的金额就这样凭空消失。
- 修订协议往往是重新声明合同总价值,而不是在原值上追加。一个简单的解析器把原始$400万的MSA与$600万、$700万的两份修订协议相加,得出$1700万,而实际上最后一份修订协议已把总额重置为$700万。
- 费率表跨页时不重复列标题,导致后续页面在光学字符识别(OCR,将扫描页面转为文本的技术)时缺乏上下文。
团队没有让语言模型直接解读原始PDF,而是花了两周时间搭建一条专用流水线,在任何智能体接触文件之前先把文档结构化。流水线建成后,一夜之间就处理完了整个文档库,而此前估计这项工作需要一个10人审阅团队耗时数周。
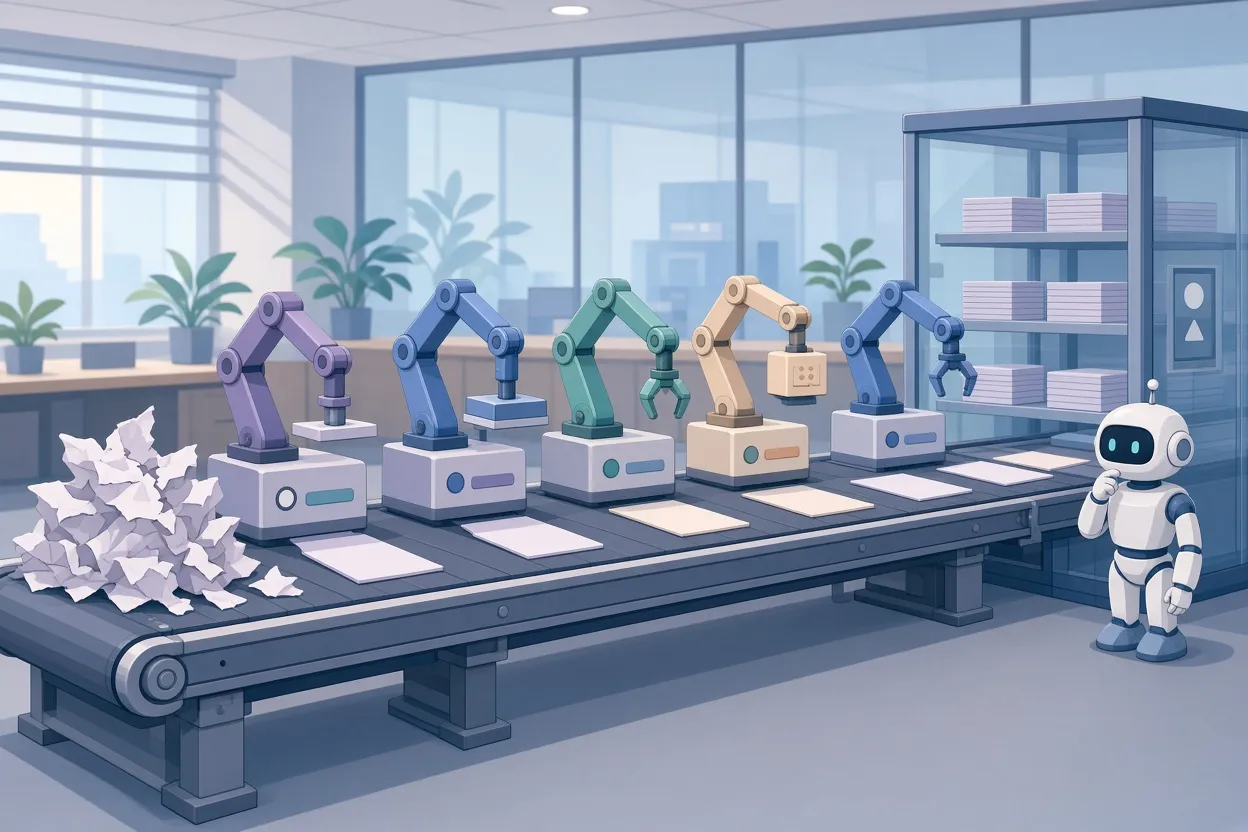
▲ 分析前结构化合同的五阶段流水线
五阶段流水线
流水线分五个阶段依次运行:
- 预处理:使用文档智能工具、OCR以及DSPy(一个用于以编程方式优化提示词和语言模型流水线的框架)。
- 分类:把每份文件归为MSA、工作说明书(SOW)、修订协议或保密协议。
- 提取:抽取合同条款、费率分档和历史支出,并通过统一的对照表在三个数据库之间完成核对。
- 映射:把SOW中描述的服务归入标准的企业支出类别。
- Claude Code分析智能体:通过定制工具查询由此得到的结构化数据。
有一个细节对提取质量至关重要。阶梯式采购量返利等条款常常只以图表形式出现,OCR往往能识别出刻度线和金额门槛,却丢失了返利百分比曲线。团队把这些页面转成图像,利用DSPy配合多模态模型调用,输出带类型定义的结构化对象,逐项列出每个支出门槛及其对应的返利百分比。预先定义好数据结构,比自由形式的读取得到的结果更稳定;不过多模态提取技术变化很快,今天的做法可能在六到十二个月内就会过时。
先把数据结构化还有第二个作用:合同条款一旦进入数据库表,团队就能用自动化测试脚本来验证智能体的答案。
通过MCP工具实现受控访问
数据仓库填充完毕后,Claude Code始终不被允许直接接触原始表。它只能通过基于模型上下文协议(MCP,一种把AI智能体连接到外部工具和数据的标准)暴露的定制工具来查看数据。MCP集成大约花了三天时间构建。工具包括execute_sql、list_tables、get_rate_card_page、get_amendment_chain和get_vendor_spend,每个工具都可以内置业务逻辑,否则智能体就得每次自己重新摸索。
限制由服务器端强制执行,而不是指望提示词来约束:
- 连接为只读。
- 每次调用只能执行一条SQL语句。
- 结果上限为1,000行,以免撑爆智能体的上下文窗口。
- 未经授权的操作在到达数据库之前即被拒绝。
- 每一次工具调用和查询都有日志记录,任何错误都可以确定性地重放。
选择Claude Code作为智能体,是因为它擅长探索和推理杂乱的代码库,而一个由合同和支出表构成的仓库,实际上与代码库颇为相似。
来自生产环境的五条经验
把截止日期规则写进代码
12月1日的错误之所以发生,是因为终止条款和续约条款位于合同的不同部分,而依赖智能体同时正确读取两者,会让错误率叠加。解决办法是一个测试框架:它检查查询日志,标记出任何只查了终止条款文本却没有同时查续约条款的运行。发现遗漏后,它把任务退回给智能体,让其提取引用的条款原文,然后用确定性代码计算日期,而不是让模型去估算。
修复合同层级关系
合同生命周期管理系统本应保持MSA、SOW和修订协议之间的关联,但实际上很少得到妥善维护。在这个案例中,编号为INTAKE-2026-6447的修订协议把Summit的一份合同从$540万续签至$620万,但其主合同ID为空,因此报表忽略了它。团队增加了一个辅助的Claude流程,读取未关联的修订协议,从中寻找指向主合同的引用。随后由确定性检查确认候选主合同确实出现在搜索结果中,且提取的引文与文件原文逐字一致,之后才正式写入关联。关联修订协议后,估值从$1670万升至$1740万,最终达到$1750万。
让权限失败"大声报错"
在整合支出的过程中,智能体得出结论:Summit与Acme之间的支出为$0,而真实数字是$3,064,117,Harbor则为$4,635,096。Summit发票表上的行级安全策略返回了空结果集却不抛出错误,智能体便把"空"当成了"零"。团队重写了工具,使其能区分空结果与访问受限,并在权限阻止数据检索时返回有信息量的反馈,同时提供通往经批准的汇总视图的备用路径。
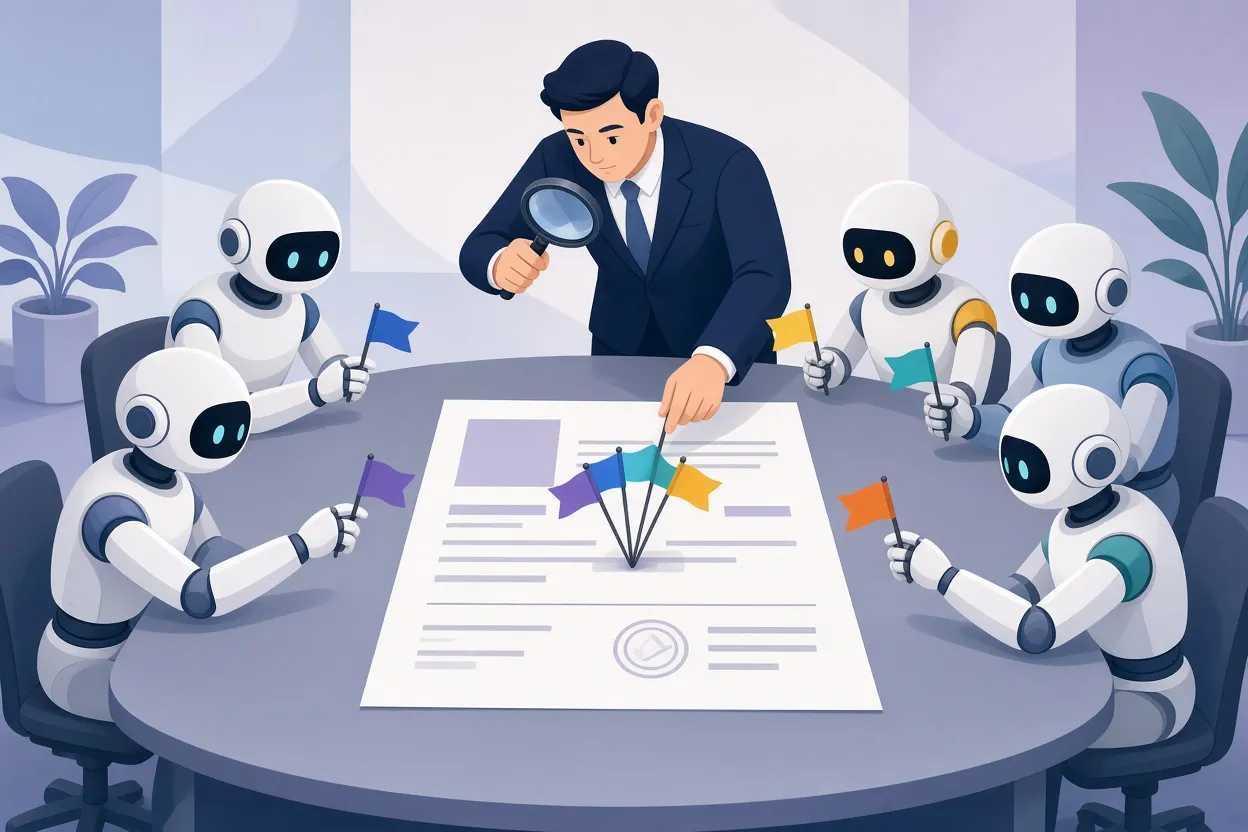
▲ 并行智能体节省额的去重
对并行智能体去重
为了估算节省空间,五个Claude智能体并行运行,各自负责一个抓手:冗余服务($40万)、失效合同($50万)、重复供应商($70万)、条款套利($70万)和费率对标($10万),简单相加为$290万。由于各智能体看不到彼此的工作,有几个在同一批发票行上重复主张了节省额,使预测虚高了约$140万-150万。现在,一个后处理框架会在各项发现之间匹配发票行ID,并按照与商务团队商定的优先级顺序执行"单一主张"规则,确保每一美元只计一次。
注入业务背景
智能体并行分析了前30大供应商关系,这类工作通常需要人类分析师每家供应商花费约一天。它的计算没有问题,却建议整合呼叫中心供应商,而这个项目管理层三个月前就已经启动。任何模型都看不到进行中的举措或走廊里的谈判。现在由人类分析师为分析结果标注交易背景,这些标注汇入一套结构化规则集,让后续运行自动过滤掉已在推进的举措。
从中可以学到什么
两条原则可以概括这个案例。第一,前期投入token和工程时间来结构化杂乱数据是值得的,因为一个每次运行都要重新摸索数据结构的智能体,既浪费推理能力,又照样会遗漏。第二,无论上下文窗口变得多大,业务背景都不是可有可无的。
对于计划用AI智能体做批量文档分析的团队,从中总结出的清单如下:
- 在智能体接触文档之前,先把文档预处理成结构化表格;不要让模型直接从多页PDF中汇总数字。
- 明确处理重新声明总值的修订协议、孤立的修订协议、长文档超时以及无表头的跨页表格续页。
- 只通过只读、单语句、限制行数的工具暴露数据,并记录每一次调用。
- 把通知期逻辑等业务规则写进工具代码,再通过查询日志验证智能体是否检索了所需的每一条条款。
- 返回明确的权限错误而非空结果,避免智能体把受限数据误认为零。
- 用发票行ID等细粒度键,按固定优先级顺序对并行智能体的结果进行核对。
- 保留人工参与,补充文档中不包含的运营背景。
最终的架构一句话就能说清:结构化数据、只读工具、有可追溯证据支撑的答案、自动化的业务规则审查,再加上一个做出判断的人。用确定性的工程把概率性模型包裹起来,正是让一个看似合理的答案变成一个经得起推敲的答案的关键。


