AI agent가 내놓은 보고서가 깔끔하고 자신감 넘칠수록 더 조심해야 한다는 점을 보여 주는 사례가 있습니다. 글로벌 경영 컨설팅 기업 AlixPartners의 AI·데이터 조직은 합병 후 통합 과정에서 4만 건이 넘는 계약 문서를 분석하는 데 Claude Code를 agent(스스로 도구를 골라 쓰며 작업을 수행하는 AI)로 썼습니다. 첫 결과는 전문가가 쓴 것처럼 보였지만, 원본과 대조하자 핵심 수치 다섯 개 중 두 개가 틀려 있었습니다. 계약 총액에서 $80만이 사라졌고, 자동 갱신을 막기 위한 통지 기한은 실제보다 한 달 늦게 계산됐습니다. 어느 쪽도 경고 없이 조용히 틀렸습니다. 이 팀이 원인을 어떻게 찾고 어떤 구조로 막았는지는 기업 문서를 AI에게 맡기려는 조직 모두에게 참고가 됩니다.
상황: 합병으로 떠안은 4만 건의 계약과 세 개의 분리된 데이터베이스
대형 헬스케어 기업이 틈새 영역의 전문 기업을 인수했습니다. 구매 부서는 수백 곳의 중복 공급업체와 4만 건이 넘는 계약 문서를 한꺼번에 떠안았고, 두 회사의 계약과 지출 데이터는 한 번도 통합된 적 없는 세 개의 데이터베이스에 흩어져 있었습니다. 계약과 지출을 한눈에 볼 방법이 없었던 셈입니다.
AlixPartners는 고객 정보를 보호하기 위해 구조는 그대로 두고 이름과 수치만 바꾼 가상 사례로 문제를 설명합니다. 인수 기업 Harbor Health, 피인수 기업 Summit Health Plan, 두 회사가 공통으로 거래하는 공급업체 Acme Health Services가 등장합니다.
| 구분 | Acme 연간 지출 | 계약 수 |
|---|---|---|
| Harbor Health | $464만 | 2건 |
| Summit Health Plan | $306만 | 2건 |
| 합계 | $770만 | 4건 |
구매 부서가 답해야 할 질문은 두 가지였습니다. 두 회사의 지출을 합치면 Acme로부터 더 큰 할인이나 리베이트를 끌어낼 수 있는가, 그리고 어느 계약이 자동 갱신되기 전에 언제까지 재협상에 들어가야 하는가입니다. 기준은 엄격했습니다. 공급업체 앞에서 제시하는 모든 숫자는 계약서의 해당 페이지와 invoice(송장) 항목으로 뒷받침할 수 있어야 했습니다.
첫 시도: 다섯 수치 중 둘이 조용히 틀렸다
팀은 먼저 Claude Code에 Acme와의 거래 현황을 분석하라고 지시했습니다. 결과는 표로 잘 정리돼 있었고, 연간 지출 합계와 활성 계약 4건이라는 수치는 맞았습니다. 하지만 원본 기록과 대조하자 두 수치가 틀려 있었습니다.
| 항목 | agent의 답 | 실제 값 | 원인 |
|---|---|---|---|
| 현재 계약 총액 | $1,670만 | 약 $1,750만 | 상위 계약과 연결되지 않은 $80만짜리 수정 계약 누락 |
| 통지 기한 | 2026년 12월 1일 | 2026년 11월 1일 | 해지 조항의 90일만 보고 자동 갱신 조항의 120일을 놓침 |
두 번째 오류가 특히 치명적입니다. 12월 1일을 믿고 움직였다면 통지 기한을 넘겨 원치 않는 계약이 자동으로 갱신됐을 것입니다. 어느 오류에도 "확실하지 않다"는 표시는 없었습니다. 정리되지 않은 기업 계약 문서를 그대로 넣으면 LLM agent는 불확실성을 드러내지 않고 조용히 틀린다는 것이 이 사례의 출발점입니다.
계약 문서가 AI를 넘어뜨리는 네 지점
왜 틀렸을까요. 팀이 실제 계약 파일에서 확인한 문제는 네 가지로 정리됩니다.
- 지나치게 긴 계약서: 처리 시간이 초과되어 전처리 단계에서 멈추고, 결국 데이터베이스에 색인되지 않은 채 남습니다. 있는 계약이 없는 계약이 됩니다.
- 고아가 된 수정 계약(amendment): 수정 계약이 원래의 기본 계약(MSA, Master Service Agreement)과 연결되지 않으면 수십만 달러가 계산에서 사라집니다. $80만 누락이 바로 이 경우입니다.
- 총액을 다시 쓰는 수정 계약: 기본 계약 $400만, 1차 수정 $600만, 2차 수정 $700만이 있을 때 단순 합산은 $1,700만을 내놓습니다. 그러나 마지막 수정 계약이 총액을 $700만으로 다시 정한 것이라면 정답은 $700만입니다. 더하는 수정인지 바꾸는 수정인지 구분해야 합니다.
- 페이지를 넘어가는 요금표: 복잡한 단가표가 페이지를 넘어가면서 열 제목이 반복되지 않으면, 다음 페이지의 숫자는 OCR(문서 이미지에서 글자를 읽어내는 기술)에게 맥락 없는 숫자 더미가 됩니다.
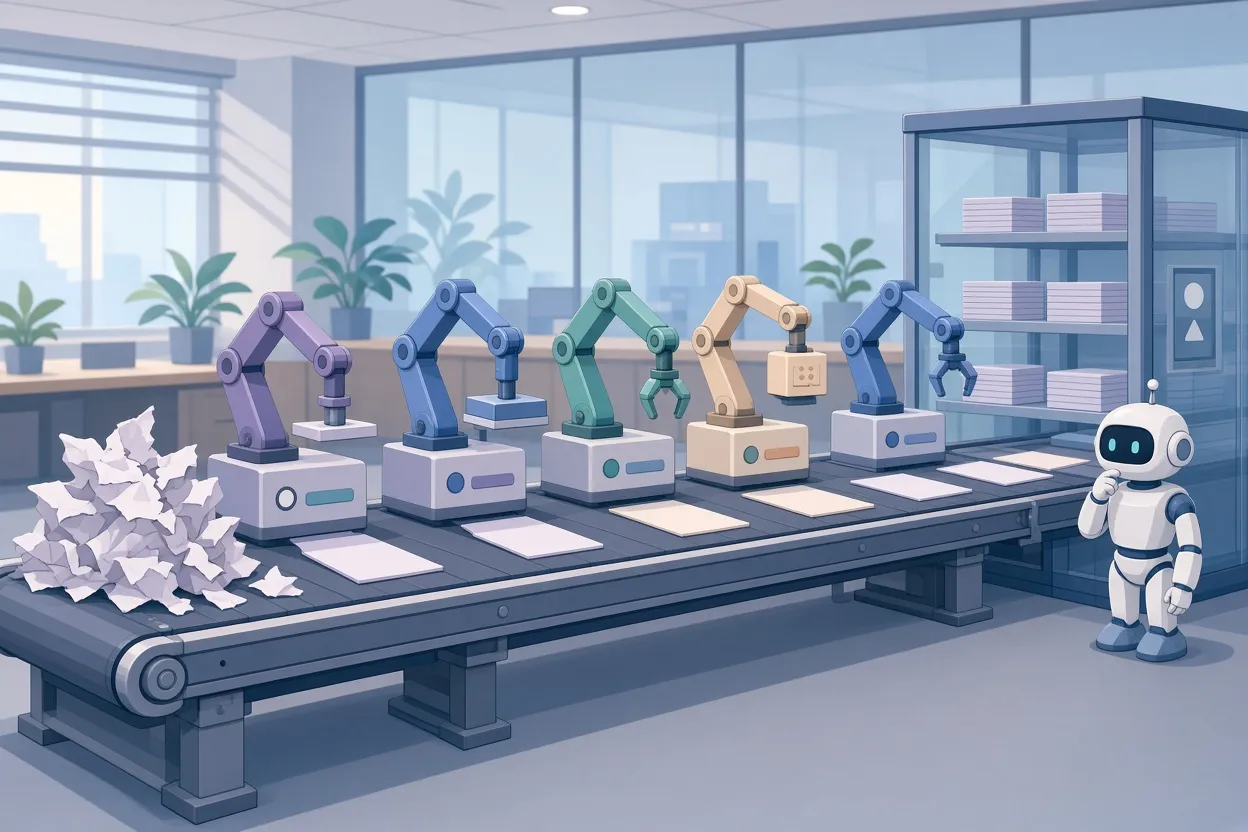
▲ 5단계 계약 구조화 pipeline
여기에 하나 더, 거래량에 따른 리베이트 비율 같은 핵심 조건이 글이 아니라 그래프로만 들어 있는 경우가 많았습니다. 전통적인 OCR은 눈금과 금액 기준점은 읽어도 리베이트 비율 곡선은 놓칩니다.
해법 1: agent에게 묻기 전에 2주를 들여 데이터를 구조화하다
팀의 결론은 LLM이 원본 PDF를 직접 해석하게 두지 않는 것이었습니다. 대신 2주를 들여 agent 앞단에 별도의 데이터 처리 pipeline(데이터를 여러 단계로 순서대로 가공하는 자동화 흐름)을 만들었습니다. 완성된 pipeline은 4만 건이 넘는 계약 문서를 하룻밤에 처리했고, 이는 10명이 몇 주를 매달려야 하는 수작업 검토를 대체한 것으로 추산됩니다.
| 단계 | 하는 일 |
|---|---|
| 1. 전처리 | 문서 인텔리전스 프레임워크, OCR, DSPy(LLM prompt와 pipeline을 프로그램으로 최적화하는 프레임워크) 활용 |
| 2. 분류 | 문서가 MSA, SOW(Statement of Work, 작업 명세서), 수정 계약, NDA(비밀유지계약) 중 무엇인지 판별 |
| 3. 조건·요율·지출 추출 | 세 개의 데이터베이스를 하나의 대응표로 맞춰 계약 조건, 요율 구간, 과거 지출을 추출 |
| 4. 서비스 분류 | SOW에 적힌 서비스를 표준 지출 범주로 매핑 |
| 5. 분석 agent | Claude Code가 직접 만든 MCP 서버를 통해 구조화된 데이터를 조회 |
그래프로만 있는 리베이트 조건은 계약 페이지를 이미지로 바꾼 뒤, DSPy와 multimodal(글과 이미지를 함께 이해하는) LLM 호출로 "지출 구간별 기준액과 리베이트 비율"이라는 정해진 형식(typed schema)의 데이터로 뽑아냈습니다. prompt만으로 원문을 읽게 하는 방식도 동작은 하지만, 출력 형식을 미리 고정해 두는 편이 일관된 품질을 보장한다는 것이 팀의 판단입니다. 다만 multimodal 추출 기법은 빠르게 바뀌어 지금의 방법이 6~12개월 안에 낡을 수 있다는 단서도 붙었습니다.
구조화된 테이블을 먼저 만든 데는 또 하나의 이유가 있습니다. 데이터가 테이블에 있어야 agent의 답을 자동 테스트 스크립트로 검증할 수 있기 때문입니다.
해법 2: 읽기 전용 도구만 쥐여 주고 모든 호출을 기록하다
데이터 웨어하우스가 채워진 뒤에도 Claude Code가 원본 테이블에 직접 접근하거나 임의의 쓰기 명령을 실행하는 일은 금지됐습니다. agent는 MCP(Model Context Protocol, AI가 외부 도구와 데이터에 연결되는 표준 규약)로 연결된 직접 만든 다섯 가지 도구로만 데이터를 봅니다.
- execute_sql: SQL 질의 실행
- list_tables: 테이블 목록 조회
- get_rate_card_page: 요금표 페이지 조회
- get_amendment_chain: 수정 계약의 연결 관계 조회
- get_vendor_spend: 공급업체별 지출 조회
도구를 직접 만들면 업무 규칙과 도메인의 미묘한 차이를 prompt가 아니라 도구 코드 안에 심을 수 있습니다. prompt 지시보다 훨씬 확실하게 강제됩니다. 서버 쪽 제약은 다음과 같았습니다.
- 연결은 읽기 전용
- 호출당 SQL 문장 하나
- SQLite 조회 결과는 최대 1,000행(prompt가 넘치는 것을 방지)
- 허용되지 않은 작업은 데이터베이스에 닿기 전에 차단
- 모든 도구 실행과 질의를 감사 기록으로 남겨 오류를 그대로 재현 가능
어떤 도구를 쓸 수 있는지는 설정 파일의 허용 목록으로 관리합니다. 이 MCP 서버 연결부를 만드는 데는 3일이 걸렸습니다. Claude Code를 agent 핵심으로 고른 이유도 눈여겨볼 만합니다. 지저분한 코드베이스를 스스로 탐색하고 해석하는 데 강한데, 표 형태의 계약·지출 저장소를 뒤지는 일이 그와 닮았다고 본 것입니다.
운영하며 드러난 다섯 가지 실패와 수정
구조화와 도구 통제로 끝이 아니었습니다. 실제 운영에서 다섯 가지 실패가 더 나타났고, 각각에 코드로 된 검증 장치가 붙었습니다.
1. 해지 조항과 갱신 조항을 혼동한 통지 기한
계약 만료일은 2027년 3월 1일이었습니다. agent는 해지 조항의 90일을 적용해 12월 1일을 답했지만, 자동 갱신 조항은 120일 전 통지를 요구하므로 정답은 11월 1일이었습니다. 두 조항이 계약서의 다른 위치에 있어 prompt 이해에만 기대면 오류가 쌓입니다. 팀은 질의 기록을 검사하는 test harness(결과를 자동으로 점검하는 검증 장치)를 만들었습니다. 해지 조항만 보고 갱신 조항을 확인하지 않은 질의를 잡아내면 agent에게 해당 조항을 인용해 다시 가져오게 하고, 날짜 계산은 LLM이 아니라 코드가 수행합니다.
2. 부모가 없는 수정 계약, $80만
기업의 계약 수명주기 관리(CLM) 시스템은 MSA와 SOW의 구조를 유지하도록 만들어졌지만 실제로는 관리가 잘 되지 않는 경우가 대부분입니다. 문제의 수정 계약(INTAKE-2026-6447)은 Summit의 계약을 $540만에서 $620만으로 갱신했는데, 부모 계약 ID가 비어 있어 보고 시스템이 무시했습니다. 해결책은 상향식 연결 복구입니다. 별도의 Claude 프로세스가 연결되지 않은 수정 계약의 본문을 읽어 부모 계약 참조를 찾고, 결정론적 코드가 그 부모가 실제 검색 결과에 있는지와 인용문이 원문과 한 글자도 다르지 않은지 확인한 뒤에야 연결을 확정합니다. 이렇게 연결을 복구하자 계약 총액은 $1,670만에서 $1,740만, 다시 $1,750만으로 올라갔습니다. M&A 시너지 모델에서 가치가 새어 나가는 것을 막은 셈입니다.
3. 권한 때문에 비어 있던 결과를 0으로 읽다
지출을 합산할 때 agent는 Summit의 Acme 지출이 $0라고 결론 내렸습니다. 실제로는 약 $306만이었습니다. Summit의 invoice 테이블에 행 수준 보안(row-level security, 사용자 권한에 따라 볼 수 있는 행을 제한하는 기능)이 걸려 있어 질의가 오류 없이 빈 결과만 돌려준 것입니다. agent는 "접근 거부"가 아니라 "빈 행"을 받았기 때문에 지출이 없다고 믿고 다음 계산을 이어갔습니다. 팀은 도구가 빈 결과와 권한 제한을 구분해 알려 주도록 바꾸고, 원본 테이블이 막혀 있으면 승인된 집계 뷰나 다른 권위 있는 데이터베이스로 우회하도록 했습니다.
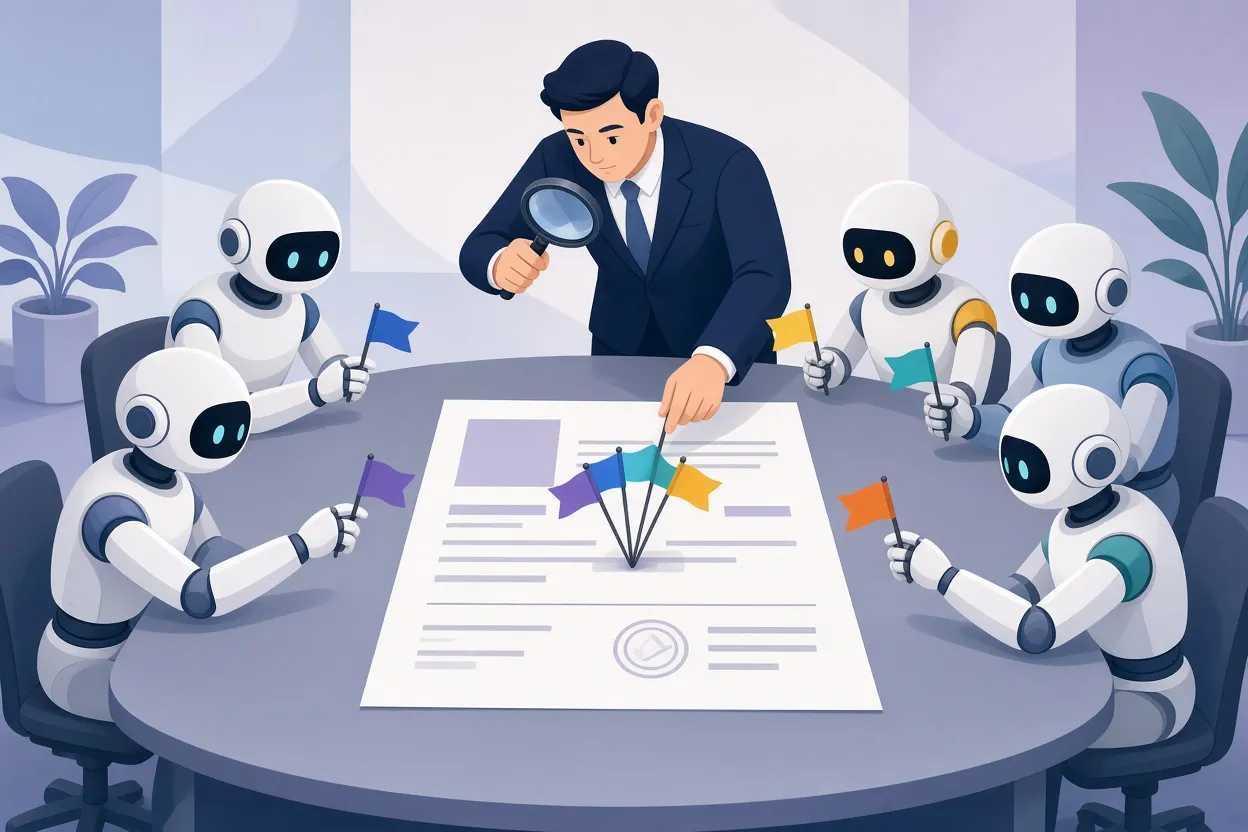
▲ 병렬 agent 결과의 중복 제거
4. 병렬 agent 다섯이 같은 돈을 여러 번 세다
절감 기회를 찾기 위해 Claude agent 다섯을 병렬로 띄워 각각 중복 서비스, 효력 없는 계약, 중복 공급업체, 계약 조건 차익, 요율 benchmark를 맡겼습니다. 단순 합계는 $290만이었습니다.
| agent | 주장한 절감액 |
|---|---|
| 중복 서비스 | $40만 |
| 효력 없는 계약 | $50만 |
| 중복 공급업체 | $70만 |
| 계약 조건 차익 | $70만 |
| 요율 benchmark | $10만 |
문제는 agent들이 서로를 보지 못한 채 같은 invoice 항목을 두고 각자 절감을 주장했다는 점입니다. 그대로 두면 $140만~150만이 부풀려집니다. 팀은 후처리 조정 장치를 두어 결과들의 invoice 항목 ID를 대조하고, 상업 팀과 합의한 우선순위(예: 해지 > 통합 > 재협상)에 따라 한 항목은 한 번만 계산되도록 했습니다. 이 조정 단계는 규칙을 정해진 순서로 적용하는 pipeline처럼 동작해 어떤 달러도 두 번 세지 않습니다.
5. 수학은 맞았지만 회사 사정을 몰랐다
agent는 상위 30개 공급업체 관계를 동시에 분석해 시간당 단가, 계약상 최소 약정, 상업 조건을 기준으로 절감 규모를 산정했습니다. 사람이 하면 공급업체 하나에 꼬박 하루가 드는 작업입니다. 그런데 콜센터 공급업체를 통합하라는 제안이 나왔고, 경영진은 이미 석 달 전부터 그 프로젝트를 진행 중이었습니다. agent는 진행 중인 사내 프로젝트, 기록되지 않은 복도 협상, 표면 금액과 다른 실제 운영 약정을 알 수 없습니다. 팀은 분석가가 초기 결과에 거래 맥락을 주석으로 달고, 이를 구조화된 규칙 집합에 쌓도록 했습니다. 이후 실행에서는 이미 진행 중인 과제가 자동으로 걸러져 token(LLM이 처리하는 글자 단위)을 아끼고 경영진 앞에서의 신뢰도 지킵니다.
기업 문서 분석을 AI에게 맡기기 전 점검 항목
이 사례의 실패들을 뒤집어 보면 그대로 점검표로 쓸 수 있을 것으로 보입니다.
| 점검 질문 | 놓치면 생기는 일 |
|---|---|
| 원본 PDF를 LLM에 바로 넣고 있지 않은가 | 긴 문서 누락, 페이지 넘김 요금표 오독 |
| 수정 계약이 부모 계약과 연결되어 있는가 | 연결 없는 수정 계약 하나로 $80만 누락 |
| 수정 계약이 금액을 더하는지 다시 쓰는지 구분하는가 | $700만을 $1,700만으로 계산 |
| 서로 다른 조항(해지와 갱신)을 모두 확인했는지 기록으로 검사하는가 | 통지 기한 한 달 오차 |
| 도구가 빈 결과와 권한 거부를 구분해 돌려주는가 | 약 $306만을 $0로 읽음 |
| 병렬 agent 결과를 고유 키(invoice 항목 ID)로 중복 제거하는가 | $140만~150만 부풀림 |
| 진행 중인 사업과 거래 맥락을 규칙으로 넣고 있는가 | 이미 하는 일을 다시 제안 |
| 모든 도구 호출이 기록되어 재현 가능한가 | 오류 지점을 추적할 방법이 없음 |
핵심 정리와 독자가 할 일
AlixPartners가 꼽은 원칙은 두 가지입니다. 첫째, 앞단에서 token을 써서 데이터를 구조화하는 투자는 크게 보답합니다. 지저분한 입력을 먼저 정리해 두면 agent가 매번 데이터 구조를 다시 발견하느라 추론 token과 context window(모델이 한 번에 다룰 수 있는 입력 범위)를 낭비하지 않습니다. 둘째, 업무 맥락은 무엇으로도 대체되지 않습니다. context window가 1억 token으로 커지고 추론 모델이 발전해도 회사 안에서 벌어지는 일과 도메인의 안전장치를 모델이 스스로 알 수는 없습니다.
최종 구조는 다섯 층입니다. 구조화된 데이터, 읽기 전용 도구, 근거가 붙은 답, 규칙 기반의 업무 검토, 그리고 판단을 내리는 사람입니다. 확률적인 LLM 추론 단계를 결정론적인 소프트웨어 공학으로 감쌀 때 통제된 agent가 성공한다는 것이 이 사례의 결론입니다.
기업에서 AI agent에게 대량 문서 분석을 맡기려 한다면 다음부터 시작해 볼 수 있습니다.
- 작은 표본을 골라 agent의 답을 원본과 손으로 대조해 보고, 틀린 항목이 어떤 유형인지 분류합니다. 답이 그럴듯할수록 더 꼼꼼히 봅니다.
- 문서를 구조화된 테이블로 만드는 단계를 agent 앞에 둡니다. 그래야 검증 스크립트를 쓸 수 있습니다.
- agent의 데이터 접근을 직접 만든 읽기 전용 도구로 제한하고, 업무 규칙은 prompt가 아니라 도구 코드에 넣습니다.
- 모든 호출을 기록하고, 기록을 검사하는 자동 검증 장치를 만들어 필수 확인(갱신 조항, 부모 계약, 권한 상태)을 빠뜨린 질의를 되돌려 보냅니다.
- 사람이 거래 맥락을 규칙으로 계속 추가하는 절차를 운영에 포함합니다.
AI의 보고서가 깔끔해 보이는 것과 숫자가 맞는 것은 다른 문제입니다. 이 사례에서 두 차이를 메운 것은 더 큰 모델이 아니라 구조화된 데이터, 통제된 도구, 그리고 코드로 쓴 검증이었습니다.


