在让AI智能体写代码之前先写下具体示例,再让智能体按经典的测试驱动循环推进,所产出的代码在正确性和整洁度上都远胜于被称为"氛围编程"(vibe coding)的松散提示方式。这是IT咨询公司codecentric的两位顾问开发的EXACT工作流得出的核心结论,并有模型从未见过的任务上的基准测试结果作为支撑。在其中一项任务上,Claude Opus 5根据文字描述的正确率为27%,而根据示例映射则达到94%;在另一项任务上,正确率从15%跃升至100%。
氛围编程为何会出问题
这套工作流源于技术大会上的实验和真实客户项目中的实践。codecentric团队反复观察到的模式是:无结构的氛围编程能快速交付代码,但代码很少真正符合用户的本意,而且存在严重的质量缺陷。他们的应对不是放弃AI智能体,而是改造沿用已久的工程技术——测试驱动开发(TDD)和重构——让它们来引导模型,而不是被跳过。EXACT这个名字有意呼应了这一目标:得到的正是想要的行为,而不是一个近似。
一个相关的理念为整套方法提供了框架。Daniel Terhorst-North和Matt Wynne曾提出,TDD更应被理解为"示例引导开发"(Example-Guided Development),这一总称同样涵盖验收测试驱动开发、行为驱动开发和实例化需求。这一论点与大语言模型(LLM)格外契合:给它们具体示例,远比给抽象或理论化的需求描述效果好得多。
EXACT工作流的五个阶段
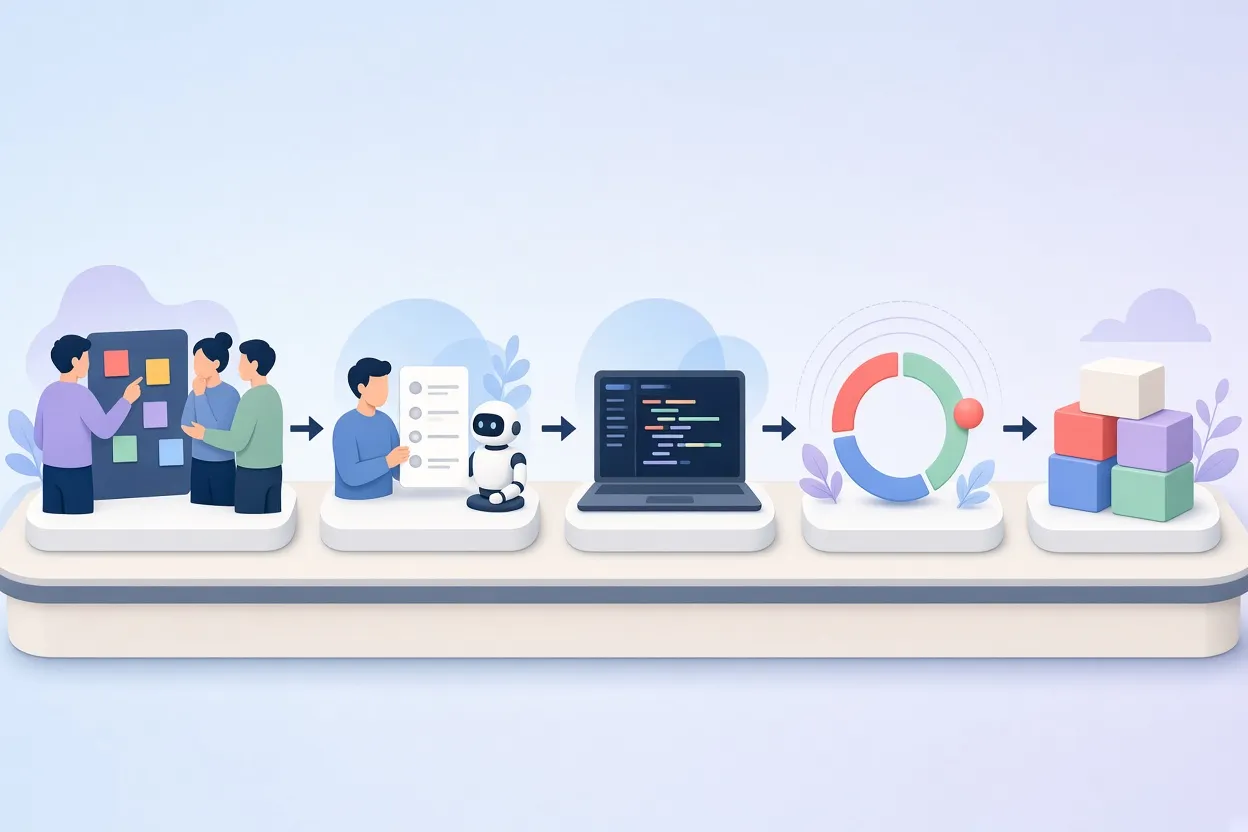
▲ EXACT工作流的五个阶段
EXACT由五个相互衔接的阶段依次构成,从人与人的对话一步步走向可执行的代码。
- 示例映射(Example Mapping)。 由Matt Wynne创立的协作建模技术,团队把一个用户故事拆解成规则和具体示例,写在便利贴上。这一阶段完全由人完成,目的是快速建立共享的心智模型。
- 规格 / 测试清单。 映射出的示例变成一份自然语言的测试清单,呼应Kent Beck的Canon TDD理念:维护一份不断更新的场景核对表。在这里,工程师通过EXACT编码框架(harness)直接与LLM协作,模型的任务是审视这份清单:找出遗漏的边界情况、被忽视的组合,以及示例从未覆盖的场景。
- 测试实现。 清单中的条目逐一转化为真实的测试。
- TDD内循环。 智能体在红(写一个失败的测试)、绿(让它通过)、重构(在不改变行为的前提下整理代码)之间循环。
- 实现。 循环逐条推进,直到得到可运行的实现。
工作流的前半部分关乎理解、协作和对话,而非厚重的文档。借自领域驱动设计的技术,如事件风暴(EventStorming)和领域故事讲述(domain storytelling),与示例映射并列,都是在向智能体发出提示之前澄清行为的手段。重点是把思考前移,避开那个熟悉的陷阱:等代码写完了,才去审查一个庞大的拉取请求。
在模型从未见过的任务上衡量效果
为了严格检验这套工作流,codecentric团队搭建了一个实证实验室,可跨不同的LLM、框架和编程语言运行。两项设计选择让结果具有可信度。第一,他们编写了全新的代码练习题(code kata,即小型练习问题),确保基准测试题目不可能已存在于模型的训练数据中。第二,他们保留了一套对AI隐藏的、全面的私有验收测试,用它独立评估正确性。
第一组对比把基于文字描述的提示(典型的氛围编程输入)与示例映射放在一起,两者都在EXACT工作流中运行于Claude Opus 5,每个单元格运行六次。
| 全新任务 | 文字描述正确率 | 示例映射正确率 | 提升 |
|---|---|---|---|
| Claim Office | 27% | 94% | +67个百分点 |
| Sphinx Score | 15% | 100% | +85个百分点 |
该团队报告称,在他们的各个测试用例中,示例映射稳定地把正确率提高60、70或80个百分点,有时还更多。给出的解释很直接:示例确立了精确的约束和清晰的预期,而文字描述则让模型只能靠猜。
为什么写更多Markdown解决不了问题
codecentric的顾问们做了一个对比:一边是为自己打造工具的团队,比如Claude Code团队,其需求天然就是直觉化的;另一边是顾问们通常工作的企业环境。在银行、保险或电商领域,开发者很少是原生的领域专家,而纯以文字传达的功能需求本质上就是模糊的。
这也是他们对规格驱动开发框架(如GitHub上的BMAD)的批评。这类框架靠生成多阶段的Markdown架构规格而流行起来。在他们看来,增加几页Markdown文字并不能消除底层的模糊性。没有具体示例,规格驱动开发就继承了与任何其他文字需求相同的弱点。
朴素TDD与结构化TDD
第二项基准测试深入内循环内部。在TypeScript版本的Claim Office任务上,运行Claude Opus 5.5的Claude Code以三种方式各测试五次,每种变体的正确率都至少达到96%。朴素TDD指的是一条简单的提示词,只是告诉模型去做TDD,几乎不给任何指导。
| 指标 | 朴素TDD | EXACT Coding | EXACT + 重构智能体 |
|---|---|---|---|
| 认知复杂度(最大值) | 7.6 | 2.4 | 2.0 |
| 最长函数(行数) | 26.2 | 13.0 | 14.2 |
| 变异得分 | 0.76 | 0.94 | 0.95 |
| 单次运行成本 | $1.31 | $9.79 | $28.34 |
认知复杂度衡量一段代码有多难读懂,变异得分衡量测试套件捕捉故意注入的缺陷的能力,所以这一行越高越好;其他各行则越低越好。结构化工作流把峰值认知复杂度削减了约三分之二,最长函数缩短一半,变异得分逼近上限。代价是成本:EXACT Coding单次运行的价格约为朴素TDD的七倍,再加上专门的重构智能体,又大约再翻三倍。
重构智能体的价值取决于模型代际。在较早的Claude Opus 4.6上,独立的重构子智能体带来了非常大的质量提升。到了Claude Opus 5.5,差距已经缩小,这让额外开销在该模型上更难说得过去。
上下文干净的子智能体
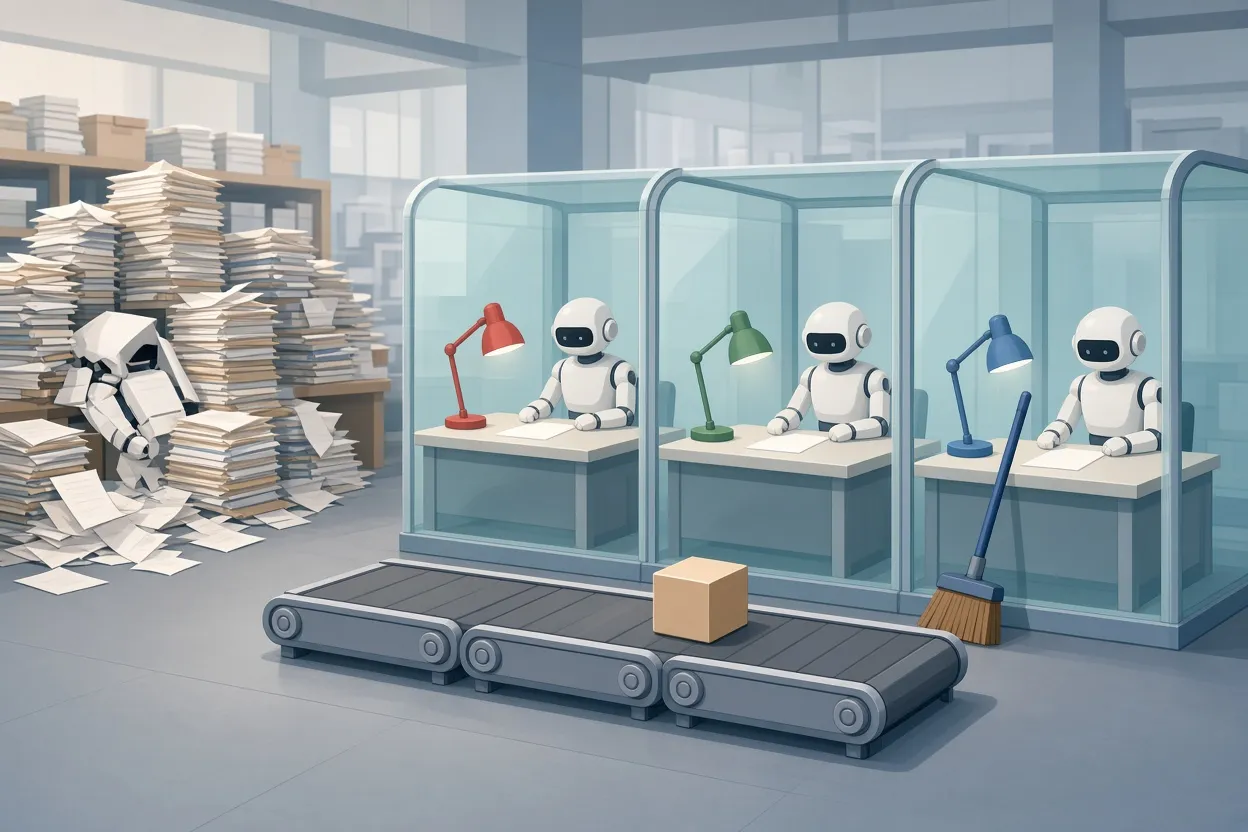
▲ 每个TDD阶段独立的子智能体上下文
这个实验室最初只有一条TDD提示词,当时Claude Code还没有技能和工具。随着上下文窗口变长,性能出现下降,团队把这一现象与斯坦福大学的论文《Lost in the Middle: How Language Models Use Long Contexts》联系起来。该论文的发现是:LLM最擅长从长上下文的最开头和最末尾检索信息,而常常漏掉或忽视处于中间的内容。
提出的补救办法是把TDD的各个独立阶段拆分给专门的子智能体,每个子智能体都拥有全新、隔离的上下文窗口,这样指令保持清晰,不会被之前的所有内容稀释。用于验证这一想法的研究框架只花了一个周末就搭建完成,上面的基准测试正是运行它的结果。
预测式TDD:让智能体先承诺再运行
工作流的一个核心机制是预测式TDD,这一理念因一款桌面TDD游戏而流行,并在Cyber-Dojo平台上得到实践。规则是:在执行任何TDD步骤之前,实践者(无论是人还是LLM)必须预测确切的结果。在红色步骤中,智能体必须在发出测试运行命令之前,声明测试将会失败、指出确切原因,并预测预期的错误信息。
据称有两项好处。这种做法迫使模型与真实的运行时保持联系,而不是漂向看似合理的代码。同时它把当前的领域问题推到模型活跃上下文的最前端,考虑到"Lost in the Middle"效应,这正是把最重要的信息放在模型最能关注到的位置。
智能体需要多少监督
这没有统一答案,因为模型能力在不断变化,所以该框架把自主程度做成了可配置项。开发者可以检查每一个红、绿、重构阶段,可以定期介入(例如每三个测试之后或每轮重构之后),也可以让智能体完全自主运行。
工作流作者表达的个人偏好是积极留在循环中并随时纠偏,按他们的经验,这比放手执行的结果要好得多。更深层的原因在于,人必须先对领域和问题建立准确的心智模型,然后才能委派;智能体无法弥补有缺陷的规格,因此在任何非平凡的任务上,人的引导看来都不可或缺。
其中一位顾问开玩笑说,他的同事花了20年试图把TDD教给人类,而LLM终于成了那个肯听话、并系统地执行这套纪律的学生。开发者无需事先深度精通TDD就能开始使用这个框架;与它协作本身就是学习这些原则的途径。有经验的实践者还可以更进一步,把领域启发式规则和定制的测试约束直接注入提示词。
结论与可尝试的做法
codecentric实验室的证据指向同一个方向:在编码智能体时代,久经验证的工匠实践并未过时,它们正是让智能体产出保持正确、可维护的制衡力量。具体示例是提升正确性的主导杠杆,结构化TDD循环是提升代码与测试质量的杠杆,而代价以token计。
对于想要应用这套方法的团队:
- 在让智能体生成生产代码之前,先与相关方开一场示例映射会议,尤其是在开发者并非专家的领域。
- 把示例转化为自然语言测试清单,再让LLM审视其中遗漏的组合和边界情况。
- 按清单顺序在红-绿-重构循环中逐条推进,而不是交出一段多段落的文字提示。
- 指示智能体在运行每个测试之前,先预测它会通过还是失败、原因是什么,以及错误信息会是什么。
- 把重构隔离到单独的智能体或全新会话中;针对你所用的模型,权衡额外成本与收益。
- 根据任务调整监督力度:在不熟悉的架构领域密切关注每一次红到绿的转换,只有在信任这一模式之后才放松监督。
- 评估任何编码智能体时,构建带有隐藏测试套件的全新练习题,以免被记住的训练数据抬高结果。
完整的框架和测试实验室已在GitHub上以agentic_coding_lab为仓库名开源,作者正在撰写一本关于该方法的书,先出德文版,英文版正在编写中。


