AI agent에게 기능을 말로 설명하고 코드를 받아 보면 속도는 빠르지만, 정작 의도와 다르게 동작하거나 품질이 크게 떨어지는 경우가 많습니다. IT 컨설팅 회사 codecentric의 소프트웨어 아키텍트와 시니어 컨설턴트는 이런 vibe coding(요구 사항을 느슨한 말로 던지고 AI가 만든 코드를 그대로 받아 쓰는 방식)의 한계를 겪은 뒤, TDD(테스트 주도 개발)와 refactoring(동작은 그대로 둔 채 코드 구조를 다듬는 작업) 같은 전통적인 공학 기법을 AI agent에 맞게 다시 짠 EXACT라는 workflow를 만들었습니다. 핵심은 두 가지입니다. 코드를 짜기 전에 구체적인 예시부터 정리하고, 구현은 테스트를 앞세운 작은 루프로 돌리는 것입니다. 이들이 직접 만든 실험 환경에서 같은 모델에 산문 prompt를 줄 때와 예시를 줄 때를 비교하자 정확도가 27%에서 94%로, 다른 과제에서는 15%에서 100%로 올랐습니다.
vibe coding이 남긴 문제와 EXACT의 출발점
EXACT는 기술 콘퍼런스에서 진행한 실험과 실제 고객 프로젝트에서 출발했습니다. 통제 없이 vibe coding을 하면 코드는 빨리 나오지만, 사용자가 원한 것과 어긋나는 결과가 자주 나오고 코드 품질에도 심각한 결함이 생겼다는 것이 두 컨설턴트의 경험입니다. 이들은 LLM의 능력은 살리되 기준은 낮추지 않기 위해 TDD와 refactoring을 agent 작업에 맞게 다시 설계했고, 그 방법론을 몇 년에 걸쳐 다듬었습니다. 이름을 EXACT로 지은 것도 '대략 비슷한' 결과가 아니라 '정확히 원한' 동작을 얻겠다는 뜻을 담은 말장난입니다.
이들의 관점에서 AI 시대에 장인 정신에 가까운 기법들은 낡은 것이 아니라 오히려 더 필요한 균형추입니다. AI가 코드를 자율적으로 만들어 내는 환경일수록 TDD를 어떻게 다시 정의할지가 중요해진다는 것입니다.
예시가 산문보다 낫다는 생각
이 workflow의 바탕에는 Daniel Terhorst-North와 Matt Wynne이 주장해 온 생각, 곧 TDD는 '예시로 안내하는 개발(Example-Guided Development)'로 이해하는 편이 낫다는 관점이 있습니다. 이 관점은 ATDD(인수 테스트 주도 개발), BDD(행위 주도 개발), Specification by Example(예시로 명세하기) 같은 여러 실천법을 하나로 묶습니다. 그리고 agent형 AI 도구는 추상적인 요구 사항 설명보다 구체적인 예시를 받았을 때 훨씬 높은 성능을 낸다는 점에서, 이 관점이 LLM이 요구 사항을 처리하는 방식과 잘 맞는다는 것이 EXACT의 전제입니다.
EXACT workflow의 다섯 단계
EXACT는 사람끼리의 협업에서 시작해 자동화된 TDD 루프로 끝나는 다섯 단계로 구성됩니다.
| 단계 | 누가 하는가 | 내용 |
|---|---|---|
| 1. Example Mapping | 사람 | 사용자 스토리를 규칙과 예시, 질문으로 분해하는 협업 모델링 |
| 2. Specs / Test List | 사람과 LLM | 예시를 자연어 테스트 목록으로 옮기고 LLM이 빠진 경우를 점검 |
| 3. 테스트 구현 | LLM | 목록의 항목을 하나씩 실제 테스트 코드로 작성 |
| 4. TDD 안쪽 루프 | LLM(사람 확인 선택) | red-green-refactor를 반복 |
| 5. 구현 완료 | - | 목록을 모두 소화한 실행 가능한 구현 |
첫 단계인 Example Mapping(사용자 스토리를 규칙, 구체적 예시, 미해결 질문으로 쪼개 붙임쪽지로 정리하는 기법)은 Matt Wynne이 만든 것으로, 사람이 중심이 되는 작업입니다. 팀원들이 같은 그림을 빠르게 공유하게 만드는 것이 목적입니다. 두 컨설턴트는 여기에 더해 EventStorming이나 domain storytelling 같은 DDD(도메인 주도 설계) 기법으로 agent에게 prompt를 주기 전에 동작을 먼저 명확히 하라고 권합니다. 코드가 다 만들어진 뒤 거대한 pull request를 검토하느라 고생하는 대신, 생각을 앞 단계로 당기자는 것입니다.
두 번째 단계에서는 정리된 예시를 자연어 '테스트 목록'으로 옮깁니다. Kent Beck의 Canon TDD(테스트할 시나리오 목록을 먼저 적고 하나씩 처리해 나가는 TDD의 정석)에서 가져온 개념입니다. 이 단계부터 사람과 LLM이 EXACT coding harness(agent의 작업 순서와 규칙을 강제하는 실행 틀)를 통해 함께 일합니다. LLM은 목록을 검토해 빠진 edge case(경계 조건), 누락된 조합, 없는 시나리오를 찾아냅니다. 그다음에야 목록의 항목을 하나씩 테스트로 구현하면서 red(실패하는 테스트 작성), green(통과시키는 최소 구현), refactor(정리)를 도는 안쪽 루프에 들어갑니다.
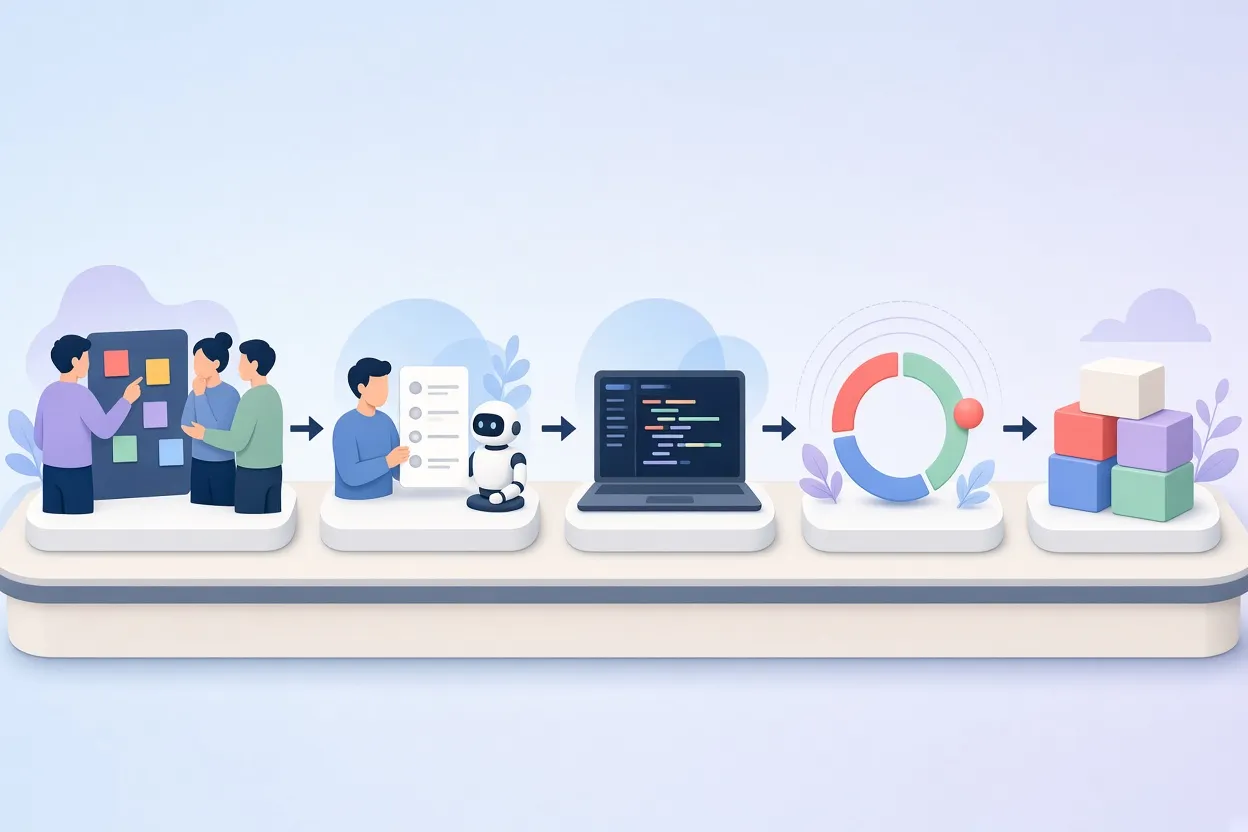
▲ EXACT workflow의 다섯 단계
산문 prompt와 Example Mapping의 정확도 차이
codecentric 팀은 이 workflow를 측정하기 위해 여러 LLM, harness, 프로그래밍 언어에 걸친 실험 환경을 만들었습니다. 중요한 점은 benchmark 과제를 새로 썼다는 것입니다. LLM의 학습 데이터에 이미 들어 있는 문제라면 외워서 푸는 결과와 실제 추론 능력을 구분할 수 없기 때문입니다. 정확도는 AI에게 완전히 숨겨 둔 인수 테스트 모음으로 따로 평가했습니다.
Claude Opus 5를 EXACT workflow 안에서 돌리고, 요구 사항을 산문으로 줄 때와 Example Mapping 결과로 줄 때를 비교한 수치는 다음과 같습니다. 각 칸의 실행 횟수는 6회입니다.
| 과제 | 산문 명세 | Example Mapping | 차이 |
|---|---|---|---|
| Claim Office | 27% | 94% | +67%p |
| Sphinx Score | 15% | 100% | +85%p |
다른 과제에서도 산문을 Example Mapping으로 바꾸면 정확도가 60%, 70%, 많게는 80% 이상 꾸준히 오른다고 합니다. 모호한 산문 prompt와 달리 예시가 정확한 제약과 분명한 기대치를 세워 주기 때문이라는 해석입니다.
Markdown 명세를 쌓는 spec-driven development와 다른 점
이 결과가 더 중요해지는 곳은 기업 환경입니다. Claude Code 개발팀처럼 자기 자신을 위한 도구를 만드는 팀은 요구 사항이 직관적으로 머릿속에 있습니다. 반면 은행, 보험, 전자상거래 같은 기업 프로젝트에서 개발자는 도메인 전문가가 아닌 경우가 대부분이고, 산문으로만 전달되는 기능 요청은 태생적으로 모호합니다.
최근 GitHub에서 인기를 얻은 BMAD 같은 spec-driven development 프레임워크는 여러 단계의 Markdown 아키텍처 명세를 만들어 내는 데 힘을 씁니다. 그러나 두 컨설턴트가 보기에 Markdown 산문을 몇 페이지 더 쌓는다고 요구 사항의 모호함이 사라지지는 않습니다. 구체적인 예시가 없다면 spec-driven development도 일반 산문 명세와 같은 모호함의 약점을 그대로 물려받는다는 것입니다.
안쪽 루프: Plain TDD와 EXACT의 코드 품질 비교
예시가 정확도를 끌어올린다면, TDD 루프의 구조는 코드 품질을 좌우합니다. Claude Code에서 Claude Opus 5.5로 TypeScript 과제 Claim Office를 세 가지 방식으로 각 5회 실행한 결과입니다. 세 방식 모두 정확도는 96% 이상을 충족했으므로, 여기서 비교하는 것은 '맞는 코드'를 전제로 한 품질입니다.
| 지표 | Plain TDD | EXACT Coding | EXACT + refactor agent |
|---|---|---|---|
| Cognitive complexity 최댓값(낮을수록 좋음) | 7.6 | 2.4 | 2.0 |
| 가장 긴 함수 길이(줄, 낮을수록 좋음) | 26.2 | 13.0 | 14.2 |
| Mutation score(높을수록 좋음) | 0.76 | 0.94 | 0.95 |
| 1회 실행 비용 | $1.31 | $9.79 | $28.34 |
Plain TDD는 "TDD로 하라"는 단순한 prompt만 주는 방식입니다. 비용은 회당 $1.31로 가장 싸지만, 함수는 길고 복잡도는 높으며 테스트 모음의 결함 탐지력을 뜻하는 mutation score(코드에 일부러 버그를 심었을 때 테스트가 잡아내는 비율)도 0.76에 그쳤습니다. EXACT Coding으로 바꾸면 복잡도가 7.6에서 2.4로, 가장 긴 함수가 26.2줄에서 13.0줄로 줄고 mutation score는 0.94로 오릅니다. 대신 token 비용이 $9.79로 약 7.5배 늘어납니다.
refactoring 전용 subagent(특정 단계만 맡는 별도의 agent)를 더하면 복잡도 2.0, mutation score 0.95로 조금 더 좋아지지만 비용은 $28.34로 다시 세 배 가까이 뜁니다. 두 컨설턴트에 따르면 Claude Opus 4.6 같은 이전 세대 모델에서는 이 refactor agent가 큰 폭의 품질 향상을 가져왔지만, Opus 5.5에서는 그 격차가 좁아졌습니다. 세 배의 비용을 들일지는 모델 세대와 과제에 따라 판단할 문제로 보입니다.
단계를 subagent로 나눈 이유: Lost in the Middle
실험 환경은 Claude Code에 skill이나 tool 같은 기능이 생기기 전, TDD prompt 명령 하나로 시작했습니다. 그런데 context window(모델이 한 번에 다루는 입력 범위)가 커질수록 성능이 떨어지는 현상이 관찰됐습니다. 여기서 참고한 것이 Stanford의 논문 'Lost in the Middle: How Language Models Use Long Contexts'입니다. 이 논문은 LLM이 긴 입력의 맨 앞과 맨 끝에 있는 정보는 잘 찾아내지만 중간에 있는 정보는 자주 놓치거나 무시한다는 것을 U자형 성능 곡선으로 보여 줍니다.
그래서 TDD의 각 단계를 서로 다른 subagent로 떼어 내고, 각 subagent가 깨끗한 새 context에서 일하게 했습니다. 지시가 희석되지 않고 날카롭게 유지되도록 하기 위해서입니다. 이 가설을 검증하기 위한 연구용 harness는 주말 하나를 들여 만들어졌고, 위 표의 결과가 그 검증의 일부입니다.
▲ 단계별 subagent 분리
예측형 TDD: 실행하기 전에 결과를 말하게 한다
EXACT의 또 다른 핵심 장치는 예측형 TDD입니다. TDD 학습용 보드게임과 연습 플랫폼 Cyber-Dojo에서 쓰이던 아이디어로, 규칙은 하나입니다. TDD의 어떤 단계든 실행하기 전에 사람이든 LLM이든 정확한 결과를 먼저 예측해야 합니다.
red 단계에서 실패하는 테스트를 쓸 때, LLM은 이 테스트가 실패할 것이라는 점, 정확히 어떤 이유로 실패하는지, 어떤 오류 메시지가 나올지를 명시적으로 선언해야 합니다. 이렇게 하면 모델이 코드의 실행 환경을 실제로 이해하고 있는지, 현실과 맞닿아 있는지가 매번 확인됩니다. 사람 개발자에게도 같은 효과가 있는 훈련입니다. 또 실패를 예측하는 행위 자체가 지금 풀어야 할 도메인 문제를 context의 맨 앞으로 끌어와, 코드 생성에 쓰이는 attention을 그 문제에 집중시킨다는 설명입니다.
실제 prompt에서는 "테스트를 실행하기 전에 통과할지 실패할지, 실패한다면 왜, 어떤 오류 출력이 나올지 먼저 적어라"라고 지시하는 식으로 적용할 수 있습니다.
사람은 어디까지 개입해야 하나
agent가 얼마나 많은 감독을 필요로 하는지에 대해 두 컨설턴트는 보편적인 정답이 없다고 말합니다. 모델의 능력이 계속 바뀌기 때문입니다. 그래서 harness에서 자율성 수준을 설정으로 조절하게 했습니다.
- 세밀한 감독: red, green, refactor 단계를 하나하나 확인합니다.
- 주기적 확인: 테스트 세 개마다, 또는 refactoring이 끝날 때마다 확인합니다.
- 완전 자율: 끝까지 맡깁니다.
두 컨설턴트 가운데 한 사람은 개인적인 경험상 루프 안에 남아 수시로 방향을 고치는 쪽이 손을 놓는 쪽보다 훨씬 나은 결과를 낸다고 말합니다. 완전히 감독하지 않으면 agent가 미묘하게 엇나가거나 없는 것을 지어낼 수 있기 때문입니다. 더 근본적으로, 사소하지 않은 작업이라면 일을 맡기기 전에 사람이 먼저 도메인과 문제에 대한 정확한 정신 모델을 갖춰야 합니다. 사람의 명세가 애초에 잘못됐다면 agent가 그것을 보완해 주지는 못합니다.
정리: 무엇부터 시작할까
EXACT가 보여 주는 것은 두 가지입니다. 첫째, 코드 생성 전에 예시를 정리하는 것이 정확도를 좌우하는 가장 큰 지렛대라는 점입니다. 둘째, 테스트 목록과 red-green-refactor 루프, 예측형 TDD 같은 구조를 agent에게 강제하면 복잡도와 함수 길이가 줄고 테스트 모음의 결함 탐지력이 오르지만, token 비용은 그만큼 더 든다는 점입니다.
시작하려는 독자가 할 수 있는 일을 정리하면 다음과 같습니다.
- 복잡한 업무 로직을 agent에게 맡기기 전에 이해관계자와 Example Mapping을 먼저 합니다. 여러 문단짜리 산문 prompt로 대신하지 않습니다.
- 정리된 예시를 자연어 테스트 목록으로 옮기고, LLM에게 빠진 조합과 edge case를 찾아 달라고 요청합니다.
- 목록을 하나씩 red-green-refactor 루프로 처리하되, 테스트 실행 전에 결과와 오류 메시지를 예측하게 합니다.
- refactoring은 별도의 agent나 새 세션으로 분리해 context가 오염되지 않게 합니다.
- 익숙하지 않은 영역일수록 red와 green 사이를 자주 확인하고, 자율성은 과제 난도에 맞춰 조절합니다.
- 자기 조직의 agent 성능을 평가할 때는 학습 데이터에 없는 새 과제와 숨겨 둔 테스트 모음을 씁니다.
TDD를 깊이 익히지 않았어도 harness를 쓰기 시작하는 데는 문제가 없고, 오히려 도구를 쓰면서 TDD 원칙을 배우게 된다고 합니다. 경험 많은 TDD 실천자라면 도메인 heuristic과 테스트 제약을 prompt에 직접 넣어 harness를 맞춤화할 수 있습니다. harness와 실험 환경 전체는 GitHub에 agentic_coding_lab이라는 이름으로 공개돼 있어 그대로 가져다 쓰거나 고칠 수 있으며, 이 방법론을 다룬 책은 독일어판이 먼저 나오고 영어판이 준비 중입니다.


