AIエージェントにコードを頼む前に具体的な例を書き出し、その上でエージェントに古典的なテスト駆動のループを回させると、「バイブコーディング」と呼ばれる緩いプロンプトのやり方よりも、はるかに正しく、はるかにきれいなコードが得られます。これが、ITコンサルティング企業codecentricの2人のコンサルタントが開発した「EXACT」というワークフローの中心的な知見で、モデルが一度も見たことのない課題を使ったベンチマークの結果に裏付けられています。ある課題では、Claude Opus 5の正答率が散文の説明では27%だったのに対し、マッピングした例を与えると94%に達しました。別の課題では15%から100%へと跳ね上がりました。
バイブコーディングはなぜうまくいかないのか
このワークフローは、技術カンファレンスでの実験と実際の顧客プロジェクトから生まれました。codecentricのチームが繰り返し目にしたのは、構造化されていないバイブコーディングは素早くコードを出してくれるものの、そのコードがユーザーの本当に望んだものと一致することはまれで、深刻な品質上の欠陥を抱えているというパターンでした。これに対する答えはAIエージェントをあきらめることではなく、テスト駆動開発(TDD)とリファクタリングという長年使われてきたエンジニアリング手法を、省略されるのではなくモデルを導くように作り替えることでした。EXACTという名前は、近似ではなく「まさに(exactly)望んだ通りの」振る舞いを得るという目標にかけた、意図的な言葉遊びです。
関連する考え方が、このアプローチ全体の枠組みになっています。ダニエル・テルホルスト=ノースとマット・ウィンは、TDDは「例に導かれた開発(Example-Guided Development)」として理解するのが適切だと主張してきました。これは受け入れテスト駆動開発、振る舞い駆動開発、実例による仕様(specification by example)も含む包括的な概念です。この主張は大規模言語モデル(LLM)に驚くほどよく当てはまります。LLMは、要件を抽象的・理論的に説明されるよりも、具体的な例を渡されたときのほうがはるかに良い成果を出すからです。
EXACTワークフローの5つの段階
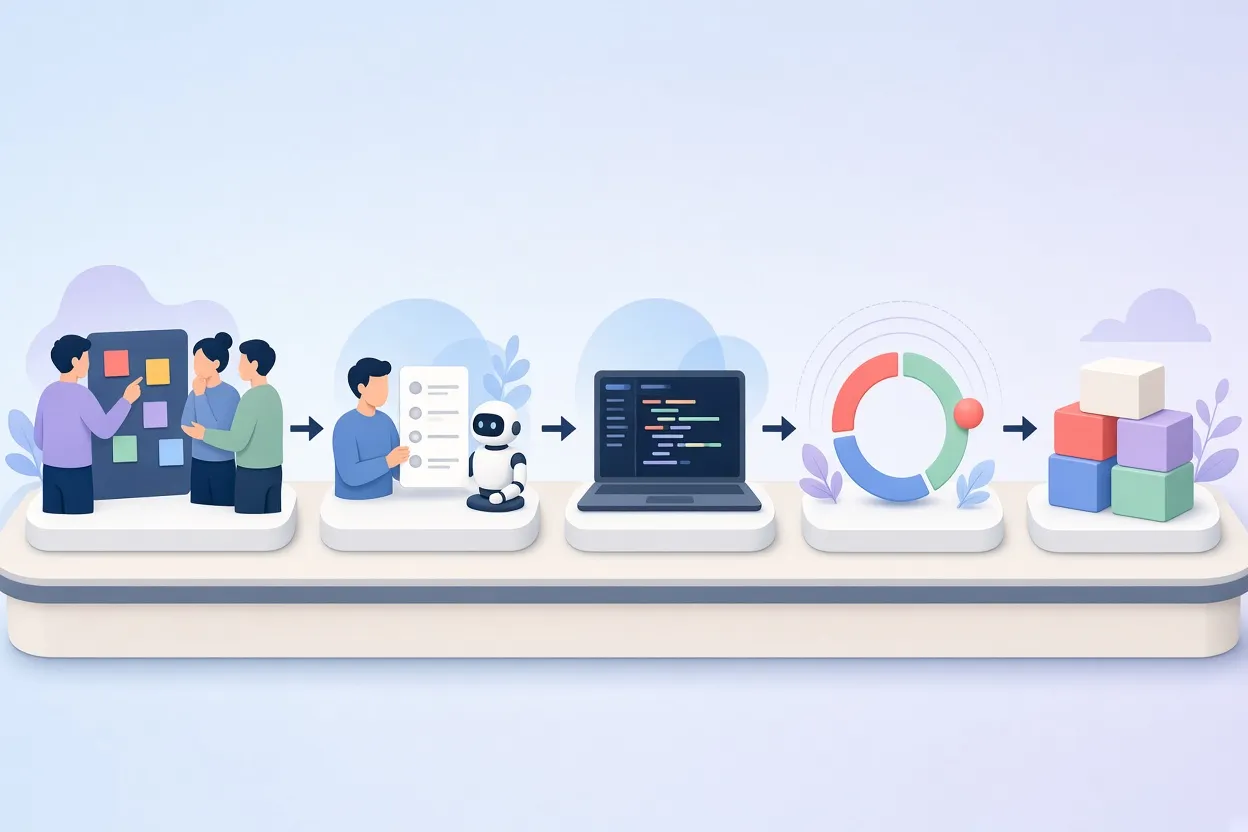
▲ EXACTワークフローの5つの段階
EXACTは、人間同士の会話から実行可能なコードへと進む、つながった5つの段階の連なりとして動きます。
- Example Mapping。 マット・ウィンが考案した協働モデリング手法で、チームがユーザーストーリーをルールと具体例に分解して付箋に書き出します。この段階は完全に人間が担い、共有されたメンタルモデルを素早く築くことが目的です。
- 仕様/テストリスト。 マッピングした例を自然言語のテスト一覧に落とし込みます。ケント・ベックのCanon TDDにある、シナリオの生きたチェックリストを保つという考え方を踏まえたものです。ここでエンジニアはEXACTのコーディングハーネスを通じてLLMと直接やり取りし、モデルの仕事はリストを批評することです。抜けているエッジケース、見落とされた組み合わせ、例がまったくカバーしていないシナリオを見つけ出します。
- テストの実装。 リストの項目を1つずつ本物のテストにします。
- TDDの内側のサイクル。 エージェントがレッド(失敗するテストを書く)、グリーン(通るようにする)、リファクタリング(振る舞いを変えずに整える)を回します。
- 実装。 動く実装ができあがるまで、項目ごとにループを続けます。
ワークフローの前半は、分厚いドキュメントではなく、理解と協働と会話が主眼です。ドメイン駆動設計から借りたEventStormingやドメインストーリーテリングといった手法が、Example Mappingと並んで、エージェントにプロンプトを出す前に振る舞いを明確にする手段になります。狙いは思考を前倒し(シフトレフト)し、コードが書かれた後になって巨大なプルリクエストをレビューするというおなじみの罠を避けることです。
モデルが見たことのない課題で測る
ワークフローを厳密に検証するため、codecentricのチームは、さまざまなLLM、ハーネス、プログラミング言語をまたいで動く実証ラボを構築しました。結果の信頼性を支える設計上の選択が2つあります。第一に、ベンチマークの課題がモデルの学習データにすでに存在しないよう、新しいコードカタ(小さな練習問題)を自作しました。第二に、AIからは隠した包括的な受け入れテスト一式を非公開で用意し、それを使って正しさを独立に評価しました。
最初の比較では、バイブコーディングの典型的な入力である散文ベースのプロンプトと、Example Mappingを対決させています。どちらもEXACTワークフローの中でClaude Opus 5を使い、各条件6回ずつ実行しました。
| 新規課題 | 散文の正答率 | Example Mappingの正答率 | 改善幅 |
|---|---|---|---|
| Claim Office | 27% | 94% | +67ポイント |
| Sphinx Score | 15% | 100% | +85ポイント |
テストケース全体を通じて、Example Mappingは一貫して正答率を60、70、80ポイント、ときにはそれ以上押し上げるとチームは報告しています。説明は単純で、例は正確な制約と明確な期待を定めるのに対し、散文ではモデルが推測するしかないからです。
Markdownを増やしても問題は解決しない理由
codecentricのコンサルタントは、Claude Codeチームのように自分たち自身のためのツールを作り、要件が自然と直感的に分かるチームと、コンサルタントが普段働く企業の現場とを対比しています。銀行、保険、Eコマースでは、開発者がその領域の生粋の専門家であることはまれで、散文だけで伝えられる機能要望は本質的にあいまいです。
これは、GitHubで公開されているBMADのような仕様駆動開発フレームワークに対する批判でもあります。こうしたフレームワークは、複数フェーズにわたるMarkdownのアーキテクチャ仕様を生成することで人気を集めてきました。しかし彼らの見方では、何ページものMarkdownの散文を足しても、根底にあるあいまいさは消えません。具体例がなければ、仕様駆動開発は他の散文による要件と同じ弱点を引き継ぐことになります。
素のTDDと構造化されたTDDの比較
2つ目のベンチマークは内側のループに目を向けます。TypeScriptのClaim Office課題で、Claude Opus 5.5を動かすClaude Codeを3通りの方法で各5回ずつ試したところ、どの方式も少なくとも96%の正答率に達しました。素のTDD(Plain TDD)とは、最小限の指示でモデルに単にTDDをやるよう伝える素朴なプロンプトのことです。
| 指標 | 素のTDD | EXACT Coding | EXACT+リファクタリングエージェント |
|---|---|---|---|
| 認知的複雑度(最大) | 7.6 | 2.4 | 2.0 |
| 最長の関数(行数) | 26.2 | 13.0 | 14.2 |
| ミューテーションスコア | 0.76 | 0.94 | 0.95 |
| 1回あたりのコスト | $1.31 | $9.79 | $28.34 |
認知的複雑度はコードの追いにくさを点数化したもので、ミューテーションスコアは意図的に埋め込んだバグをテストスイートがどれだけ捕まえられるかを測るため、この行だけは高いほど良く、それ以外の行は低いほど良い値です。構造化されたワークフローは、認知的複雑度のピークをおよそ3分の2減らし、最長の関数を半分にし、ミューテーションスコアを上限近くまで押し上げています。引き換えになるのはコストで、EXACT Codingは1回あたり素のTDDの約7倍、専用のリファクタリングエージェントを足すとさらに約3倍になります。
リファクタリングエージェントの価値はモデルの世代によって変わります。以前のClaude Opus 4.6では、独立したリファクタリング用サブエージェントが非常に大きな品質向上をもたらしました。Claude Opus 5.5ではその差が縮まっており、このモデルについては追加の出費を正当化しにくくなっています。
クリーンなコンテキストを持つサブエージェント
▲ TDDの各フェーズを隔離したサブエージェント
このラボは、Claude Codeにスキルやツールがまだ存在しなかった頃、単一のTDDプロンプトから始まりました。コンテキストウィンドウが大きくなるにつれて性能が落ち、チームはこれをスタンフォード大学の論文「Lost in the Middle: How Language Models Use Long Contexts」と結びつけました。その知見は、LLMは長いコンテキストの最初と最後からは情報をうまく取り出せる一方、中間にあるものは見落としたり無視したりしがちだというものです。
提案された対策は、TDDの異なるフェーズをそれぞれ専門のサブエージェントに分け、各サブエージェントに新しい隔離されたコンテキストウィンドウを与えることでした。こうすれば指示は鋭いまま保たれ、それまでのやり取りに薄められません。この考えを検証する研究用ハーネスはわずか1週末で作られ、上のベンチマークはそれを走らせた結果です。
予測型TDD:実行前にエージェントに宣言させる
このワークフローの中核となる仕組みが予測型TDD(predictive TDD)です。卓上のTDDゲームで広まり、Cyber-Dojoプラットフォームで実践されている考え方です。ルールは、TDDの各ステップを実行する前に、人間であれLLMであれ、実践者が正確な結果を予測しなければならないというものです。レッドのステップでは、エージェントはテスト実行コマンドを出す前に、テストが失敗すること、その正確な理由、予想されるエラーメッセージを述べなければなりません。
主張されている利点は2つあります。この習慣によってモデルは、もっともらしく聞こえるコードに流れていくのではなく、実際のランタイムと向き合い続けることを強いられます。そして、目の前のドメインの問題がモデルのアクティブなコンテキストの先頭に押し出されるため、Lost in the Middleの効果を考えれば、最も重要な情報がモデルの最も注意が向く場所に置かれることになります。
エージェントにどれだけの監督が必要か
モデルの能力は変わり続けるため、万能の答えはありません。そこでハーネスでは自律性の度合いを設定できるようになっています。開発者はレッド、グリーン、リファクタリングの各フェーズをすべて確認することも、定期的に(たとえばテスト3件ごと、あるいはリファクタリング1回ごとに)チェックすることも、エージェントを完全に自律で走らせることもできます。
ワークフローの考案者たちの個人的な好みは、積極的にループに留まって軌道修正を加えることで、彼らの経験では、手を離した実行よりもはるかに良い結果が得られるといいます。より深い理由は、委ねる前にまず人間がドメインと問題の正確なメンタルモデルを築かなければならないことにあります。エージェントは欠陥のある仕様を埋め合わせることができないため、些細でない課題では人間の導きが不可欠と考えられます。
コンサルタントの一人は、同僚は20年間人間にTDDを教えようとしてきたが、ついに耳を傾けて規律を体系的に実行してくれる生徒がLLMだった、と冗談を飛ばしました。ハーネスを使い始めるのにTDDの深い習熟は必要なく、ハーネスと一緒に作業すること自体が原則を学ぶ道になります。経験豊富な実践者なら、ドメインのヒューリスティクスや課題に合わせたテスト上の制約をプロンプトに直接組み込んで、さらに先へ進めます。
押さえておきたいことと試してみること
codecentricのラボから得られた証拠が指し示す方向は1つです。実績あるクラフトマンシップの実践は、コーディングエージェントの時代でも時代遅れではなく、エージェントの出力を正しく保守可能に保つための釣り合いの重りです。正しさを決める最大のてこは具体例であり、コードとテストの品質を決めるてこは構造化されたTDDループで、その代価はトークンで支払われます。
これを取り入れたいチームへの提案です。
- 本番コードをエージェントに頼む前に、関係者とExample Mappingのセッションを行う。開発者がその領域の専門家でない場合は特に重要。
- 例を自然言語のテストリストに変換し、抜けている組み合わせやエッジケースがないかLLMに批評してもらう。
- 何段落もの散文プロンプトを丸ごと渡すのではなく、リストを順番にレッド・グリーン・リファクタリングのループで進める。
- 各テストを実行する前に、通るか失敗するか、その理由、エラーメッセージが何になるかをエージェントに予測させる。
- リファクタリングは別のエージェントか新しいセッションに分離し、使うモデルに応じて追加コストと効果を天秤にかける。
- 監督の度合いを課題に合わせる。慣れないアーキテクチャの領域ではレッドからグリーンへの移行を一つひとつ注意深く見守り、パターンを信頼できるようになってから初めて監視を緩める。
- コーディングエージェントを評価するときは、暗記された学習データで結果が水増しされないよう、テストスイートを隠した新規のカタを用意する。
ハーネスと検証ラボの全体は、agentic_coding_labというリポジトリ名でGitHubにオープンソースとして公開されており、考案者たちはこの手法についての書籍を執筆中です。まずドイツ語で書かれ、英語版も準備が進んでいます。


