谷歌DeepMind发布了Gemini Robotics 2。这是一组由三个机器人AI模型构成的模型家族,由一个模型负责理解场景并制定计划,再由其他模型把计划转化为从指尖到脚底的动作。目前只有规划模型通过API向公众开放,动作模型仅限受信任的测试者使用。谷歌DeepMind的Gemini Robotics研究负责人表示,进展速度令人惊讶,但机器人技术大致仍处于语言模型的“GPT-2时代”。下文梳理有哪些变化、哪些因素仍在制约机器人,以及正在评估机器人AI的团队现在可以做什么。
三个模型,两层结构
Gemini Robotics 2采用分层架构。较慢的推理层决定做什么,动作层决定身体如何移动。
| 模型 | 职能 | 开放情况 |
|---|---|---|
| Gemini Robotics ER 2 | 场景理解、空间分析、任务规划、工具选择 | 在Google AI Studio以API公开 |
| Gemini Robotics 2 | 把指令转化为关节动作和运动轨迹的视觉-语言-动作模型 | 仅限受信任的测试者 |
| Gemini Robotics On-Device 2 | 无需云端连接、直接在机器人上运行的紧凑型动作模型 | 仅限受信任的测试者 |
ER是embodied reasoning(具身推理)的缩写,指从一个必须在物理场景中行动的身体的视角,对该场景进行推理。Gemini Robotics ER 2由Gemini Flash衍生而来,承担“System 2”式的规划角色,即缓慢而审慎的思考者。开发者把机器人能做的动作,例如抓取或放置物体,写成带有文字说明的工具,模型再从中选出合适的工具,就像软件AI智能体选择要调用的函数一样。
Gemini Robotics 2是VLA,即视觉-语言-动作(vision-language-action)模型:以图像和语言为输入,输出机器人动作。它对整个身体进行统一推理,协调双手、手臂、双腿和姿态,而不是孤立地处理每个关节。快速的平衡与稳定控制回路仍由底层控制器运行,但目标位置和运动轨迹由VLA生成。端侧版本是在机器人本体上运行的压缩版,省去了网络往返,在带宽不足的地方也能让机器人持续工作。
规划模型如何操控身体
规划模型与动作模型之间的衔接属于一个名为可操控性(steerability)的研究领域。早期的ER用二维图像坐标来指定抓取放置的目标。如今,规划模型可以通过几种方式操控动作模型:
- 自然语言,例如“转过身”或“看向左边”
- 指向场景中的物体,可以消除柠檬还是香蕉这类歧义
- 上下文学习,用一段演示视频告诉机器人要做什么,无需重新训练
如果两个模型之间只传递纯文本,空间细节可能会丢失,因此目标是在两者之间建立丰富的多模态接口。
记忆是另一项限制。该模型的上下文窗口,即一次能够考虑的信息量,为12.8万个token。换算成视频输入,视帧率和图像编码方式而定,大约相当于3分钟的情景记忆。这足以应对短时的操作任务,却不够完成长达数小时的家务。务实的做法是保留已完成步骤的简短文字摘要(如“把鸡蛋翻了面”),而不是原始视频,同时对帧进行降采样或删除静止帧。
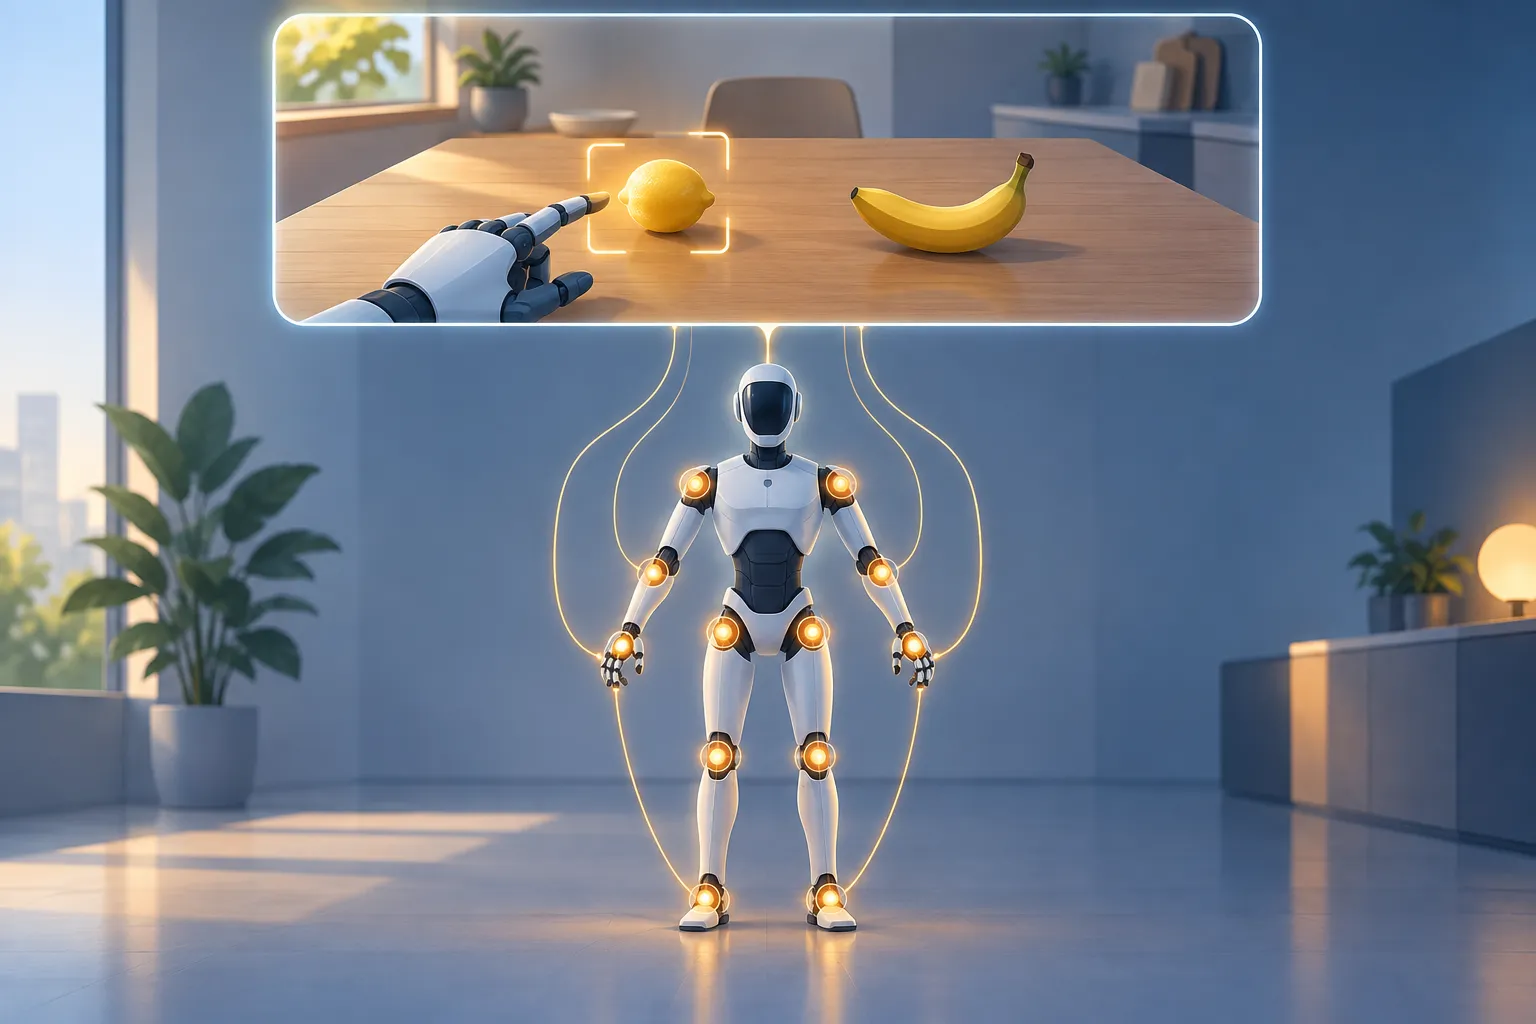
▲ 规划模型操控动作模型
为什么手比奔跑更难
今年夏天,在中国举办的一场机器人比赛中,人形机器人跑得比顶尖的人类短跑选手还快,相关视频广泛传播。从研究角度看,在平地上奔跑是相对容易的问题。脚与坚硬地面的接触可以预测,因此仿真能够准确建模,在仿真中学到的技能也能顺利迁移到真实硬件上。这些短跑机器人很可能依靠以人类或动物动作数据初始化的底层强化学习控制器,几乎不涉及高层推理。况且,速度并不是让机器人在家中或工作场所派上用场的关键。
操作则不同。摩擦会变化,物体会弯曲和折叠,仿真器难以跟上,叠衣服就是典型例子。刚性物体的抓取放置是例外,借助在海量数据上预训练的大型基础模型,这类任务的可靠性已接近商用水平。因此,研究前沿已经从固定在桌面上的夹爪机械臂,转向能够迈步、下蹲,并在闭环中处理陌生物体的人形机器人。
硬件也在变化。Gemini Robotics 1展示了双指平行夹爪所能达到的水平。大约15个月后,Gemini Robotics 2展示了多指灵巧手系紧垃圾袋。多指手如今代表了灵巧操作的前沿,市面上的选择也各不相同:
| 机器人手 | 尺寸 | 力量 |
|---|---|---|
| Wuji | 接近人手 | 约相当于10岁儿童 |
| Sharpa | 比人手大 | 可举起约20公斤,能拧开很紧的瓶盖 |
尚待解决的问题是可靠性、各台设备之间的一致性以及成本。触觉同样重要。有了力觉感知和反向驱动能力(back-drivability,即关节受到推力时能顺畅地随之移动),机器人可以把薯片叠起来而不把它们压碎;把指尖的力数据输入学习模型,也能比只用视觉时做出更好的判断。
为什么机器人技术仍处于“GPT-2时代”
GPT-3标志着语言模型能够从少量示例中可靠地学会新任务。机器人技术在广泛的任务上还没有到达这一点。
最大的差距在于跨本体(cross-embodiment),即用同一个模型控制身体和传感器各不相同的机器人。语言模型在iPhone、Mac或Linux服务器上运行起来都一样,但机器人策略换到不同的硬件上往往完全失效。语言AI从来无须解决这个问题。谷歌DeepMind的目标是不依赖任何特定身体的通用智能,并把人形机器人作为试验场,因为人形机器人迫使研究同时在三个方向取得进展:全身平衡、多指灵巧操作以及人机交互。
进展也是有的。谷歌DeepMind正与Apptronik、Agile Robots、Boston Dynamics等机器人厂商合作,端侧模型只需约200次演示就能适应新的机器人身体。不过,零样本部署,也就是不经额外训练直接在陌生机器人上运行并达到生产级可靠性,仍未解决。基于演示的提示能缩短准备时间,但在场景发生变化时可能沦为僵硬的模仿。
错误还会累积。在由十个动作组成的链条中,系统必须检查每一步是否成功,并选择下一个子目标。如果缺乏可靠的实时恢复机制,整体成功率会急剧下降。失误能否撤销会带来很大差别:
- 拼装LEGO是宽容的:放错的积木可以重新再试。
- 煮鸡蛋则不然:掉落或煮过头的鸡蛋无法挽回,因此对可靠性的要求要高得多。
视觉泛化已大幅改善,光线或厨房布局的变化不再会让模型失灵。如今的瓶颈在于任务的物理层面:接触、力控制以及不可逆的步骤。
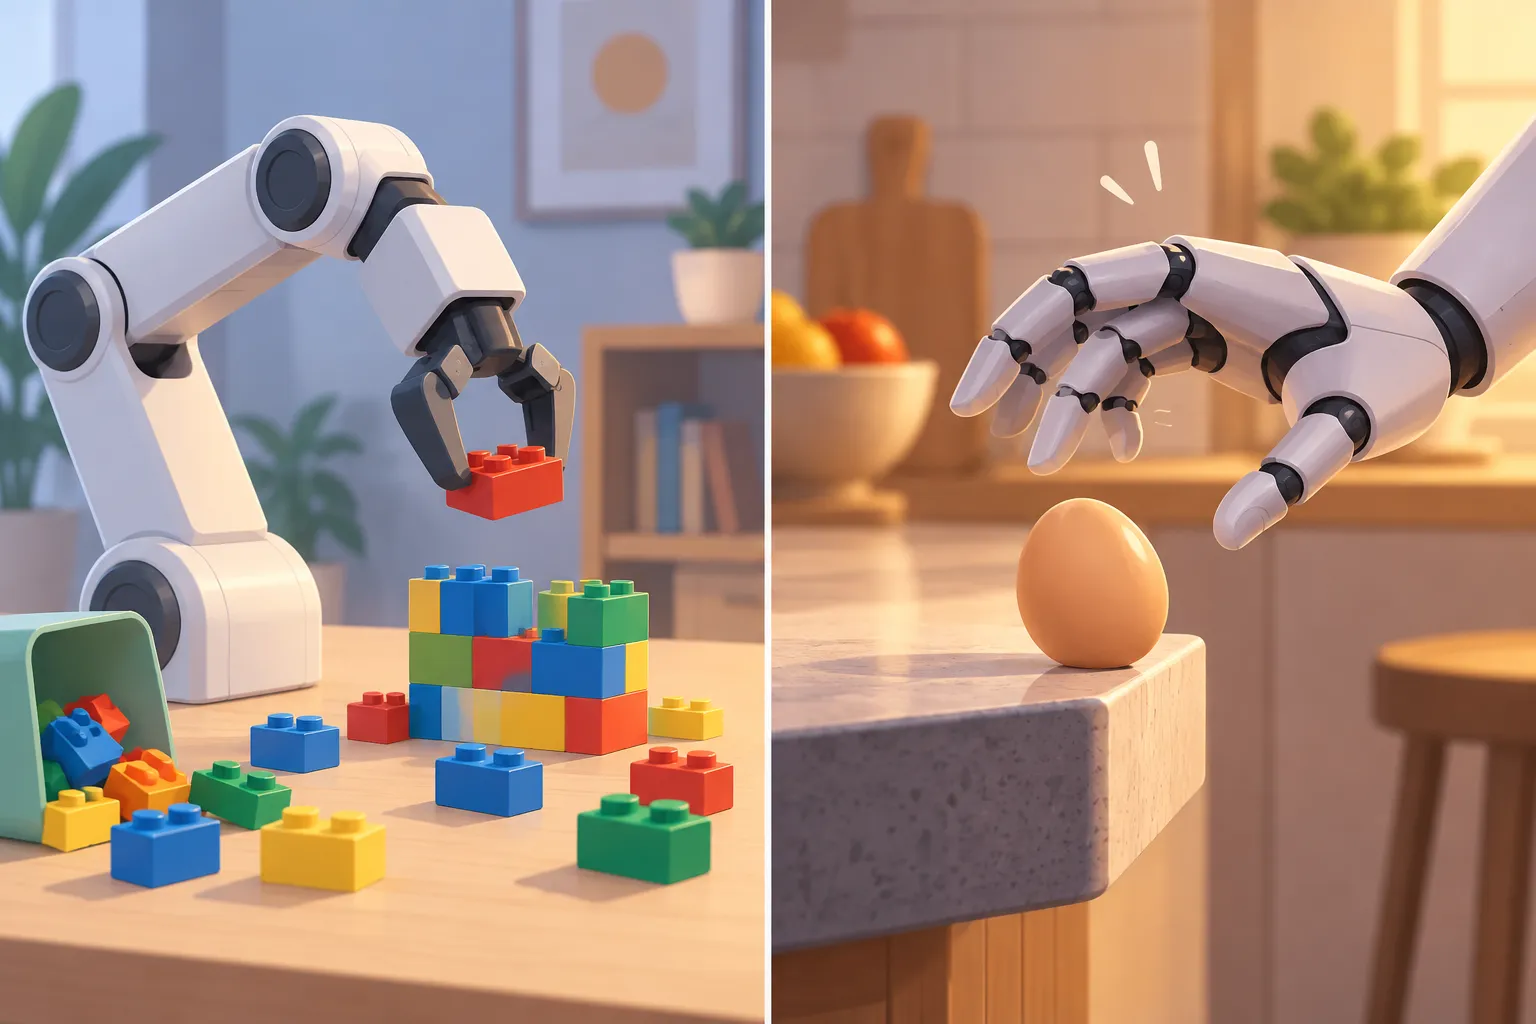
▲ 可挽回与不可逆的任务
速度与可靠性取决于用途
延迟是现实存在的权衡。在一个接入Gemini Robotics API的简单二维仿真中,模型从收到图像和“把香蕉移到盘子上”的指令到发出工具调用,大约用了6秒。对需要即时响应的交互来说这太慢了,但可接受的速度因场景而异:
- 工厂装配线不能停顿,因此需要极快的响应。
- 叠衣服这类家务更看重准确而非速度,机器人可以在夜间慢慢完成。
- 网络条件差的偏远作业现场,需要在机器人上运行的模型。
家庭仍然不会是第一个市场。幼儿以及杂乱、难以预测的布局让安全门槛非常高,因此便于控制环境的商业场所仍更适合早期部署。由于新能力往往先出现在更大、更慢的模型中,快模型和慢模型很可能会同步开发,并把大模型的知识蒸馏到小模型中。
规划模型的优势体现在特定领域。在一项类似的基础抓取放置二维测试中,包括物体在任务中途被移动的情况,Gemini Robotics ER 2与基础版Gemini 1.5 Flash表现相当。ER 2领先的是读取指针式仪表、检测缺陷、精确指向位置等专业工作。API在Google AI Studio上线后,使用量远超小规模受信任测试群体时的水平,研究人员还把它装到Boston Dynamics的Spot上,让它读取仪表、分发零食。不过需要注意,机器人领域没有标准API,命令体系特殊的机器人需要反复调整提示词和模式定义,规划模型才能稳定驱动。
安全本身就是一种能力
一个只有一半时间答对的聊天机器人仍可能有用,但会掉东西的机器人会造成实际损害。因此,除非任务能容忍失败,否则50%甚至80%的成功率都不足以支撑自主作业。安全被视为一种能力,而不是对能力的束缚,因为消费者不会接受不安全、不可靠的家用机器人。
机器人安全分为两部分:一是物理安全,涉及笨拙、机械故障和倾倒;二是负责规划的模型的行为对齐。沉重的人形机器人在家中摔倒会立即构成危险,因此安全必须贯穿整个技术栈,从机械设计和急停硬件一直到规划模型。
| 急停方式 | 工作原理 | 对有腿机器人的影响 |
|---|---|---|
| 硬急停 | 切断所有关节的电源 | 机身可能瘫倒,砸向附近的人或物 |
| 软急停 | 把关节锁定在当前位置 | 机器人保持平衡,不会摔倒 |
行为层面同样要经过测试。在一项鲁棒性测试中,研究人员把一个篮子扣在正在工作的人形机器人头上。正确的反应是察觉传感器被遮挡,停下来向人求助,而不是继续盲目行动。人的外形也会抬高门槛:夹爪没抓住东西,人们只会把它看作故障,但人形机器人失手时,看起来就显得笨拙得多。随着机器人的行为变得更自然,例如在对话中即兴做出手势而不是按脚本点头,人们的期待可能会进一步提高。
要点与建议
Gemini Robotics 2把规划与动作分开,并通过API把规划模型开放给所有人;与此同时,灵巧操作、跨本体、错误累积和安全仍是悬而未决的研究课题。对于正在评估机器人AI的开发者和企业,可以根据技术现状采取以下步骤:
- 从现在就能用的Gemini Robotics ER 2 API入手。把机器人动作定义为名称和说明都清晰的工具,让ER 2负责规划,把动作交给现有控制器或专用动作模型。
- 不只比较基础的抓取放置,还要在读取仪表、检测、指向位置等ER 2最擅长的任务上,把它与通用模型进行比较。
- 先确定延迟要求。工厂产线和夜间家务需要的模型和部署方式各不相同。
- 从失败后可以重试的任务开始;在多步骤流程中,在步骤之间加入成功检查。
- 用移动过的物体和变化后的场景进行测试,而不是沿用训练时的设置,以区分真正的泛化和模仿。
- 对于有腿机器人,采用锁定关节而非切断电源的停机方式,并让机器人在传感器被遮挡时停下并求助。