AI agent를 운영하다 보면 "지금 이 메시지에 답해야 하나", "이 티켓은 어느 부서로 보내야 하나" 같은 판단을 계속 내려야 합니다. 이런 판단을 매번 생성형 LLM에 물어보면 느리고 비쌉니다. 대안으로 떠오른 것이 decision model(미리 정한 답 후보마다 확률을 돌려주는 모델)입니다. TypeSafe AI의 Jev, OpenAI의 Decisions API, Cloudflare의 Clef가 이 영역의 대표적인 선택지입니다. 핵심 원칙은 단순합니다. 모델은 확률만 내고, 임계값과 분기, 실패 처리는 전부 애플리케이션 코드가 맡습니다.
생성형 LLM에 매번 묻는 방식의 한계
한 회사의 사내 Slack 비서 사례가 문제를 잘 보여 줍니다. 이 비서는 thread에서 한 번 호출되면 이후 모든 메시지에 답하려 들었습니다. 동료 둘이 "고맙다"는 인사를 주고받는 대화에까지 끼어든 것입니다.
가장 쉬운 해결책은 매번 @멘션을 강제하는 것이지만, 이어지는 대화 속에서 매번 봇을 부르는 것은 어색하고 대화 흐름을 끊습니다. 그렇다고 "이 메시지가 비서에게 하는 말인가"를 생성형 LLM에 물으면, 답을 기다리는 시간과 비용이 모든 메시지마다 붙습니다. 필요한 것은 아주 빠르고 저렴하게 "예/아니오"에 가까운 판단을 내리는 장치였고, decision model이 정확히 이 routing 문제를 풉니다.
decision model이 돌려주는 것
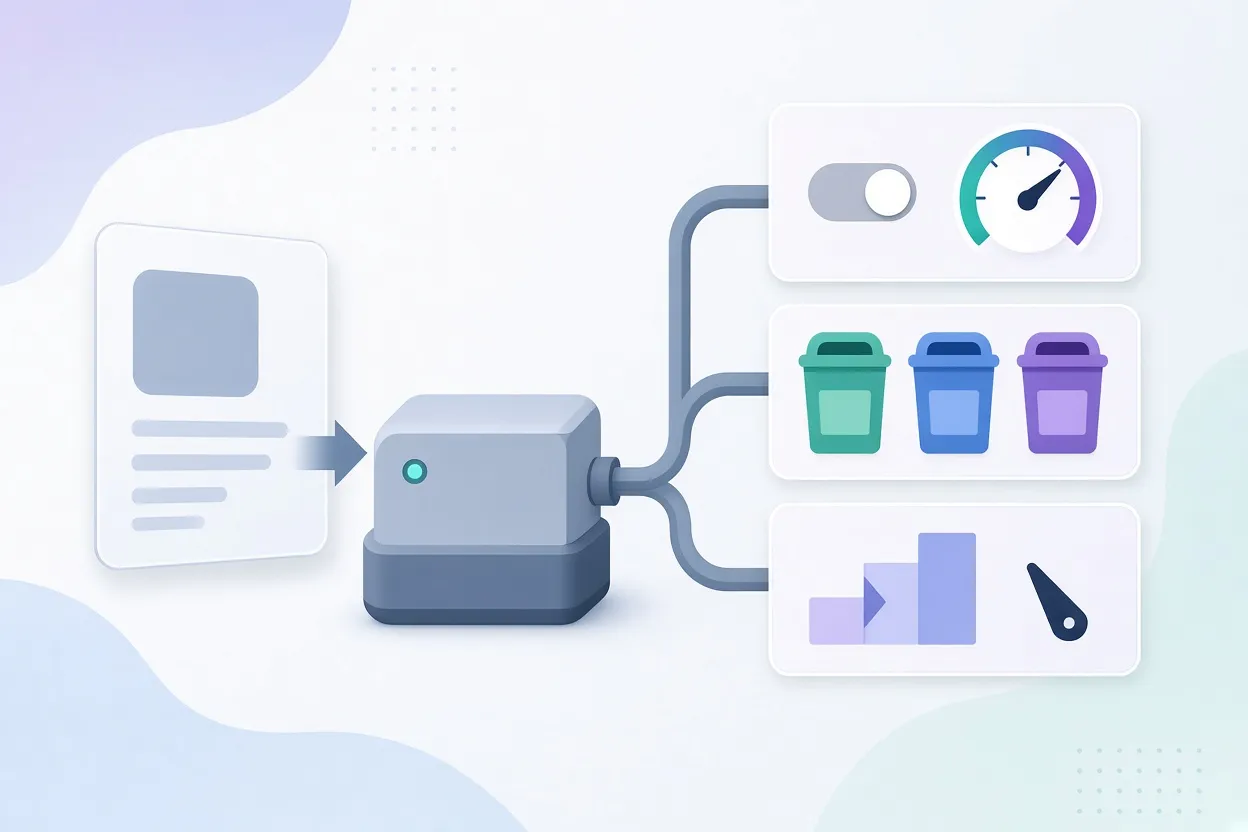
decision model에 보내는 요청은 세 부분으로 이루어집니다. state(판단 대상이 되는 context나 입력 객체), questions(묻는 질문), 그리고 엄격하게 제한된 allowed answers(허용된 답)입니다. 모델은 문장을 만들지 않고, 허용된 답 각각에 확률을 배정합니다.
오픈소스 TypeScript framework인 Mastra는 이 질문을 세 가지 형태로 정의하는 classifier primitive를 제공합니다.
| 질문 형태 | 입력 | 출력 |
|---|---|---|
| Boolean | 참/거짓 질문 | '참'일 확률 하나(1에 가까우면 강한 긍정, 0에 가까우면 강한 부정) |
| Choice | 기준 설명이 붙은 label 집합(예: billing, support, sales) | 모든 label에 대한 확률 분포 |
| Score | 순서가 있는 숫자 등급 rubric(예: 버그 심각도 0, 1, 2) | 등급별 확률과 가중 평균 점수 |
고객 티켓 분류 예시를 보면 감이 옵니다. "이번 달 두 번 결제됐어요. 하나 취소해 줄 수 있나요?"라는 메시지에 대해 Boolean 질문은 환불 요청일 확률 0.95를 돌려줍니다. 심각도 Score 질문은 0(외관 문제) 12%, 1(우회 방법 있음) 72%, 2(차단됨, 우회 불가) 16%로 확률을 나누고, 가중 평균 1.03을 계산합니다.
중요한 실전 팁은 질문을 한 번에 묶는 것입니다. Mastra에서는 Boolean, Choice, Score 질문을 하나의 classifier 호출에 묶어 state를 한 번만 읽게 할 수 있습니다. TypeSafe AI의 안내도 같은 방향입니다. 코드가 나중에 필요로 할 수 있는 질문을 한 요청에 모두 던지고, 쓰지 않는 결과는 무시하는 편이 조건부로 요청을 이어 보내는 것보다 낫습니다. 요청당 질문 한도는 OpenAI Decisions API가 400개, Cloudflare Clef가 64개이고, Jev는 64,000 token의 context window에 들어가는 만큼 넣을 수 있습니다.
▲ 한 번의 호출로 묶은 세 종류의 질문
왜 더 빠르고 더 싼가
차이는 실행 방식에 있습니다. 일반 chat 모델은 autoregressive(앞서 만든 token을 보고 다음 token을 하나씩 만드는) loop를 돕니다. 전체 vocabulary에 대한 확률을 계산하고, token 하나를 뽑고, 이어 붙이고, 다시 반복해 JSON 문자열을 완성한 뒤 그것을 parsing해야 합니다.
decision model은 이 sampling loop를 아예 건너뜁니다. state와 질문에 대해 forward pass(모델을 한 번 통과시키는 계산) 한 번으로 허용된 답에 대한 확률을 바로 출력합니다. 생성하는 텍스트가 없으니 output token 요금도 없습니다. 입력 token 가격은 다음과 같습니다(100만 token당, 확인 시점 기준).
| 제공자 | 모델 | 입력 가격 |
|---|---|---|
| TypeSafe AI | Jev | $0.042 |
| OpenAI | Decisions API | $0.10 |
| Cloudflare | Clef | $0.24 |
| Cloudflare | Clef-flash | $0.038 |
코드, 생성형 LLM, decision model의 역할 분담
decision model이 만능은 아닙니다. 애플리케이션 로직을 세 갈래로 나누어 생각하면 자리가 분명해집니다.
- 생성형 LLM: 자유로운 글쓰기, 요약처럼 텍스트를 만들어야 하는 일
- 결정적 코드: 정답이 하나뿐인 업무 규칙. $500을 넘는 환불은 관리자 승인 필요, 프로젝트 삭제는 admin만 가능 같은 규칙은 if/else로 씁니다
- decision model: 긴급도 판별, 부서 routing, AI 비서가 끼어들어야 하는지 판단처럼 규칙으로 깔끔하게 쓰기 어려운 judgment call(애매한 판단)
decision model은 요약이나 창작, 추론 과정 설명에는 맞지 않고, 결과가 명확한 정책을 확률 모델에 맡겨서도 안 됩니다.
임계값은 코드에 둔다: 단일 cutoff와 세 구간
Slack 비서는 thread의 답글이 비서에게 하는 말인지, 다른 사람에게 하는 말인지를 decision model에 묻습니다. 모델은 확률만 돌려주고, 답할지 말지는 코드 한 줄이 정합니다. 확률을 0.45라는 상수와 비교하는 것이 전부입니다.
이 구조의 장점은 분명합니다. 비교문은 평범한 코드이므로 외부 모델을 호출하지 않고도 결정적인 단위 테스트를 쓸 수 있습니다. 임계값은 이름 붙은 상수 하나로 관리하기 때문에, 조정할 때 pull request에서 한 줄 변경으로 깔끔하게 드러납니다.
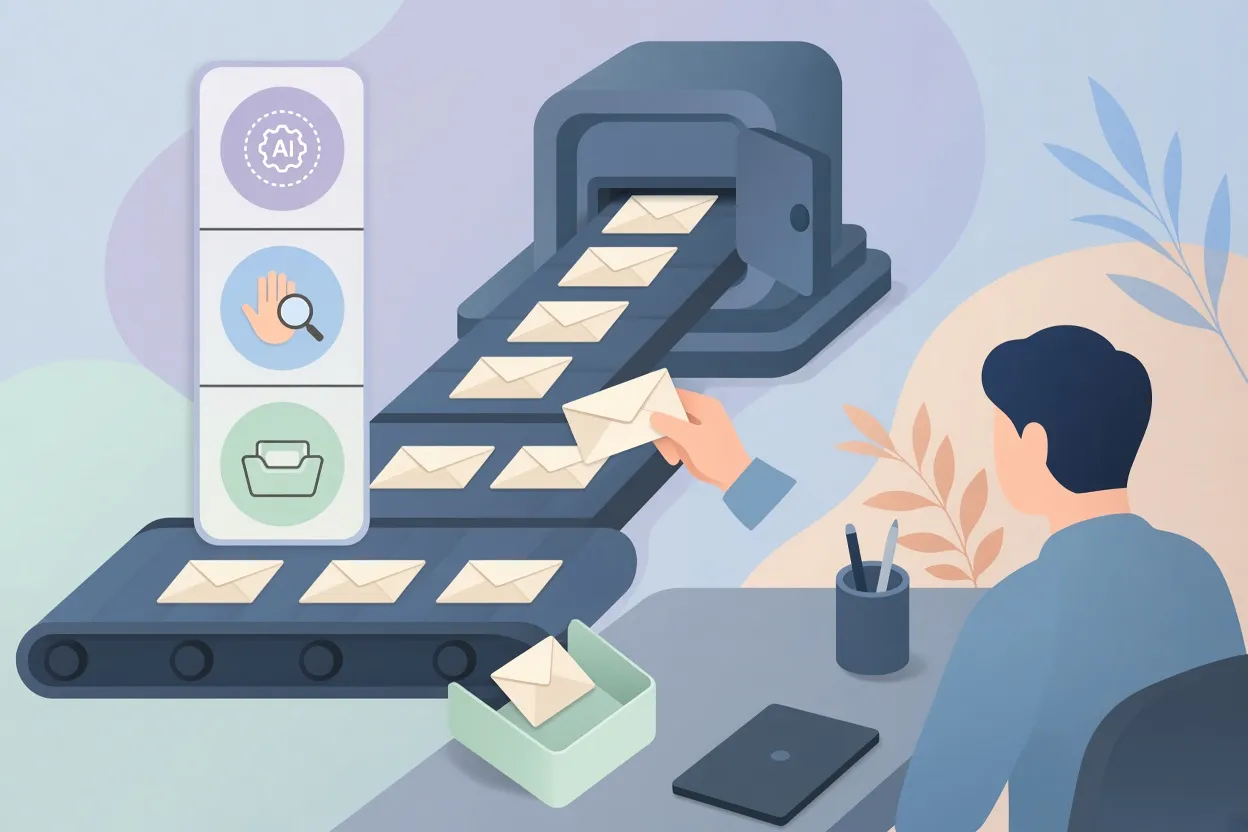
단일 cutoff가 통하는 이유는 실수의 비용이 싸기 때문입니다. 비서가 답하지 않으면 사람이 다시 멘션하면 그만입니다. 하지만 실수가 비싼 결정은 cutoff 두 개로 세 구간을 만들어야 합니다.
| 구간 | 조건 | 동작 |
|---|---|---|
| 자동 실행 | 확신이 높음 | 코드가 바로 처리 |
| 사람 검토 | 애매한 중간 | human-in-the-loop(사람이 개입하는 검토)로 escalation |
| 안전 기본값 | 확신 있는 '아니오' | 보수적인 기본 경로로 처리 |
환불 routing workflow가 좋은 예입니다. 환불 요청일 확률이 0.9를 넘으면 자동으로 환불 팀에 보내고, 0.4와 0.9 사이면 사람 검토로 보내고, 0.4 미만이면 일반 support로 보냅니다. Mastra에서는 이것을 AUTO와 REVIEW 상수 두 개를 둔 workflow의 분기로 구현합니다.
▲ cutoff 두 개로 나눈 세 구간
임계값은 평가 데이터로 정한다
0.45라는 숫자는 감으로 고른 것이 아닙니다. 실제 Slack thread를 모은 뒤 Claude를 써서 익명화된 평가 데이터셋으로 정리했고, 비서가 답해야 하는 경우 6건과 조용히 있어야 하는 경우 10건, 총 16건으로 구성했습니다. 예컨대 동료가 "sign-in link 다시 보내 줄 수 있어? 지난 건 만료됐어"라고 비서에게 이어 묻는 경우는 '답해야 함'이고, 비서가 요약을 올린 뒤 다른 동료가 질문자에게 "nice one"이라고 한 경우는 '답하지 말아야 함'입니다.
Mastra의 평가 suite는 classifier를 한 단계짜리 workflow로 실행한 뒤 custom scorer로 결과를 채점합니다. scorer는 LLM-as-a-judge(LLM이 채점하는 방식) 없이 평범한 TypeScript로 작성되며, 정답과 일치하면 1, 아니면 0을 돌려줍니다. runEvals로 전체 사례를 돌리고, 0.35, 0.40, 0.45, 0.50, 0.55 같은 후보 임계값을 순서대로 적용하는 threshold sweep으로 어느 값이 가장 잘 맞는지 확인합니다.
결과는 이랬습니다. 답하지 말아야 할 10건은 모두 0.39 이하였고, 답해야 할 6건 중 5건은 0.50 이상이었으며, 1건만 0.36으로 빗나갔습니다. 즉 0.39와 0.50 사이에는 어떤 임계값을 골라도 16건 중 15건을 맞히는 calibration gap(점수가 비는 구간)이 생겼습니다. 0.45는 이 구간의 한가운데로, production 메시지의 자연스러운 점수 변동을 흡수하기 위한 완충을 둔 값입니다.
임계값을 어느 쪽으로 치우치게 둘지는 실수의 비대칭에 달려 있습니다. 거짓 양성(불필요한 답)이 비싸면 높게, 거짓 음성(놓친 답)이 비싸면 낮게 잡습니다. Slack에서는 불필요한 답이 채널 소음이 되고 놓친 답은 재멘션으로 금방 해결되므로, 그 균형이 반영된 셈입니다.
작은 수정에도 확률이 크게 흔들린다
decision model은 prompt 문구와 schema 이름에 매우 민감합니다. 평가 중 입력 필드 이름 하나를 바꾸자, 조용히 있어야 할 사례의 점수가 0.39에서 0.86으로 뛰었습니다. 기준 설명에 단어 세 개를 더했더니 정확도가 16건 중 15건에서 13건으로 떨어졌습니다. 두 수정 모두 regression이었기 때문에 되돌렸습니다.
이 경험이 주는 교훈은 평가를 CI(코드를 합치기 전 자동으로 돌리는 검사) pipeline에 넣어야 한다는 것입니다. 무해해 보이는 한 줄 수정이 확률 분포를 바꿀 수 있으니, merge 전에 전체 benchmark를 다시 돌리는 것이 유일하게 믿을 만한 안전장치로 보입니다.
production 운영: 비동기 실행, 실패 처리, guardrail, 감사 로그
Slack API는 몇 초 안에 응답 확인을 요구하는데, 모델 호출을 기다리기에는 너무 짧습니다. 그래서 classifier 평가는 Slack의 요청-응답 창 바깥에서 비동기 background job으로 실행합니다. 확률이 0.45 미만이거나 classifier 호출 자체가 실패하면 비서는 조용히 있고, 그 메시지는 나중에 멘션될 때를 대비한 context로 보존합니다. 실패의 기본값이 '아무것도 하지 않음'인 것이 중요합니다.
agent의 입력 guardrail에도 같은 모델을 씁니다. Mastra에서는 ClassifierProcessor를 agent에 붙여 메시지가 주 모델에 닿기 전에 검사합니다. 예를 들어 support agent가 billing이나 계정 문제만 다루도록 기준을 두고, onResult hook에서 주제 밖 문의는 정해진 안내 문구로 중단시킵니다. classifier가 거부나 처리되지 않은 category를 돌려주면 주제 밖으로 간주해, 모델의 즉흥적인 답이 사용자에게 가는 것을 막습니다.
실패 처리는 errorStrategy로 정합니다. strict는 classifier가 실패하면 실행을 멈추고, warn은 오류를 기록한 뒤 메시지를 통과시킵니다. 입력 guardrail에는 strict를 써서 상류의 실패가 안전하게 메시지 수신을 막게 하는 편이 좋습니다. onDecision hook에서는 thread ID, 결과 상태, 분류된 답, 실행 시간, turn ID를 데이터베이스 감사 로그에 남기되 민감한 메시지 본문은 기록하지 않습니다. 더 엄격한 privacy 요건이 있으면 tracing 설정의 hideInput과 hideOutput으로 telemetry에서 사용자 텍스트를 제외할 수 있습니다.
모델 제공자를 바꿀 때 반드시 할 일
Mastra는 provider 연동을 추상화하므로 설정 한 줄로 OpenAI 모델에서 TypeSafe AI의 hosted Jev(jev-latest)나 self-hosted Kev(kev-9b)로 바꿀 수 있습니다. Kev는 Jev와 API를 공유하지만, Cloudflare Workers AI에서 돌리려면 현재는 작은 proxy worker가 필요하거나 open weights를 직접 호스팅해야 해서 한 줄 교체만큼 매끄럽지는 않습니다.
더 중요한 주의점은 calibration이 모델 사이에 이전되지 않는다는 사실입니다. OpenAI에서의 0.45는 Jev나 Kev에서의 0.45와 같은 확신 수준이 아닙니다. 모델을 바꾸면 평가 suite를 새 모델에 다시 돌려 임계값 기준선을 새로 잡아야 합니다.
정리: 모델은 확률, 코드는 결정
이 접근의 뼈대는 한 문장으로 요약됩니다. decision model은 깨끗한 확률을 내고, 임계값과 fallback, 안전 기본값은 애플리케이션 코드가 책임집니다. 직접 적용해 본다면 다음 순서가 적절해 보입니다.
- 판단을 세 갈래로 나눕니다. 정답이 하나인 규칙은 코드로, 텍스트 생성은 생성형 LLM으로, 애매한 판단만 decision model로 보냅니다.
- 필요한 질문을 Boolean, Choice, Score로 정의하고 한 요청에 묶어 state를 한 번만 읽게 합니다.
- 정답을 아는 실제 사례로 평가 데이터셋을 만들고, threshold sweep으로 점수 gap을 찾아 그 중간에 임계값을 둡니다.
- 실수가 싼 결정은 단일 cutoff, 비싼 결정은 자동 실행·사람 검토·안전 기본값의 세 구간으로 설계합니다.
- 임계값은 이름 붙은 상수로 두고 단위 테스트를 작성합니다.
- 평가를 CI에 넣고, prompt 문구나 필드 이름, 모델 제공자를 바꿀 때마다 전체 benchmark를 다시 돌립니다.
- 실패 시 기본 동작은 '아무것도 하지 않음'으로 두고, 감사 로그에는 민감한 본문 대신 ID와 점수, 소요 시간만 남깁니다.


