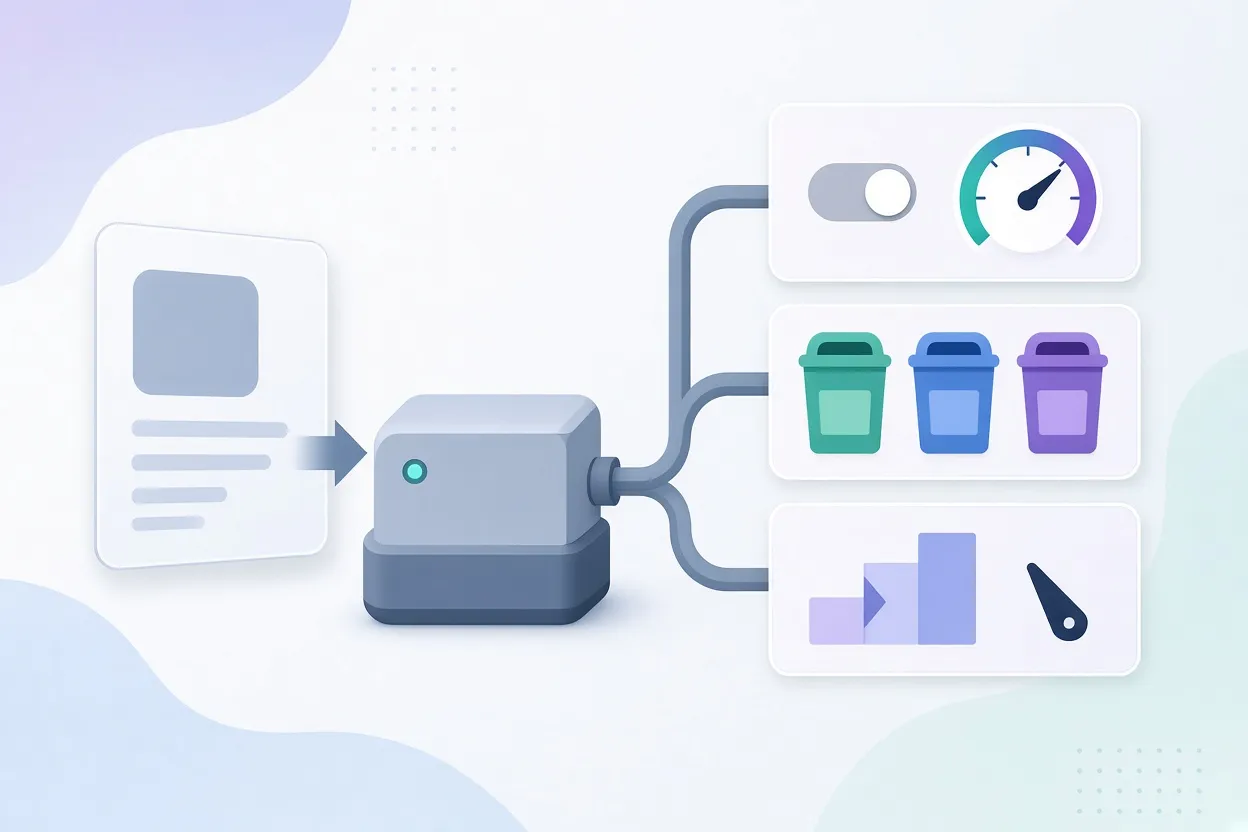
多くのAIエージェントは、いまも振り分けの判断を遠回りな方法で行っています。チャットモデルにイエスかノーかの質問を投げ、JSON文字列が1トークンずつ生成されるのを待ち、その結果を解析するという手順です。これに対し、一般に「決定モデル」と呼ばれる新しい種類のモデルは、テキスト生成をまるごと省きます。文脈となる情報と、許可された答えの固定リストを与えると、決定モデルは1回の順伝播で各答えに対する較正済みの確率を返します。そのため生成モデルの呼び出しより高速で安価であり、ルールとして書き下すのは難しいものの、言語モデルの本格的な応答を使うほどではない曖昧な判断という、特定の仕事にぴったり合います。この分野の製品には、TypeSafe AIのJev、OpenAIのDecisions API、CloudflareのClefに加えて、Kevというオープンソースモデルがあります。ただし注意点があります。確率はそれ単体では何もしません。本当のエンジニアリングは、数値を信頼できる動作に変えるしきい値、予備動作、評価スイートの中にあります。
決定モデルが解決する問題
具体例を挙げると用途がはっきりします。あるチームが、会話スレッドに参加する社内向けのSlackアシスタントを作りました。スレッド内で一度呼び出されると、このアシスタントは、同僚同士が単にお礼を言い合っているようなやり取りも含めて、その後のすべてのメッセージに答えようとしました。わかりやすい対処法は、毎回ボットを@メンションするよう求めることですが、これでは会話がぎこちなく機械的に感じられます。より良い対処法は、返信のたびに「このメッセージは本当にアシスタントに向けられたものか、それともスレッド内の人間に向けたものか」を素早く確認することでした。
この確認はすべてのメッセージで実行されるため、非常に高速で非常に安価でなければなりません。また、厳密なルールではなく曖昧な判断でもあります。この組み合わせこそ、決定モデルが作られた目的そのものです。
決定モデルへのリクエストの仕組み
決定モデルへのリクエストは3つの部分で構成されます。
- 状態(state): モデルに評価させる文脈オブジェクト。スレッドの履歴やサポートチケットなど。
- 質問(questions): その状態について知りたいこと。
- 許可された答え(allowed answers): 各質問に対して厳密に定義された選択肢の集合。
モデルは文字列を生成しません。状態に基づいて、許可された選択肢に確率を割り当てます。エージェント構築のためのオープンソースのTypeScriptフレームワークであるMastraには、こうしたモデル向けの分類器プリミティブが同梱されており、3種類の質問タイプが使えます。
| 質問タイプ | 与えるもの | 返ってくるもの |
|---|---|---|
| Boolean | 真偽を問う質問 | 答えが真である確率が1つ(1に近いほど強い「はい」、0に近いほど強い「いいえ」) |
| Choice | billing、support、salesのような、基準の説明を添えたラベルの集合 | すべてのラベルに対する確率 |
| Score | バグの深刻度0から2のような、順序付きの数値ルーブリック | 各レベルの確率と、加重平均スコア |
サポートチケットを使った実例で、3つすべてを一度に見てみましょう。「今月2回請求されました。片方を取り消してもらえますか?」というメッセージに対し、返金に関するBoolean判定は0.95を返しました。Choiceルーターはbilling、support、salesにまたがる確率を出しました。0を見た目の問題、1を回避策あり、2を回避策なしで作業不能とするルーブリックを使ったScore質問は、レベル0に12%、レベル1に72%、レベル2に16%を返し、加重した深刻度スコアは1.03でした。
▲ Boolean・Choice・Scoreを1回で返す出力
Mastraでは、Boolean、Choice、Scoreの質問を1回の分類器呼び出しにまとめられるため、状態を何度も往復して読むのではなく一度で読み込めます。TypeSafe自身のガイダンスも同じ方向を示しています。条件付きの呼び出しを順番に発行するのではなく、コードが必要とする可能性のあるすべての質問を1回のリクエストで尋ね、使わない出力は無視するという考え方です。リクエストあたりの上限はプロバイダーごとに異なり、OpenAIのDecisions APIは最大400問、Cloudflare Clefは最大64問、Jevは64,000トークンのコンテキストウィンドウに収まる限りの数を受け付けます。
高速で安価な理由
速度の差はアーキテクチャから生まれます。標準的なチャットモデルは自己回帰ループを回します。語彙全体にわたる確率分布を計算し、トークンを1つサンプリングして末尾に追加し、JSONの答えが完成して解析できるようになるまでこれを繰り返します。決定モデルは状態と質問に対して1回の順伝播を行い、許可されたカテゴリーの確率を直接出力します。サンプリングのループも出力テキストもありません。
何も生成しないため、これらのAPIでは出力トークンは無料です。比較時点での入力トークンの価格は次のとおりでした。
| プロバイダー | 入力100万トークンあたりの価格 |
|---|---|
| Cloudflare Clef-flash | $0.038 |
| TypeSafe AI Jev | $0.042 |
| OpenAI Decisions API | $0.10 |
| Cloudflare Clef | $0.24 |
どの仕事にどのツールを使うか
決定モデルは、生成モデルも通常のコードも置き換えません。アプリケーションのロジックを3つに分ける考え方が役に立ちます。
- 生成LLMは、自由記述の文章作成、要約、説明に使います。決定モデルは要約も創造的な文章作成もできず、思考の連鎖による推論も示せません。
- 決定論的なコードは、答えが一つに定まる厳密なビジネスルールに使います。「$500を超える返金にはマネージャーの承認が必要」や「プロジェクトを削除できるのは管理者だけ」はif文に書くべきもので、確率モデルに任せてはいけません。
- 決定モデルは判断を要する場面に使います。緊急度の検出、チケットの部門への振り分け、アシスタントが発言すべきかどうかの判断などです。
しきい値はコードに置く
決定モデルは確率を返すだけで、行動はしません。次に起きることは、その確率を定数と比較する、ごく普通のアプリケーションコードの1行です。Slackアシスタントの場合、0.45というしきい値との比較が1つあるだけです。この値以上ならボットは返信し、未満なら黙っています。
しきい値をコードに置くことには実用上の利点があります。モデルを実際に呼び出すことなく、分岐ロジックを決定論的にユニットテストできます。定数は名前の付いた1つの変数に収まっているので、変更は1行だけのきれいなプルリクエストになり、レビュアーが追跡できます。
区切りを1つだけにするのが適切なのは、誤った判断の代償が小さい場合に限られます。Slackアシスタントはこれに当てはまります。ボットが誤って黙っていても、誰かがもう一度メンションすれば数秒で解決します。一方、不要な返信はチャンネルのノイズを増やします。この非対称性がしきい値の位置を決めます。一般的なルールは、偽陽性の代償が大きいときは高く、偽陰性の代償が大きいときは低く設定することです。
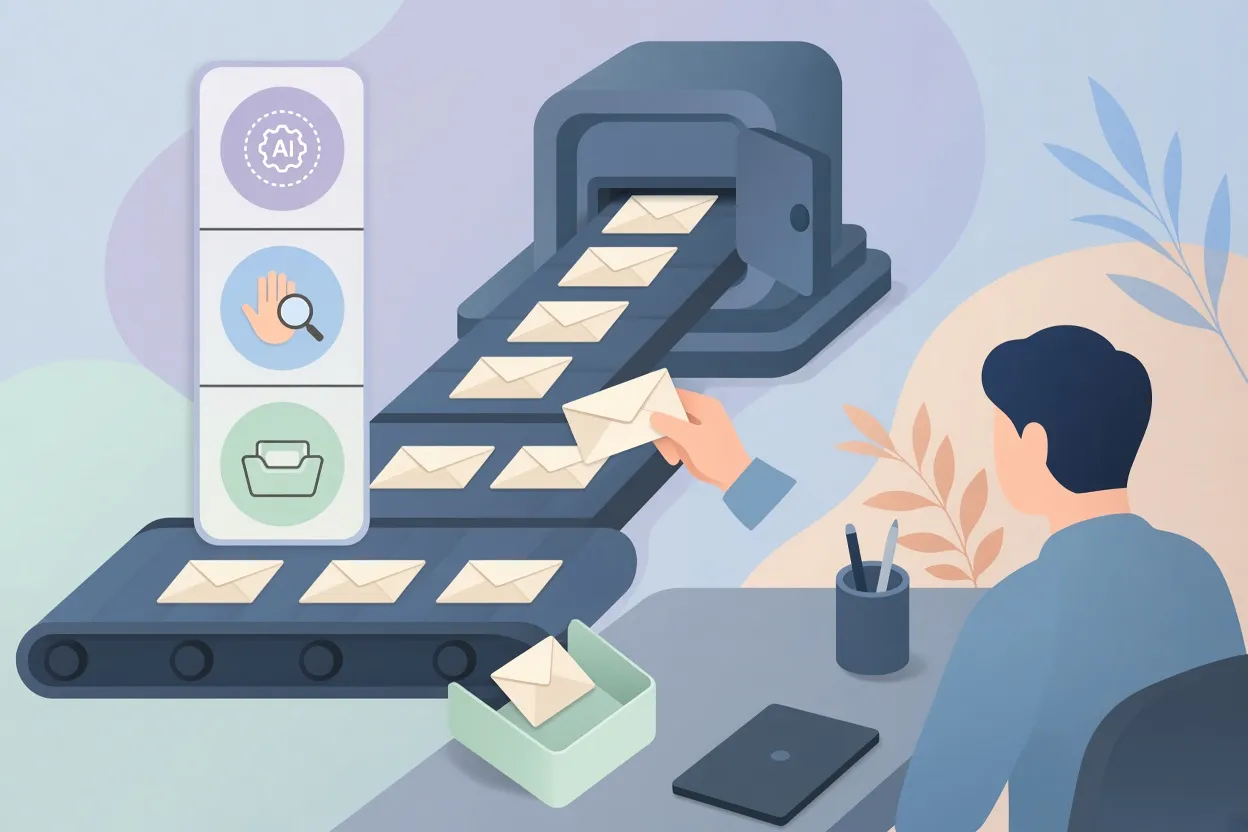
それほど寛容ではない判断には、2つの区切りと3つの帯を使います。
- 上の区切りより上: 自動で実行する。
- 2つの区切りの間: 人の確認に回す。
- 下の区切りより下: 安全なデフォルトの動作をとる。
Mastraで構築した返金の振り分けワークフローは、自動化の区切りを0.9、確認の区切りを0.4としてこれを示しています。返金確率が0.9を超えればチケットは返金チームに直行し、0.4から0.9の間なら手動確認へ、0.4未満なら一般サポートに回ります。
▲ 2つの区切りが作る3つの行動帯
評価セットでしきい値を見つける
0.45という数字は当てずっぽうではありません。チームは実際のSlackスレッドのやり取りを集め、Claudeを使って匿名化した16件の評価データセットに仕立てました。アシスタントが返信すべきケースが6件、黙っているべきケースが10件です。返信ケースの一例では、同僚がボットに会社レコードの追加を頼み、ボットができないと説明し、同僚が続けて新しいサインインリンクを要求しています。返信しないケースの一例では、ある人がその日CRMで出荷された内容の要約を求め、ボットが答え、別の人が最初の人に「ナイス」と声をかけています。
評価は、単一ステップのMastraワークフローの中で分類器を実行し、素のTypeScriptで書いた独自のスコアラーで結果を採点します。判断が正解ラベルと一致すれば1、しなければ0です。LLMを審査役にする仕組みは使っていません。MastraのrunEvalsがラベル付きサンプルを1件ずつワークフローに流し、プログラムによる探索で複数の候補しきい値(0.35、0.40、0.45、0.50、0.55)を試して、セット全体で精度がどう変わるかを調べます。同じ分類器スコアラーは、コストと速度が重要なより大規模な評価パイプラインで、LLM審査役の代わりにもなります。
結果には明確な隙間が現れました。返信しない10件はすべて0.39以下でした。返信すべき6件のうち5件は0.50以上で、外れ値の1件が0.36でした。したがって0.39と0.50の間のどのしきい値でも、16件中15件という同じ精度になります。しきい値は、実際の本番メッセージに自然に生じるばらつきを吸収するため、この隙間の中央である0.45に置かれました。スコアは3回の実行で確認し、安定していることを確かめています。
言葉遣いに敏感なモデル
2つの小さな実験が、体系的な評価が欠かせない理由を示しています。入力フィールドを1つ、アシスタントの会話を軸にした名前からlater_repliesに改名しただけで、返信しないケースの1件が0.39から0.86に跳ね上がり、沈黙から返信へと反転しました。基準の指示にアシスタントの名前を挙げる3語を加えると、精度は16件中15件から16件中13件に落ちました。どちらの変更も無害に見えましたが、どちらも退行であり、元に戻されました。教訓は、評価スイートを継続的インテグレーションで実行し、ベンチマークに合格しない限りプロンプトやスキーマの変更をマージできないようにすることです。
本番環境で動かす
決定モデルを稼働中のシステムに組み込むと、いくつかの細部が重要になります。
Webhookの時間制限を回避する。 Slackは数秒以内の応答確認を要求しており、モデル呼び出しをブロックして待つには短すぎます。アシスタントは即座に応答確認を返し、分類器は非同期のバックグラウンドジョブで実行します。確率が0.45を下回った場合、あるいは分類器の呼び出し自体が失敗した場合、ボットは黙ったまま、そのメッセージを将来のメンションに備えた文脈として保持します。
分類器を入力ガードレールとして使う。 Mastraでは、ClassifierProcessorをエージェントに取り付けて、受信メッセージがメインのモデルに届く前に検査できます。たとえばサポートエージェントの範囲を請求とアカウントの質問に限定し、onResultフックで話題外のリクエストを中断して定型メッセージを返すといった使い方です。分類器が拒否や未対応のカテゴリーを返した場合は、メインのモデルに即興で対応させるのではなく、話題外として扱います。
失敗時の振る舞いを決める。 errorStrategyの設定は、分類器そのものが失敗したときの動作を制御します。strictは実行を停止し、warnはエラーを記録してメッセージを通します。ガードレールにはstrictのほうが安全です。上流の失敗が、メッセージを黙って素通りさせるのではなく、取り込みをブロックするからです。
機密情報を残さずに判断を記録する。 onDecisionフックを使えば、スレッドID、結果、分類された答え、実行時間、ターンIDを監査エントリーとしてデータベースに書き込み、メッセージの生テキストは保存しないようにできます。機密性の高いやり取りでは、MastraのトレーシングオプションhideInputとhideOutputにより、ユーザーのテキストをテレメトリーから除外できます。
プロバイダーの切り替えは再較正を意味する
Mastraはプロバイダーを抽象化しているため、分類器をOpenAIからTypeSafe AIがホストするJev(jev-latest)や自前でホストするKev(kev-9b)に移すのは、TypeSafeAIクライアントアダプターを使った1行の設定変更で済みます。KevはJevとAPIを共有していますが、Cloudflare Workers AIで動かすには現時点で小さなプロキシワーカーかローカルでホストするオープンウェイトが必要で、この乗り換えはやや手間がかかります。
しかし、この1行の変更は見かけほど単純ではありません。確率の較正はモデル間で引き継がれません。OpenAIの0.45は、JevやKevの0.45と同じ意味ではないのです。プロンプトの編集と同じく、プロバイダーを切り替えるたびに評価スイート全体を再実行し、しきい値を改めて探索して新しい基準線を確立する必要があります。
押さえておきたいこと
役割分担は簡潔に言い表せます。決定モデルは、明示的に許可された答えに対するきれいで較正済みの確率を出力し、しきい値、分岐、予備動作、フェイルセーフのデフォルトを含むそれ以外のすべてをアプリケーションコードが受け持ちます。これを実践したい開発者には次の点をお勧めします。
- 決定モデルは曖昧な判断のためにとっておく。厳密なルールはコードに、自由記述のテキストは生成モデルに任せる。
- すべての質問を1回の分類器呼び出しにまとめ、文脈を一度だけ読み込む。
- しきい値を1つだけにするのは、誤りの代償が小さく自然に修正される場面に限る。そうでなければ、2つの区切りの間に人の確認帯を設ける。
- 実際のケースからラベル付きの評価セットを作り、候補のしきい値を探索して、観測された隙間の中央に区切りを置く。
- スイートをCIで実行し、プロンプト、スキーマ、プロバイダーの変更を出す前に必ず再実行する。
- Webhook駆動のプラットフォームでは時間のかかる確認をバックグラウンドジョブで行い、ガードレールにはstrictなエラー処理を選び、機密テキストをログやトレースに残さない。
こうしておけば、決定モデルは予測不能な託宣ではなく、小さくテスト可能な部品になります。そしてその周りに構築したエージェントは、テストし、レビューし、信頼できる振り分けの判断を下せるようになります。


