Claude Fable 5.2はAnthropic最強のモデルですが、料金もそれに見合って高額です。Opus 5.5の2倍、入力トークンではHaiku 5.5の80倍にあたります。すべての作業にFable 5.2を使えば、サブスクリプションの上限にすぐ達してしまいます。Anthropic自身のモデルガイドに加え、Claude Codeの開発者とアンドレイ・カルパシー氏が公開している助言をたどると、要所でFableの判断力を手放さずに費用を抑えるための、いくつかの設定と習慣が見えてきます。Opus 5.5のMedium effortを既定にする、バックグラウンドの補助エージェントをHaiku 5.5に固定する、推論のeffortを抑える、Fable 5.2は計画と最終レビューに限る、というものです。同じく重要なのは、作業を複数のモデルに分けると節約よりコストがかさむのはどんな場合かを知ることです。
Fable 5.2の料金と、上限がすぐ消える理由
Fable 5.2は現在、主要ベンチマークで首位に立っています。FrontierCode 2.0ではHigh effortで49.1%を記録し、Opus 5.5(45.5%)、Gemini 4 Carbon(48.1%)、GPT-6 Astra(42.8%)、前世代のFable 5.1(32.4%)を上回ります。FrontierSWE v2では69.9%に達し、Opus 5.5の62.3%、GPT-6 Astraの65.5%、Gemini 4 Carbonの61.2%を凌いでいます。
Anthropicの各ティア間の価格差は大きいです:
| モデル | 入力100万トークンあたり | 出力100万トークンあたり |
|---|---|---|
| Fable 5.2 | $8 | $40 |
| Opus 5.5 | $4 | $20 |
| Sonnet 5.5 | $2 | $10 |
| Haiku 5.5 | $0.10 | $0.50 |
7万5,000語の入力と1万5,000語の出力という典型的な文書作業では、Fable 5.2でおよそ$1.60、Opus 5.5で$0.80、Haiku 5.5では$0.01 ~ $0.02になります。
サブスクリプション利用者には、同じ差がクォータとして現れます。MaxプランとUltraプランでは、Fable 5.2は通常の週間利用枠の半分を上限として含まれるため、他のモデルよりはるかに速くクォータを消費します。Proプランでは、Fable 5.2が同梱されるのはローンチ週の2026年11月16日までで、それ以降の利用は有料クレジット課金になります。AnthropicでClaude Codeを生み出したボリス・チェルニー氏は、Fable向けのロイヤルティリセットも発表しています。契約期間が6か月未満のアカウントには1回、6 ~ 12か月には2回、12か月超には3回のリセットが付与されます。
第1のレバー: Opus 5.5のMediumを既定にする
Anthropicのガイドとカルパシー氏は、同じ基本方針を勧めています。Claude Codeとデスクトップアプリでは、日常の主力としてOpus 5.5をMedium effortで動かし、Fable 5.2は最難度のタスクや無人で走らせる夜間ジョブに限って使うというものです。カルパシー氏自身も自分のプロジェクトでこの既定を使っています。一度設定しておけば、高価なモデルは意図的に選んだときにしか動かなくなるため、うっかりFableを使って費用を膨らませる事態のほとんどを防げます。
第2のレバー: 検索・読み取りの補助エージェントをHaiku 5.5に固定する
Claude Codeで最も見えにくいコストは、サブエージェントから生じます。メインの会話の外でファイルを検索し、コードベースを読み込むバックグラウンドの補助役です。組み込みのExploreサブエージェントは、1セッションで何十回も走ることがあります。Anthropicのドキュメントによれば、Exploreの既定はHaikuではなく、セッションの親モデル(上限はOpus 5.5)です。したがってFable 5.2のセッションでは、自動的な参照のすべてがOpus価格で動き、ファイル検索1回あたり約$0.15かかります。
カスタムのサブエージェントはさらに深刻です。Opusという上限がないため、設定していない補助エージェントはFable 5.2をそのまま継承し、単純なテキスト読み取りに入力$8、出力$40を請求します。
対策は1行の編集です。Claude Codeのagentsフォルダに、属性をHaikuに設定したExploreサブエージェントを定義し、検索・読み取り・要約を担うカスタム補助エージェントにも同じ設定を施します:
- Claude Codeのagentsディレクトリで、Exploreエージェントの定義を開くか新規作成する。
- エージェントの設定に
model: haikuを追加する。 - 読み取り、検索、要約を担うカスタム補助エージェントすべてに同じ作業を繰り返す。
価格表を定義しているファイルを探すようClaude Codeに依頼したテストでは、Opusで動くExploreエージェントのコストは約$0.15でした。Haiku 5.5に固定した後、同じ問い合わせは同じファイルの同じ行を1セント未満で返し、およそ50分の1に下がりました。このルールの根拠は、検索や要約のタスクでは誤りを見つけやすく、深い推論を要しないため、最も安いモデルが適任だという点にあります。Anthropic自身も社内で同じ論理を適用し、バックグラウンドのサブエージェントからの30秒ごとの状況更新をHaiku 5.5による短いメモに切り替え、その更新コストを99%削減しました。
▲ 定型的な検索はHaiku 5.5に振り分け
第3のレバー: effortはMediumに保ち、継承先に目を配る
Effortは、モデルが回答前にどれだけ長く推論するかを決めます。設定はLow、Medium、High、Extra High、Maxの5段階で、ClaudeアプリとClaude Codeの既定はMediumです。Anthropicのガイドは、より高価なティアに上げる前に、現在のモデルでeffortを調整するよう助言しています。
コストの曲線は急です。AnthropicのFrontier Coding Benchmarkでは、Fable 5.2の結果は次のとおりです:
| Effort | スコア | タスクあたりのコスト |
|---|---|---|
| Medium | 37.6% | $2.48 |
| High | 45.3% | $6.72 |
MediumからHighに上げると、精度が約8ポイント伸びる代わりにコストはほぼ3倍になります。Highより上では、1段階上げるだけで、モデルのティアを丸ごと1つ上げるのと同じくらいの費用になることがあります。あるソフトウェアエンジニアがFable 5.2で単一のプロンプトを試したテストは、この急上昇を示しています:
| Effort | コスト | 時間 |
|---|---|---|
| High | $24.31 | 1時間5分 |
| Extra High | $43.79 | 3時間9分 |
| Max | $87.99 | 3時間28分 |
| Ultra | $642.42 | 10時間21分 |
チェルニー氏は、クォータの急速な枯渇は、たいていExtra High effortの1、2セッション、エージェントチーム、長時間のSDKジョブのいずれかに原因をたどれると述べています。隠れた乗数は継承です。サブエージェントは親セッションのeffortレベルを引き継ぐため、Highのセッションでは、バックグラウンドの検索・読み取りの補助エージェントもすべてHighで推論させられます。役立つ習慣は2つあります。以前のセッションの設定が静かに残っていることがあるので、大きなタスクを始める前にeffort設定を確認すること、そしてClaude Codeで/usageコマンドを実行し、セッションやサブエージェントをまたいでトークンがどこに使われているかを把握することです。
Fable 5.2が割高な料金に見合う場面
Opus 5.5を既定にし、補助エージェントをHaikuに固定し、effortをMediumに保てば、主な無駄は消えます。残る問いは、Fable 5.2に2倍を払うことがコスト以上の見返りをもたらすのはどこか、です。Anthropicは、同じバックログのタスクをOpusとFableの両方で実行し、/usageの数値を比べることを勧めています。
そうした比較の一つでは、意図的に7つの欠陥を仕込んだクライアントのオンボーディング文書を使い、両モデルに同じプロンプトを与えました。Opus 5.5は約$0.20で7つすべてを見つけました。Fable 5.2も7つすべてを見つけたうえ、Opusが見落とした構造上の問題をさらに8件指摘しました。たとえば、関係終了時にクライアントのアクセス権を取り消す手順が欠けている点です。OpusもFableが見つけなかった問題を2件捉えており、差し引きでFableが6件多く発見し、費用は約$0.35、割増分はおよそ$0.15でした。
実践的な結論は分担です。作業の90 ~ 95%の下書きと実行はOpus 5.5で行い、Fable 5.2は残りの5 ~ 10%、すなわち深い判断が価格を正当化するレビュー工程に使います。
10-80-10の分担と、それが裏目に出る場合
自然な拡張が、古典的な10-80-10の委任パターンです。最上位モデルが仕事を計画し(最初の10%)、Haiku 5.5やSonnet 5.5のような安価なワーカーが大部分を実行し(中間の80%)、最上位モデルが結果を確認する(最後の10%)という流れです。Anthropicのプロンプトエンジニアリングガイドも似た設計を推奨しており、Fable 5.2をプランナー兼オーケストレーターに据え、HaikuやSonnetにログの読み取り、ファイル検索、要約を任せます。独自のハーネスは不要で、Claude Codeに仕事の計画とサブエージェントの起動を自ら行うよう指示できます。たとえば、スクリプトの校正、フックのバリエーション生成、説明文の下書きを3つの補助エージェントで並行して進めるといった形です。
落とし穴は、これを小さな仕事に適用することです。ある動画チャンネルの指標を監査し、上位10本の動画を約1万6,000回という再生回数の中央値と比べて今後のテーマを計画するテストでは、3つの構成の請求額が大きく分かれました:
| 構成 | コスト | 時間 |
|---|---|---|
| Fable 5.2単体 | $0.58 | 約1分 |
| Opus 5.5単体 | $0.51 | 約1.5分 |
| Fable 5.2がHaikuとSonnetのサブエージェントを指揮 | $2.50 | — |
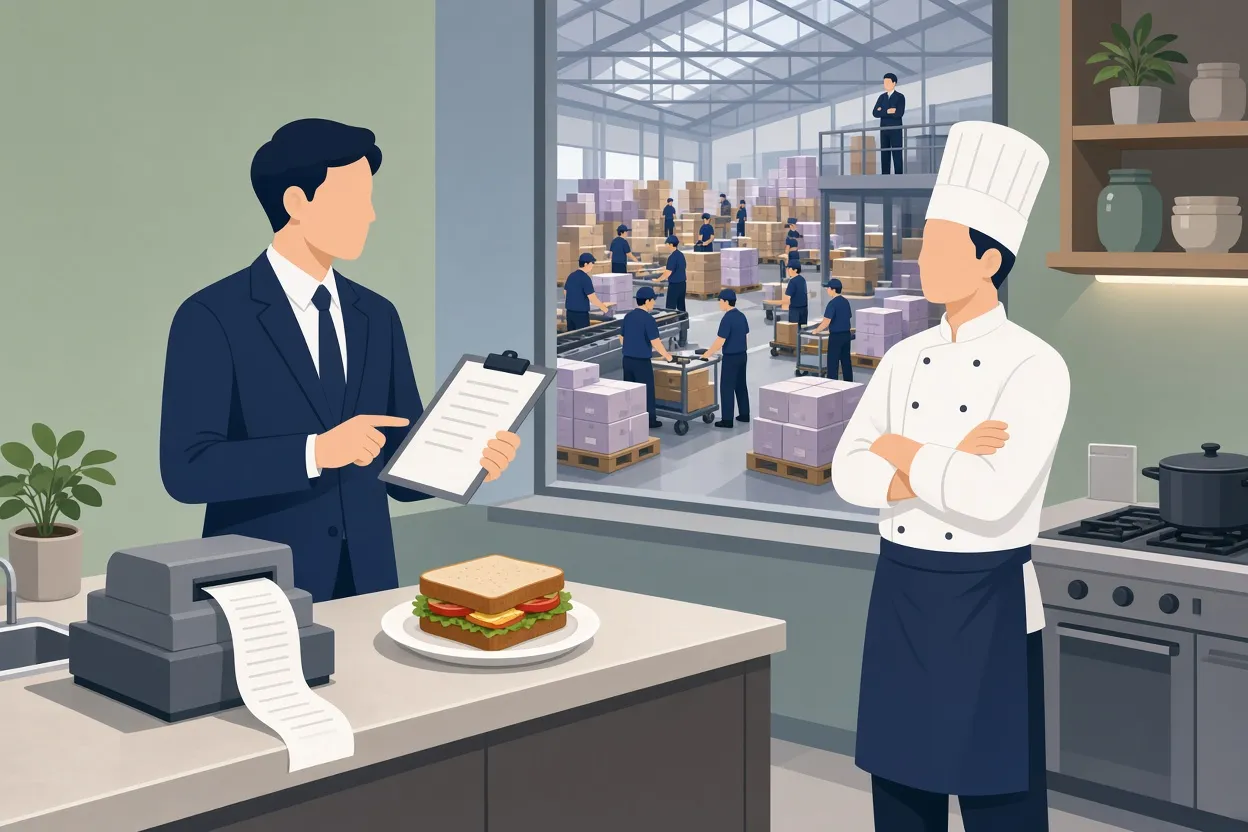
オーケストレーションした実行は、Fable単体の5倍近いコストになりました。この結果は最初はバグのように見えましたが、実際は調整のオーバーヘッドです。サンドイッチを作るためにプロジェクトマネージャーを雇うようなものです。マネージャーは計画を立て、指示書を書き、待ち、検査し、フィードバックを返す必要があり、そのすべてが、熟練した作業者が黙って作るより高くつきます。AIに置き換えると、オーケストレーターは詳細な指示書を書き、報告書を全文読むのに高価なトークンを費やし、一方で各サブエージェントはコンテキストファイルを最初から読み直します。Anthropicのドキュメントも同じことを率直に述べています。単一のコンテキストウィンドウに収まるタスクでは、マルチエージェントのオーケストレーションは通常、節約分よりコストのほうが大きくなります。
▲ 小さなタスクでのオーケストレーションの負担
分かれ目は、中間の80%の大きさです。Fableによる計画とレビューのコストは、仕事が極小でも巨大でもほぼ同じなので、委任が報われるのは、大部分の作業がその固定オーバーヘッドを吸収できるほど大きい場合に限られます。50本分の動画トランスクリプトを丸ごと分析する作業は該当します。トークンの大半を読み取りが占め、Haikuは100万トークンあたり$0.10で読むのに対し、Fableは$8だからです。メールの下書き、バグ1件の修正、5 ~ 10本の動画指標の分析は該当しません。管理のためのトークンが請求額の大半を占めてしまいます。課金ファイルの3行の修正は、Fableの単一セッションのほうが速くて安上がりです。Anthropicは大規模ワークロードの事例を、2,200万トークンのソースコードにまたがる欠陥探索ベンチマークで実証しました。Opus 5.5がSonnet 5.5のワーカーを指揮する構成は、Opus単体と同等の精度で、コストを3分の1少なく抑えて完了しました。またAnthropicは、Fableにサブエージェントの価格を伝え、委任が割に合うかを検討するよう指示すると、不必要なサブエージェントの起動がおよそ半分に減ることも確認しています。
安価なモデルには新入社員のように指示を出す
Fable 5.2は簡潔な指示から意図を推測できます。最上位モデルでは手の込んだプロンプトエンジニアリングがほぼ不要に見えるのはこのためです。Sonnet 5.5とHaiku 5.5の振る舞いは異なります。最小限のコンテキストしか与えられないと推測で補い、その推測が出力の質を下げます。「競合の動画を調べて要約して」のような曖昧な依頼では、どのチャンネルか、どの期間か、何を「良い」とみなすかについて、安価なモデルが勝手に前提を作り上げることになります。
有効なパターンは、安価なモデルに仕事を渡す前に、Fableに次の5要素を含む指示書を書かせることです:
- ゴール: 全体の目的
- 最終成果物: 納品物の正確な形
- ルール: 厳守すべき運用上の制約
- 禁止事項: やってはいけないこと
- 行き詰まったとき: 代替の振る舞い
優れた指示書があっても、低価格モデルは時折ミスをします。だからこそ、Fableによる最終レビューはワークフローの一部として残しておきます。
新モデルが出るたびにプロンプトとスキルを監査する
Anthropicで開発者向けリレーションを率いるアレックス・アルバート氏は、新モデルがリリースされるたびに行う習慣を共有しています。すべてのプロジェクトリポジトリに対して単一のプロンプトを実行し、壊れている、一貫性がない、あるいは古くなったコードや設定ルールを見つけさせ、確信が持てるものは修正し、残りは人間のレビュー用に一覧にさせるというものです。同じ手法はAIワークスペース全体に広げられます。ClaudeのスキルはMarkdown形式の指示ファイルで、古くなったり雑になったりしたスキルは、それを実行するすべてのモデルの質を引き下げます。Fable 5.2に厳しい制約付きでスキルを書き直させれば、たとえばフック作成スキルを12語以内に制限するといった形で、HaikuやSonnetがそれを実行するたびに出力が改善します。これは継続的なオーケストレーションではなく1回限りの作業なので、フロンティアモデルの最もレバレッジの高い使い方の一つかもしれません。
まとめ
以上のルールは、Claude Codeの3つの設定変更に集約できます:
- Haiku 5.5に設定した専用のExploreエージェント定義。ファイル参照がOpusで走らなくなる。
- CLAUDE.mdに置く委任のガードレール。作業を分割する前にClaudeにタスクの規模を判断させ、補助エージェントを安価なティアに限定し、サブエージェントの価格を記載してオーケストレーターに起動コストを認識させる。
- 明示的に呼び出したときだけ動く、Fable 5.2に設定したオンデマンドのレビュー担当エージェント。完成したスクリプトやコード変更のレビューなどに使う。
今日から動きたい読者は、Opus 5.5のMediumを既定にし、読み取り・検索・要約の補助エージェントをすべてHaiku 5.5に固定し、大きなセッションの前に毎回effortレベルを確認し、/usageを定期的にチェックしてください。小さな仕事は1つのモデルのセッション内で完結させます。Fable 5.2は、計画、最後の5 ~ 10%のレビュー、単一のコンテキストウィンドウに収まらないワークロード、そして新モデルが登場するたびのプロンプト・スキル・設定ファイルの1回限りの監査に取っておきましょう。


