Claude Fable 5.2 是 Anthropic 目前最强的模型,定价也与之相称:是 Opus 5.5 的两倍,输入 token 价格更是 Haiku 5.5 的 80 倍。谁要是把所有任务都交给它,很快就会撞上订阅额度的上限。Anthropic 自己的模型指南,加上 Claude Code 创造者和安德烈·卡帕西公开给出的建议,指向了几项设置和习惯:它们能在不牺牲 Fable 关键判断力的前提下压低账单,具体做法是把中等推理强度的 Opus 5.5 设为默认,把后台辅助智能体固定到 Haiku 5.5,控制好推理强度,并把 Fable 5.2 留给规划和最终审查。同样重要的是,要知道把工作拆给多个模型什么时候反而比省下来的更贵。
Fable 5.2 的成本,以及额度为什么消失得这么快
Fable 5.2 目前在各大基准测试中领先。在 FrontierCode 2.0 上,它以高推理强度拿到 49.1%,领先 Opus 5.5(45.5%)、Gemini 4 Carbon(48.1%)、GPT-6 Astra(42.8%)和前代 Fable 5.1(32.4%)。在 FrontierSWE v2 上,它达到 69.9%,而 Opus 5.5 为 62.3%,GPT-6 Astra 为 65.5%,Gemini 4 Carbon 为 61.2%。
Anthropic 各档模型之间的价格差距相当陡:
| 模型 | 每百万输入 token | 每百万输出 token |
|---|---|---|
| Fable 5.2 | $8 | $40 |
| Opus 5.5 | $4 | $20 |
| Sonnet 5.5 | $2 | $10 |
| Haiku 5.5 | $0.10 | $0.50 |
一个典型的文档任务,输入 75,000 词、输出 15,000 词,在 Fable 5.2 上大约花 $1.60,在 Opus 5.5 上约 $0.80,在 Haiku 5.5 上只需 $0.01-0.02。
订阅用户感受到的差距则体现在配额上。在 Max 和 Ultra 套餐中,Fable 5.2 最多只包含在正常每周额度的一半以内,因此消耗配额的速度远快于其他模型。在 Pro 套餐中,Fable 5.2 仅在发布周内捆绑提供,截止到 2026 年 11 月 16 日;此后使用将按付费积分计费。Anthropic 的 Claude Code 创造者 Boris Cherny 还宣布了针对 Fable 的忠诚度重置:订阅不满六个月的账户获得一次重置,六到十二个月获得两次,超过十二个月获得三次。
第一招:把中等强度的 Opus 5.5 设为默认
Anthropic 的指南和卡帕西给出了同一个基线:在 Claude Code 和桌面应用中,以中等推理强度运行 Opus 5.5 作为日常主力,只在最难的任务或无人值守的通宵作业中才动用 Fable 5.2。卡帕西自己的项目就采用这一默认设置。设置一次就能避免大部分意外的 Fable 支出,因为昂贵的模型此后只会在你有意选择时才运行。
第二招:把搜索和读取助手固定到 Haiku 5.5
Claude Code 中最不显眼的成本来自子智能体,也就是在主对话之外搜索文件、阅读代码库的后台助手。内置的 Explore 子智能体在一次会话中可能运行几十次。根据 Anthropic 的文档,Explore 默认继承会话的父模型,上限为 Opus 5.5,而不是默认使用 Haiku。因此在 Fable 5.2 会话中,每一次自动检索都按 Opus 的价格计费,单次文件搜索约 $0.15。
自定义子智能体的情况更糟。它们没有 Opus 上限,所以未经配置的助手会直接继承 Fable 5.2,为简单的文本读取按输入 $8、输出 $40 计费。
修复只需改一行。在 Claude Code 的 agents 文件夹中定义一个 Explore 子智能体,把模型属性设为 Haiku,对所有负责搜索、读取或总结的自定义助手也做同样处理:
- 在 Claude Code 的 agents 目录中打开或新建 Explore 智能体定义。
- 在该智能体的配置中加入
model: haiku。 - 对每一个自定义的读取、搜索或总结助手重复以上操作。
在一次测试中,让 Claude Code 查找哪个文件定义了价格表,由 Opus 支撑的 Explore 智能体花费约 $0.15。固定到 Haiku 5.5 之后,同一查询从同一文件返回了同样的代码行,花费不到一美分,降幅约为 50 倍。这条规则背后的道理是:搜索和总结任务中的错误很容易发现,也不需要深度推理,所以最便宜的模型就是最合适的。Anthropic 在内部也应用了同样的逻辑,把后台子智能体每 30 秒一次的状态更新改为由 Haiku 5.5 生成的简短说明,使这些更新的成本下降了 99%。
▲ 常规搜索交给 Haiku 5.5 处理
第三招:把推理强度保持在中等,并留意谁在继承它
推理强度决定模型在回答前思考多久。共有五个档位:低、中、高、超高和最大。Claude 应用和 Claude Code 的默认值是中等。Anthropic 的指南建议,先在当前模型上调整推理强度,再考虑升级到更贵的档次。
成本曲线很陡。在 Anthropic 的 Frontier Coding Benchmark 上,Fable 5.2 的表现如下:
| 推理强度 | 得分 | 每任务成本 |
|---|---|---|
| 中等 | 37.6% | $2.48 |
| 高 | 45.3% | $6.72 |
从中等升到高,成本接近三倍,换来约八个百分点的准确率。高以上每再升一级,花费可能相当于直接切换到整整一个更大的模型档次。一位软件工程师在 Fable 5.2 上用同一个提示词做的测试展示了这种攀升:
| 推理强度 | 成本 | 耗时 |
|---|---|---|
| 高 | $24.31 | 1 小时 05 分 |
| 超高 | $43.79 | 3 小时 09 分 |
| 最大 | $87.99 | 3 小时 28 分 |
| Ultra | $642.42 | 10 小时 21 分 |
Cherny 曾表示,配额迅速耗尽通常可以追溯到一两次超高推理强度的会话、智能体团队,或者长时间运行的 SDK 作业。隐藏的放大器是继承:子智能体会沿用父会话的推理强度,所以一个高强度的会话会迫使每一个后台搜索和读取助手也以高强度推理。两个习惯有帮助:开始任何大任务之前先检查推理强度设置,因为上一次会话留下的设置可能悄悄延续;以及在 Claude Code 中运行 /usage 命令,查看 token 在各会话和子智能体之间的去向。
Fable 5.2 在哪里配得上它的溢价
把 Opus 5.5 设为默认、把助手固定到 Haiku、把推理强度保持在中等之后,主要的浪费就消除了。剩下的问题是,在哪些地方为 Fable 5.2 付出双倍价格能换回更多价值。Anthropic 建议把相同的待办任务分别在 Opus 和 Fable 上运行,再比较 /usage 中的数字。
有一次这样的对比用了一份客户入职文档,其中预先埋入七处刻意设置的缺陷,并给两个模型相同的提示词。Opus 5.5 以约 $0.20 找出了全部七处。Fable 5.2 同样找出了这七处,还另外发现了八个 Opus 遗漏的结构性问题,比如缺少在合作关系结束时撤销客户访问权限的流程。Opus 发现了两个 Fable 没有发现的问题,这样 Fable 以约 $0.35 的成本净多出六项发现,溢价约为 $0.15。
实际结论是一种分工:用 Opus 5.5 起草并执行 90%到95%的工作,用 Fable 5.2 负责最后的 5%到10%,也就是那一轮需要更深判断力、因而值得这个价格的审查。
10-80-10 分工及其何时适得其反
一个自然的延伸是经典的 10-80-10 委派模式:顶级模型规划任务(前 10%),Haiku 5.5 和 Sonnet 5.5 等更便宜的执行者完成主体部分(中间 80%),顶级模型再检查结果(最后 10%)。Anthropic 的提示词工程指南推荐了类似的设计,由 Fable 5.2 担任规划者和编排者,Haiku 或 Sonnet 负责读日志、搜文件和做总结。这不需要自定义框架;可以直接让 Claude Code 规划任务并自行启动子智能体,例如并行运行三个助手,分别校对脚本、生成开头钩子的多个版本和起草说明文字。
陷阱在于把它用在小任务上。一次测试审计了一个视频频道的指标,把前十名视频与约 16,000 次观看的中位数做比较以规划后续选题,三种配置得到的账单差别很大:
| 配置 | 成本 | 耗时 |
|---|---|---|
| 仅 Fable 5.2 | $0.58 | 约 1 分钟 |
| 仅 Opus 5.5 | $0.51 | 约 1.5 分钟 |
| Fable 5.2 编排 Haiku 和 Sonnet 子智能体 | $2.50 | — |
编排运行的成本接近单独使用 Fable 的五倍。这一结果起初看起来像个 bug,实际上是协调开销。可以想象雇一位项目经理来做一个三明治:经理要规划、写任务说明、等待、检查、给反馈,所有这些加起来比一位熟练工人直接动手做更贵。换成 AI 的语境,编排者要花昂贵的 token 撰写详细的任务说明并阅读完整报告,而每个子智能体又要从头重新读取上下文文件。Anthropic 的文档直接说了同样的话:对于能放进单个上下文窗口的任务,多智能体编排通常比它省下的更贵。
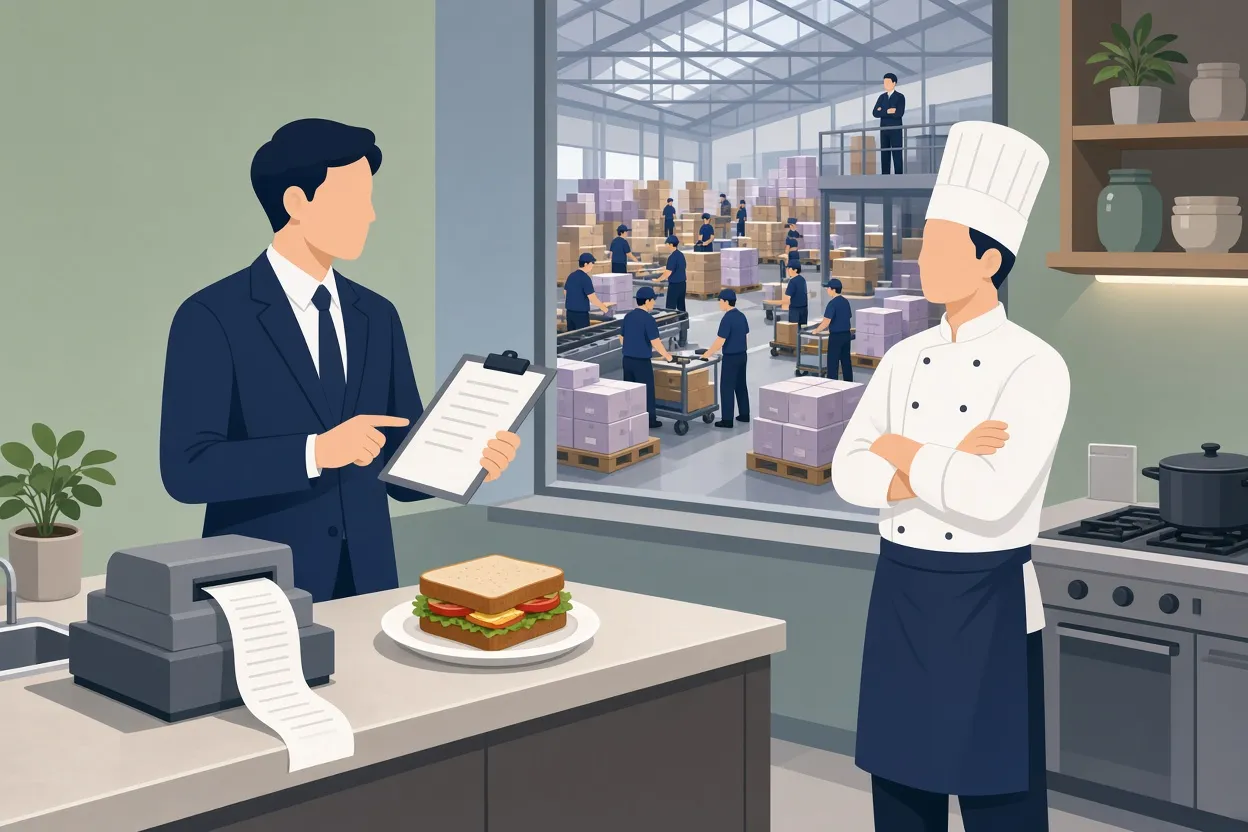
▲ 小任务上的编排开销
分界线在于中间那 80% 的规模。无论任务大小,Fable 做规划和审查的成本大致相同,所以只有当主体工作足够大、能摊薄这笔固定开销时,委派才划算。分析 50 份完整视频文字稿符合条件:阅读占据了大部分 token,而 Haiku 每百万 token 的读取价格是 $0.10,Fable 是 $8。起草一封邮件、修一个 bug,或者分析五到十个视频的指标则不符合,因为管理 token 会占据账单的大头。对计费文件做三行修改,在单个 Fable 会话里更快也更便宜。Anthropic 用一个覆盖 2200万 token 源代码的缺陷搜索基准演示了大工作量的情形:由 Opus 5.5 指挥 Sonnet 5.5 执行者,以比单独使用 Opus 少三分之一的成本完成,准确率相当。Anthropic 还发现,把子智能体的价格告诉 Fable,并指示它权衡委派是否值得,可以把不必要的子智能体启动减少大约一半。
像给新员工交接一样给便宜模型写任务说明
Fable 5.2 能从简短的指令中推断意图,这也是为什么对顶级模型来说,精细的提示词工程看起来基本没有必要。Sonnet 5.5 和 Haiku 5.5 则不同:上下文不足时它们会猜,而猜测会拉低输出质量。像"研究竞争对手的视频并总结"这样含糊的请求,会让便宜模型自行假设该看哪些频道、哪些日期,以及什么才算好。
一个有用的模式是,在把工作交给便宜模型之前先让 Fable 写好任务说明,包含五个要素:
- 目标:总体目的
- 最终结果:确切的交付物
- 规则:严格的操作约束
- 禁止事项:不要做什么
- 卡住时:兜底行为
即便有了扎实的任务说明,低价模型偶尔还是会出错,这正是最终由 Fable 审查仍然是工作流一部分的原因。
每逢新模型发布,审计提示词和技能
Anthropic 开发者关系负责人 Alex Albert 分享了每次新模型发布时的一个习惯:在所有项目仓库中运行同一个提示词,让模型找出失效、不一致或过时的代码和配置规则,对有把握的部分直接修复,其余列出来供人工审查。同样的做法可以推广到整个 AI 工作区。Claude 中的技能是 Markdown 格式的指令文件,一个过时或粗糙的技能会拖累所有执行它的模型。让 Fable 5.2 用严格的约束重写一个技能,比如把一个撰写开头钩子的技能限制在 12 个词以内,就能在 Haiku 和 Sonnet 每次运行它时改善输出。由于这是一次性的工作而非持续的编排,它可能是前沿模型杠杆率最高的用途之一。
综合起来
上述规则可以归结为三项 Claude Code 配置改动:
- 一个专门的 Explore 智能体定义,设为 Haiku 5.5,让文件查找不再跑在 Opus 上。
- 在 CLAUDE.md 中加入委派护栏,要求 Claude 在拆分工作前先判断任务规模,把助手限制在更便宜的档次,并写入子智能体的价格,让编排者知道启动一个子智能体要花多少钱。
- 一个按需调用的审查智能体,设为 Fable 5.2,只在明确召唤时运行,例如审查一份完成的脚本或一次代码改动。
想今天就动手的读者可以这样做:把中等强度的 Opus 5.5 设为默认,把每一个读取、搜索和总结助手固定到 Haiku 5.5,每次重要会话前确认推理强度,并定期检查 /usage。小任务放在同一个模型会话里完成。把 Fable 5.2 留给规划、最后 5%到10%的审查、超出单个上下文窗口的大工作量,以及每当新模型发布时对提示词、技能和配置文件的一次性审计。


