一位开发者把一个开源浏览器游戏分支(fork)的整个发布流程交给了自主AI智能体,然后用手机监督结果。两个编排智能体——一个运行在云端,一个运行在Windows笔记本上——分摊工作,就拉取请求和验证结果互发消息,并自行合并已批准的改动。这次会话的账单约为云端算力$2.39、模型token约$25-27,在每月$200的Claude Ultra套餐上只占周额度的3%。更值得关注的是,在放手之前,人类仍然必须做出哪些决定。
项目与配置
目标是Kong Royale,一款围绕香蕉设计的50人在线浏览器大逃杀游戏。开发者在GitHub上fork了维护者的公开仓库,以便在公开发布活动之前让改动落地,预告站点显示的发布目标是11月6日。由于该分支需要与活跃的上游项目保持同步,发布流程不只是构建和交付:还意味着要关注维护者的提交、进行变基(rebase)并解决合并冲突。
编排在Capy AI上运行,这是一个在多个开发环境中协调AI软件工程智能体集群的平台。它的核心概念是Captain——一个高层级智能体,负责把工作拆成任务,交给在独立线程中运行的专门智能体小组。开发者平时使用Cursor和Factory等工具,但这次选择Capy AI,是因为项目需要大量云端资源以及跨多台机器的自动化。
硬件配置刻意做得多样:
| 设备 | 角色 |
|---|---|
| iPhone | 指挥与监控 |
| MacBook Pro | 本地环境、Metal图形检查、试玩测试 |
| 配备RTX GPU的Windows笔记本 | Direct3D 11兼容性与资源验证 |
| Capy云端机器 | 构建、分类、验证、发布流程 |
Captain按硬件能力划分工作,把平台专属构建、图形验证和websocket测试发给能运行它们的机器。
准备环境
在fork并把仓库克隆到Capy AI的云端工作区后,两项配置任务并行运行:一项配置MacBook Pro上的本地环境,另一项准备云端环境。Capy分配了一台大型云端实例,运行项目初始化程序和npm安装,执行构建验证脚本,并在约11秒内完成激活快照。
配置过程中有一个细节值得注意。Capy AI自动把这些常规任务分配给了Claude Sonnet 5.5子智能体,而不是更昂贵的Claude Opus 5.5。这一模式贯穿整场会话:Opus 5.5负责编排和判断,Sonnet 5.5负责克隆、安装和基础验证等确定性执行。这种分工是套餐额度几乎没有变动的主要原因。
人类仍需亲自制定的规则
把流程交给智能体,并不意味着不再需要策略。开发者创建了一个持久的云端托管Captain,名为“Kong Cloud [Release]”,基于Claude Opus 5.5、推理强度设为中等,并让它负责四个阶段:功能开发、缺陷分类与按优先级修复、发布流程、云端验证检查。配置中包含几条明确规则。
保持拉取请求小而可验证
由于该分支要把改动回馈到活跃的上游项目,Captain被要求提交小而自包含、维护者能快速验证的拉取请求。理由很简单:庞大的整体式拉取请求往往被搁置不审,而小的拉取请求更可能被及时审核与合并。这是对开源协作方式的一种判断,除非写进指令,智能体未必能自行推断出来。
▲ 审核关口前的小型拉取请求
监控上游并自动变基
发布Captain被指示监控上游仓库,发现维护者的新提交或拉取请求时,对分支的改动进行变基并解决合并冲突。这成了一项定时的“上游监控”任务,每8到23小时轮询一次上游,有变化时触发变基流程。
决定哪些改动可以无人合并
开发者允许智能体以自动驾驶模式运行,对非关键改动的已验证拉取请求无需人工签字即可合并。关键与非关键的界线划在哪里,是人类的决定,也是最直接决定这条流水线能有多“免手动”的规则。
决定Captain驻留在哪里
把发布Captain托管在云端而非笔记本上,本身就是一个有意的选择。云端Captain在笔记本合盖或本地机器断网时仍能让流水线持续运行,对于一个本应全天候运转的流程来说,这一点很重要。
选择模型路由的细化程度
工作区还包含一个配置文件pstack-models.md,把功能重构、缺陷修复、性能优化、判断以及“发散式综合者”等开发角色映射到不同模型,包括Claude Opus 5.5、Claude Sonnet 5.5、Grok 4.7和Kimi K3.1 Pro。开发者坦率地质疑,鉴于Sonnet 5.5和Opus 5.5已经如此强大,这么细的矩阵是否有必要。结论似乎是:“Opus负责判断、Sonnet负责执行”的简单分工已经完成了大部分有用的工作。
两个互相对话的Captain
第二个Captain“Kong RTX”直接运行在Windows笔记本上自己的工作树中,专注于平台专属任务、Direct3D 11兼容性和资源验证。连接两者只需在给Kong RTX的指令中提及“@Kong Cloud [Release]”。从那一刻起,两个智能体开始自行交换消息。
它们的对话涉及项目依赖、验证脚本和一个标记为PR #1的拉取请求。云端Captain为三种运行环境生成了验证技能:macOS上的Metal、Windows上的D3D11,以及云端的无头Linux(含CPU和GPU检查)。其中一项测试在没有独立GPU的Windows上启动游戏客户端,确认回退路径稳定;在Mac上的试玩则验证了游戏以每秒65帧运行。
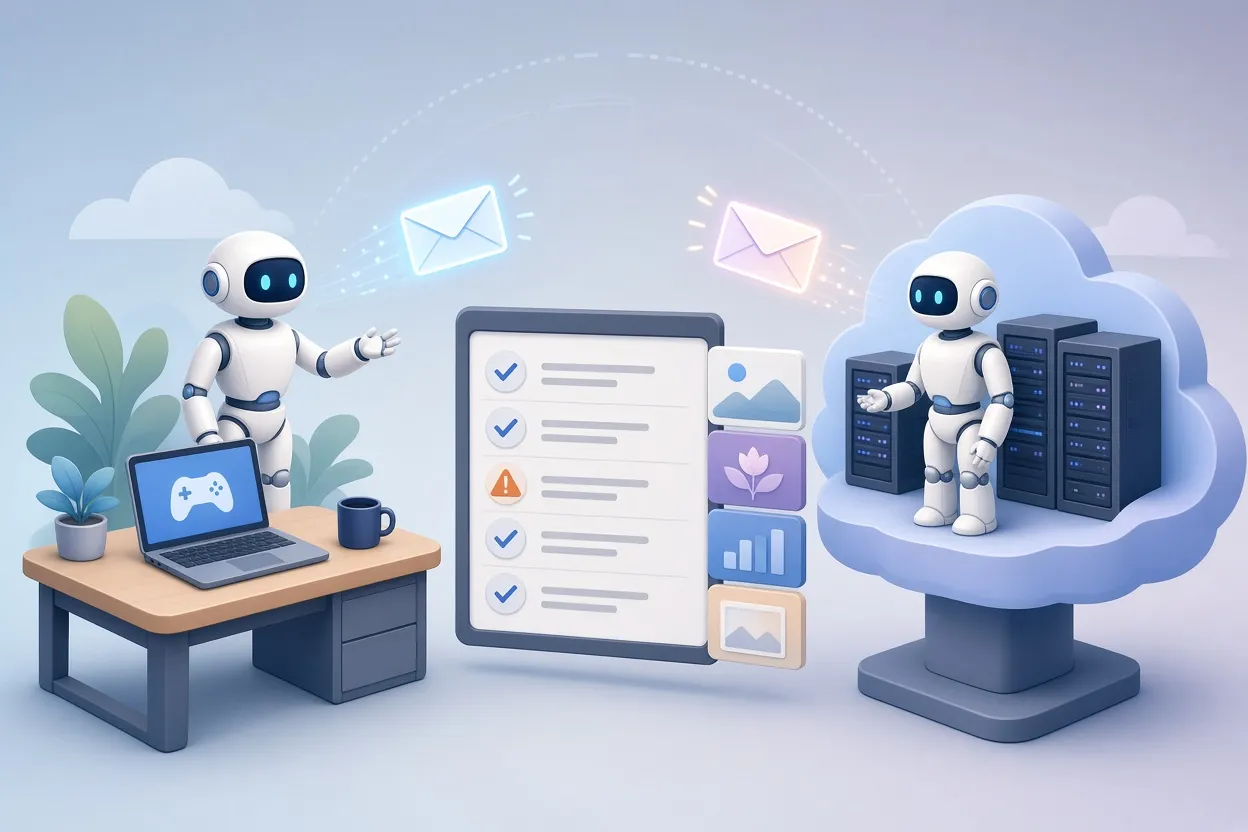
▲ 云端与Windows Captain协同工作
最能说明问题的时刻来自一个资源许可检查线程,编号KONG-13。它发现3,575个公开图片文件中有3,494个没有记录来源。云端智能体没有继续推进,而是暂停了面向上游的公开拉取请求,直到许可问题得到澄清。这正是发布流程所依赖的那种判断,也说明了为什么交给Captain的范围和规则很重要:智能体之所以暂停,似乎是因为向上游交付干净、可验证的改动本就是它任务的一部分。
实际花了多少钱
Capy AI的计费视图把自家机器的费用和用户自己API密钥产生的模型费用分开显示。在七个同时运行的智能体线程和两个Captain上,这一次会话的数字如下:
| 项目 | 费用 |
|---|---|
| Capy云端机器算力 | $2.17-2.39 |
| 用户密钥上的模型token(合计) | $23.71-27.13 |
| 其中Claude Opus 5.5 | $17.99-19.30 |
| 其中Claude Sonnet 5.5 | $5.76-5.93 |
开发者使用的是每月$200的Claude Ultra订阅。账户用量页面显示,包括仓库配置、分类、多机验证和智能体间协调在内的整场会话,只占所有模型周额度的3%,额度在周二早上6:00重置。
算力费用之所以很低,部分是因为Capy的云端机器闲置时自动挂起,并能在几秒内重新启动,所以在漫长的调试过程中没人需要记得关机。开发者对算力和套餐额度的消耗相对于生成和审核的代码量如此之少表示惊讶。这些是单个项目单次会话的数字,不是基准测试,Opus与Sonnet用量的比例会随任务组合不同而变化。
一个注意事项:让多台机器同步并正确配置,通常是此类搭建中最耗时的阶段。11秒的云端快照很快,但围绕它的本地工作树、图形环境和权限的接线工作,仍然需要人工投入。
可以借鉴什么
这次会话表明,像软件发布这样重复但判断密集的流程可以整体交给智能体,前提是人类把智能体应遵循的策略写下来。对于考虑搭建类似环境的人,实际经验如下:
- 把负责编排的Captain托管在云端,这样流水线不会因为笔记本合盖或断网而中断。
- 让Claude Sonnet 5.5等较轻的模型处理配置、克隆和常规验证,把Claude Opus 5.5留给编排和判断。
- 将Captain的推理强度设为中等,作为质量与token消耗之间的起步平衡。
- 面向活跃的上游分支工作时,要求提交小而自包含、易于验证的拉取请求。
- 安排定时的上游监控,让变基自动进行,而不是堆积起来。
- 明确决定哪些改动可以自动合并,哪些需要人来把关。
- 在指令中互相提及对方的句柄,把不同机器上的智能体连接起来,让它们自行同步分支和验证结果。
- 依靠机器自动挂起,把云端算力费用控制在几美元以内。
这里的成本数字来自一位开发者的项目和套餐,应当作参考点而非预期。可以带走的是方法:写下规则,决定每类判断放在哪里,然后让智能体向你的手机汇报。


