오픈소스 브라우저 게임 Kong Royale의 fork(원본 저장소를 복제해 따로 작업하는 사본)를 대상으로, 코드 수정부터 버그 분류, 다중 환경 검증, upstream(원본 저장소) PR(pull request, 코드 반영 요청)까지 release 과정 전체를 AI agent에게 맡긴 사례가 있습니다. 도구는 Capy AI이고, 일을 지휘한 주체는 captain이라고 부르는 상위 agent 둘입니다. 하나는 클라우드에, 하나는 Windows 노트북에 두고 서로 메시지를 주고받게 했으며, 사람은 iPhone으로 진행 상황을 지켜보는 역할만 맡았습니다. 결과는 Capy 클라우드 머신 요금 약 $2.39, 모델 사용 비용 약 $24~27, 그리고 월 $200인 Claude Ultra 플랜의 주간 한도 3% 소진이었습니다.
기기 세 대와 captain 구조
Capy AI는 여러 AI 소프트웨어 엔지니어링 agent를 여러 개발 환경에 걸쳐 조율하는 orchestration(여러 agent의 작업 배분과 조정) 플랫폼입니다. 핵심 개념은 captain으로, 큰 목표를 받아 세부 작업을 쪼개 전문화된 agent thread에 넘기는 상위 조정자입니다. Cursor나 Factory 같은 도구와 비교하면, 클라우드 자원이 많이 필요하고 여러 기기를 오가는 자동화가 필요한 프로젝트에 더 맞는 선택으로 보입니다.
이번 작업에 쓰인 구성은 다음과 같습니다.
- iPhone: 사람이 지시를 내리고 결과를 확인하는 조종 장치
- MacBook Pro: macOS 환경의 로컬 작업과 플레이 테스트
- Windows RTX 노트북: Windows 전용 빌드와 그래픽 호환성 검증
- Capy 클라우드 머신: 상시 가동되는 release captain과 병렬 검증 thread
captain은 작업을 기기 성격에 맞게 나눕니다. 플랫폼별 빌드, 그래픽 검증, websocket 테스트가 각기 다른 머신에 배정되는 식입니다.
시작은 GitHub에서 Kong Royale 저장소를 fork해 Capy AI의 클라우드 workspace로 clone하는 것이었습니다. 이때 설정 작업 두 개가 동시에 돌았습니다. 하나는 MacBook Pro의 로컬 환경, 다른 하나는 클라우드 환경입니다. 클라우드 쪽은 Large 크기 머신을 띄우고 초기화 스크립트와 npm install, 빌드 검증 스크립트를 실행한 뒤 활성화 snapshot을 찍기까지 약 11초가 걸렸습니다. 눈여겨볼 점은 이런 반복적인 설정 작업을 Capy AI가 알아서 Claude Sonnet 5.5 sub-agent에 배정했다는 것입니다. 더 비싼 Claude Opus 5.5를 쓰지 않아 플랜 한도를 아낄 수 있습니다.
release captain에게 준 규칙
클라우드에 만든 captain의 이름은 'Kong Cloud [Release]'입니다. 모델은 Claude Opus 5.5, reasoning effort(추론에 쓰는 노력 수준)는 medium으로 두었습니다. captain을 로컬 노트북이 아니라 클라우드에 두는 이유는 분명합니다. 노트북 덮개를 닫거나 네트워크가 끊겨도 pipeline이 멈추지 않기 때문입니다.
captain은 초기화되자마자 자신이 할 수 있는 일을 소개했습니다. Kong Royale의 새 checkout을 담은 클라우드 thread를 필요할 때마다 띄울 수 있다는 내용입니다. 사람이 captain에게 넘긴 책임 범위는 네 단계입니다.
| 단계 | 내용 |
|---|---|
| Features | 기능 작업 |
| Bug fixes | 버그 triage(분류와 우선순위 결정)와 우선순위 높은 버그 수정 |
| Release | release 흐름 관리 |
| Verify | 클라우드 verifier를 통한 검증 |
여기에 사람이 직접 정한 규칙이 하나 더 있습니다. 이 fork는 공개 release 행사 전에 변경 사항을 원본에 반영하는 것이 목적이므로, upstream으로 보내는 PR은 작고 검증 가능한 단위로 쪼개라는 것입니다. 큰 PR 하나를 던지면 maintainer가 검토하기 어렵고 merge도 늦어지는 반면, 작은 PR은 빨리 검토되고 받아들여질 가능성이 높다는 판단입니다. 또한 captain은 upstream 저장소를 감시하다가 원작 maintainer의 commit이나 PR이 올라오면 rebase(내 변경을 최신 원본 위로 다시 올리는 작업)하고 충돌을 해결하도록 설정되었습니다. 이 'Upstream watch'는 8~23시간 간격으로 원본을 확인하는 예약 작업으로 자동화되었습니다.
▲ 작고 검증 가능한 PR 규칙
비용과 플랜 사용량
Capy AI의 비용 화면은 지출을 두 갈래로 나눕니다. Capy가 직접 청구하는 머신 요금과, 사용자가 연결한 본인 키로 나가는 모델 비용입니다. captain 둘과 agent thread 7개가 동시에 돌아간 뒤의 수치는 다음과 같습니다. 작업이 진행되는 동안 숫자가 조금씩 올라갔기 때문에 범위로 적습니다.
| 항목 | 금액 |
|---|---|
| Capy 머신 요금 | $2.17~2.39 |
| 모델 token 비용(본인 키) | $23.71~27.13 |
| 그중 Claude Opus 5.5 | $17.99~19.30 |
| 그중 Claude Sonnet 5.5 | $5.76~5.93 |
구독은 월 $200인 Anthropic의 Claude Ultra 플랜이었습니다. Claude 계정의 사용량 설정 화면에서 확인한 결과, 저장소 설정과 triage, 여러 머신에 걸친 검증을 모두 포함한 이 작업이 주간 한도의 3%만 썼습니다. 생성하고 감사한 코드 양에 비하면 머신 요금도, 모델 한도 소진도 예상보다 훨씬 적은 수준으로 보입니다.
머신 요금이 낮게 유지된 데는 Capy 클라우드 머신이 유휴 상태가 되면 자동으로 멈추고, 다시 필요할 때 몇 초 안에 켜지는 구조가 한몫했습니다. 사람이 직접 꺼 주지 않아도 불필요한 컴퓨팅 요금이 쌓이지 않습니다.
모델 배분에 관해서는 참고할 만한 설정 파일도 있었습니다. 기능 refactoring, 버그 수정, 성능, 판단, 서로 다른 관점을 합치는 synthesizer 같은 역할마다 Claude Opus 5.5, Claude Sonnet 5.5, Grok 4.7, Kimi K3.1 Pro를 나눠 배정하는 표입니다. 다만 Sonnet 5.5와 Opus 5.5의 기본 성능이 충분히 높은 지금, 이렇게 복잡한 역할별 모델 배정이 꼭 필요한지는 의문으로 보입니다.
두 captain이 서로 대화하며 일하는 방식
두 번째 captain인 'Kong RTX'는 Windows RTX 노트북에서 직접 돌아갑니다. 별도의 worktree(같은 저장소의 다른 작업 디렉터리)에서 Windows 전용 작업, Direct3D 11 호환성, asset 검증을 맡습니다.
두 captain을 연결하는 방법은 단순합니다. Kong RTX에 주는 지시문 안에 '@Kong Cloud [Release]'를 언급하면 둘 사이에 메시지 채널이 열립니다. 여기에 더해 중요하지 않은 변경은 사람의 승인 없이 검증된 PR을 agent가 직접 merge해도 된다는 autopilot 권한도 주었습니다.
그 뒤 두 captain은 사람이 개입하지 않는 상태에서 대화를 시작했습니다. 프로젝트 의존성, 출처가 기록되지 않은 asset license, 검증 스크립트에 관한 발견을 서로 주고받았고, PR #1을 두고 교차 플랫폼 검증 통과를 확인했습니다. 특히 asset license 점검 thread는 공개 이미지 파일 3,575개 중 3,494개에 출처 기록이 없다는 사실을 찾아냈고, 클라우드 captain은 이 문제가 정리될 때까지 공개 upstream PR을 보류하는 판단을 내렸습니다.
검증 체계도 captain이 스스로 만들었습니다. Kong Cloud는 macOS의 Metal, Windows의 DirectX(D3D11), 화면 없는 클라우드 Linux라는 세 가지 실행 환경을 각각 다루는 verification skill을 생성했습니다. 전용 GPU가 없는 Windows 환경에서 게임 client가 정상 부팅되는지 확인하는 기본 fallback 안정성 테스트도 포함되었고, 로컬 Mac에서의 플레이 테스트에서는 65 fps가 확인되었습니다.
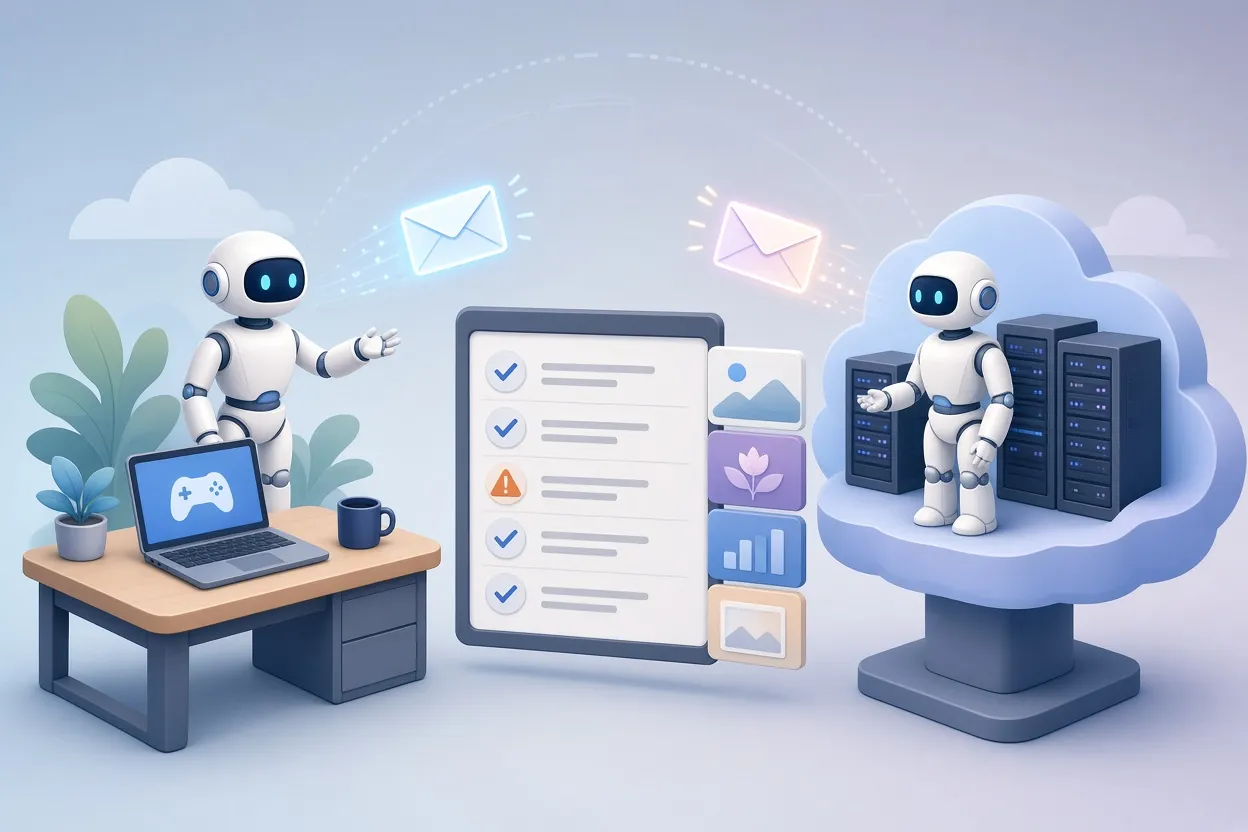
▲ 두 captain의 agent 간 협업
사람이 정해야 할 것과 독자가 할 일
이 사례가 보여 주는 핵심은 agent가 release를 '할 수 있다'는 것보다, 사람이 어떤 규칙을 미리 정해 두었는가에 있다고 봅니다. PR은 작게 쪼개라, 중요하지 않은 변경만 자동 merge하라, upstream은 주기적으로 감시하고 rebase하라 같은 규칙이 있었기 때문에 agent 둘이 서로 대화하며 일해도 결과가 통제 범위 안에 머물렀고, 출처가 불분명한 asset이 발견되자 captain이 공개 upstream PR을 보류하는 판단까지 스스로 내릴 수 있었습니다. 비용 면에서는 captain 둘과 thread 7개를 돌려도 머신 요금 약 $2.39, Claude Ultra 주간 한도 3%였다는 점이 이 사례의 수치입니다. 프로젝트 규모와 작업 양에 따라 달라질 수 있으므로 하나의 참고치로 보는 것이 맞습니다.
비슷한 구성을 시도하려는 독자는 다음 순서를 참고할 수 있습니다.
- release captain은 로컬 노트북이 아니라 클라우드에 두어 노트북이 꺼져도 흐름이 이어지게 합니다.
- 저장소 clone, 환경 설정, 기본 단위 검증 같은 반복 작업은 Claude Sonnet 5.5 같은 가벼운 모델에 맡기고, 상위 captain만 Claude Opus 5.5를 쓰게 합니다.
- captain의 reasoning effort는 medium으로 시작해 결과 품질과 token 효율의 균형을 봅니다.
- 활발히 움직이는 upstream fork에 기여한다면 PR을 작고 독립적이며 검증 가능한 단위로 유지하라는 규칙을 명시합니다.
- 다른 기기의 captain과 협업시키려면 지시문에 '@'로 상대 captain을 언급해 메시지 채널을 열고, 자동 merge를 허용할 범위를 분명히 정해 둡니다.
- 작업 중 Capy의 비용 화면과 Claude 계정의 사용량 화면을 함께 확인해 머신 요금과 모델 한도를 따로 추적합니다.
한 가지 덧붙이면, 이런 multi-agent 구성에서 가장 시간이 많이 드는 단계는 agent의 작업 자체가 아니라 여러 머신을 동기화하고 올바르게 설정하는 초기 단계로 보입니다. 첫 시도에서는 기기 수를 줄여 시작하고, 설정이 안정된 뒤 captain을 추가하는 편이 수월할 수 있습니다.


