一家建筑软件公司构建的一组建筑业专用基准测试,给出了与主导AI发布公告的编程和通用知识排行榜截然不同的结果。在真实图纸集、工程量计算和一份刻意制造混乱的仓库投标文件上进行测试后,Anthropic的Claude模型在图纸阅读和施工管理判断两项上名列前茅,OpenAI的GPT-6系列紧随其后,而谷歌的Gemini 4 Argon在管理任务上明显落后。这些测试还揭示了两项比任何单一排名都更重要的发现:包裹模型的软件壳层可以让其准确率相差30个百分点以上;而目前还没有任何模型能够足够可靠地测量工程量,以独立为投标定价。
通用基准为何不适用于建筑业
基准测试是一种标准化测试,在固定任务集上为AI模型打分并排名。最常被引用的公开基准衡量的是通用知识工作、编程智能体或软件工程。MMMU-Pro等视觉推理测试和Harvey等法律推理测试可以部分替代图纸阅读和合同管理的评估,但在这套测试出现之前,没有任何基准直接衡量建筑业工作流程。
这一空白之所以重要,是因为Gemini 4 Argon、Claude Opus 5.5或GPT-6等新版本的厂商发布图表,往往只挑选能让新模型占据榜首的基准。这里介绍的建筑业测试正是为了绕开这个问题而设计,它按照工地办公室的实际工作给模型打分:根据图纸回答问题、清点和测量工程量、从项目记录中检索事实,以及编制估算、进度计划、进度报告、采购比较、合同管理和成本报告。
该测试套件分为两类:
- 客观测试只有一个正确答案,例如某个房间里有多少个UPS插座,按对错计分。
- 主观测试要求提交完整的交付成果,例如一份投标估算,并按书面评分标准打分,涵盖范围覆盖、工作分解、定价逻辑,以及对包含项和排除项的说明是否清晰。
主观测试还暗藏陷阱。一份招标文件中有一句话说明工地附近没有停车位。仔细阅读的模型应当在估算中加入交通津贴或额外的通勤时间。
壳层改变结果
建筑行业的从业者很少直接调用模型的原始API。他们使用的是ChatGPT Work、Claude Code、Claude Cowork或连接了Google Drive的Gemini等应用。这些应用被称为壳层(harness),它们在模型外层加上指令、项目上下文、文件管理工具和推理脚手架。因此,该基准分别测试了37个原始模型和22个壳层与模型的组合。
▲ 软件壳层相对裸API的准确率提升
两者之间差距很大。在图纸问答测试中,原始API的最好成绩来自OpenAI的GPT-6 Astra,准确率82.1%,列出的单次运行成本为$24.11。而在Claude Cowork中,Claude Sonnet 5.5达到93.3%,比其原始基线高出32.8个百分点。GPT-5.6 Sol在ChatGPT Work中提高了11.2个百分点。现实的启示是,对于不写代码的用户而言,原始API的得分几乎说明不了他们桌面上的应用能给出什么样的结果。
图纸问答:Claude模型集中在榜首
图纸基准包含169道问题,覆盖结构、电气、土木和机械专业的九套真实图纸。一道典型的问题是:402号图纸上的配电箱DB-GB在单线图中标注的是重要负荷还是非重要负荷。Claude Sonnet 5.5正确读出母线标签为非重要负荷;GPT-5.6 Sol则把它与上方更大范围的系统标签混淆,以很高的置信度回答了重要负荷。
壳层内的结果:
| 模型与壳层 | 图纸问答准确率 |
|---|---|
| Claude Cowork中的Claude Sonnet 5.5 | 93.3% |
| Claude Cowork中的Claude Fable 5.1 | 92.5% |
| Claude Cowork中的Claude Opus 5.5 | 两次运行分别为92.5%和91.8% |
| GPT-6 Astra,原始API(原始模型最佳成绩) | 82.1% |
三个领先的Claude模型之间从91.8%到93.3%的差距,处于正常的运行间波动范围内,不应被解读为真实的能力差异。
工程量计算:清点可行,测量不行
工程量计算基准使用两个真实项目:一个表演艺术中心的电气分项和一家超市的给排水分项,共130条工程量条目,测试了33个模型和18个壳层。灯具、插座和管件的数量必须完全匹配;管道和电缆的测量长度与内部核实的工程量误差在5%以内即视为正确。
| 模型与壳层 | 工程量计算准确率 |
|---|---|
| Claude Cowork中的Claude Opus 5.5 | 53.1% |
| Gemini 4 Argon | 52.3% |
| Claude Cowork中的Claude Sonnet 5.5 | 49.2% |
| ChatGPT Work中的GPT-6 Astra和GPT-6.1 Sol | 46.2% |
| Claude Cowork中的Claude Fable 5.1 | 43.9% |
| Claude Code中的Claude Opus 5 | 43.1% |
模型在干净的矢量图纸上清点离散符号表现良好。在一个灵活办公室的例子中,Claude Opus 5.5找到了全部六个UPS插座,GPT-6 Astra只找到四个。它们的短板在于比例尺:管道走向、电缆敷设和复杂的尺寸几何。从Claude Opus 5的43.1%跃升到Opus 5.5的53.1%只用了几个月,说明进步很快,但53.1%远远达不到任何人可以放心据此为投标定价的水平。该测试套件的作者预计,基础模型可能在大约六个月内基本填补这一差距,并据此建议目前不要为专用的AI工程量计算软件付费。这个时间点是一项预测,而非测试结果。
记录检索已基本解决
第三项客观测试要求模型在286份杂乱的项目文件中查找事实,共146道题,涉及合同、台账、现场记录和往来函件,例如还有多少份信息请求尚未关闭,哪份台账能够证明。Gemini 3.7 Flash、GPT-5.6 Sol和Claude Opus 5均得到97.7%,Claude Sonnet 5得到97.5%,连小型的GPT-5 Nano也达到95.2%。较旧的模型和开放权重模型落后,Mistral Large 2512为87.7%,Mistral Medium 3.1为83.9%。由于最新的前沿模型如今已能达到100%,这项基准已从公开排行榜中退役。
施工管理:混乱条件下的判断力
主观基准覆盖六项工作流程:估算、进度编排、进度跟踪、采购、合同管理和成本报告。每个场景都模拟一位同事提出的请求,背后是相互矛盾的文件。数据集包含612份文件,共比较了七个模型。
▲ 仓库招标文件中预埋的错误
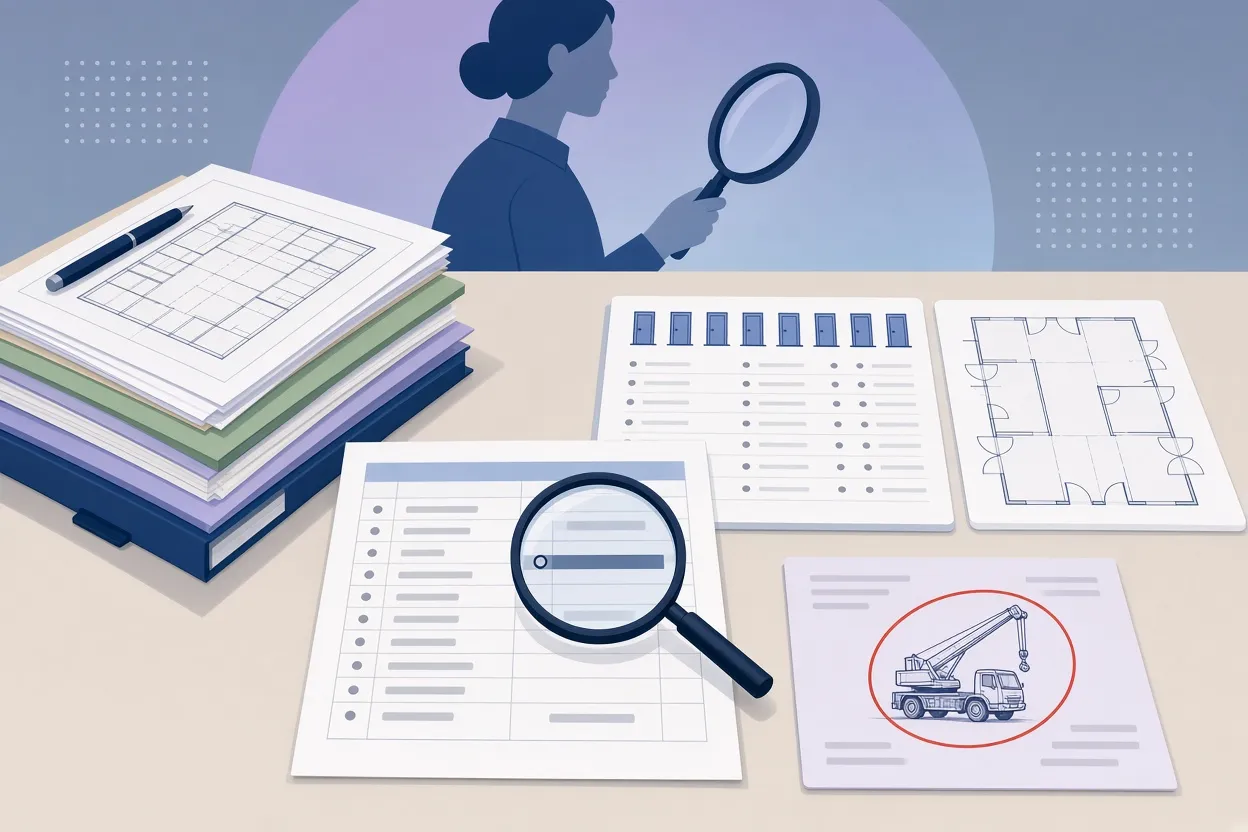
在投标任务中,模型收到的是一个带附属办公楼的仓库项目的投标包,共31个文件,包括建筑和结构图纸、工作范围、合同条件、补遗邮件、七份带排除项的供应商报价和一个内部成本库。每个模型都必须产出一份Excel估算、一份PDF投标文件和一份假设台账。预埋的错误包括:混凝土单价被误录为每立方米$39.60而非$396;一份门的报价只覆盖八樘门的供货,而规范要求十六樘门安装到位;图纸目录引用了投标包中并不存在的图纸。
评分采用三轮隐去模型名称的盲审AI评审,取中间分,最高80分,再加上20分的自动化检查。
具体任务显示出模型之间的差距所在:
- 采购:一家钢结构分包商报价为一个班组用16周完成,含吊装,但快速推进的进度计划要求10周完成。这意味着需要两个班组、额外$14万,以及修订后单价中漏掉的约$43.4万的移动式起重机单独租赁费用。Claude Opus 5.5发现了缺失的吊装费用,在比较中加入了$433,819的起重机成本,预算项得分为3.5分(满分4分)。Claude Haiku 5.5接受了压缩后的工期却未计入起重机费用,得分为1分(满分4分)。
- 估算:图纸显示13,270平方米的仓库地坪与1,793平方米的办公楼基础存在重叠。Opus 5.5识别出重叠,将地坪面积减至11,670平方米;Haiku 5.5则把共用区域重复计算了。
- 进度编排:Claude Sonnet 5.5严格依据已订购的资源,预测竣工日期为2027年11月3日,并将赶工作为未经批准的选项提出。Opus 5.5则采用了未经批准的2027年9月13日赶工日期。更大的模型并非总能胜出。
- 进度跟踪:Haiku 5.5接受了现场日志中2月23日的浇筑日期,而Sonnet 5.5核对了送货单和试验台账,确认为2月24日。
- 付款申请:Opus 5.5建议在核实后给出57%的暂定评估,而Haiku 5.5建议未经核实的70%。
总分满分100分,这是质量等级,应作相对比较,而不是正确率:
| 模型与壳层 | 得分 |
|---|---|
| Claude Cowork中的Claude Opus 5.5 | 65.9 |
| Claude Cowork中的Claude Fable 5.1 | 63.4 |
| Claude Cowork中的Claude Sonnet 5.5 | 63.2 |
| ChatGPT Work中的GPT-6.1 Sol | 60.5 |
| ChatGPT Work中的GPT-6 Astra | 56.8 |
| Gemini应用中的Gemini 4 Argon | 44.1 |
| Claude Cowork中的Claude Haiku 5.5 | 35.2 |
Claude Fable 5.1在多项管理任务上落后于Opus 5.5,与预期相反。
这意味着什么,该怎么做
行业专用测试得出的排名不同于通用排行榜的暗示,而其方法才是可迁移的部分。对建筑团队而言,实际可行的要点是:
- 在Claude和ChatGPT之间选择。Claude Opus 5.5目前在复杂文件夹上的推理最为深入,而同等订阅费用下ChatGPT提供的使用量大约是前者的两倍。Gemini和现有的开源模型在管理工作流程上似乎缺乏竞争力。
- 放心地把AI用于图纸问答和记录检索,但把每一个测量得出的工程量都当作待核对的草稿。
- 鉴于约53%的上限,暂时不要购买专用的AI工程量计算工具。
- 明确提示:要求模型检查赶工报价是否包含起重机和吊装设备,查找地坪与基础工程量中的空间重叠,优先采用已确认的分包合同而非未经批准的赶工进度,并将现场日志与送货单和试验台账交叉核对。
对其他领域的读者,同样的方法也适用。测试你将实际使用的应用,而不是原始API。用自己杂乱的文件构建任务,埋入真实的陷阱,并在相信1到2分的差距之前重跑接近的结果。由于Anthropic和OpenAI每次发布都在交替领先,选定一个生态并将其融入日常工作,很可能比追逐每一个新排行榜更有益。


