建設ソフトウェア企業が構築した建設特化のベンチマークは、AIの新モデル発表を彩るコーディングや一般知識のリーダーボードとは異なる姿を映し出しています。実際の図面セット、数量拾い、そして意図的に混乱させた倉庫の入札パッケージで試験したところ、AnthropicのClaudeモデルが図面の読み取りと建設マネジメントの判断で首位を占め、OpenAIのGPT-6ファミリーが僅差で続き、GoogleのGemini 4 Argonはマネジメント業務で大きく後れを取りました。同じ試験からは、個々の順位よりも重要な2つの知見も浮かび上がりました。モデルを包むソフトウェアの枠組み次第で精度が30ポイント以上も変動すること、そして単独で入札価格を算出できるほど信頼性の高い数量計測ができるモデルはまだ存在しないことです。
汎用ベンチマークが建設分野で不十分な理由
ベンチマークとは、固定された一連のタスクでAIモデルを採点し、順位付けする標準化された試験です。よく引用される公開ベンチマークは、一般的なナレッジワーク、コーディングエージェント、ソフトウェアエンジニアリングを測るものです。MMMU-Proのような視覚推論テストやHarveyの法的推論テストは、図面の読み取りや契約管理の部分的な代替指標にはなりますが、このスイートが登場するまで、建設ワークフローを直接測るものはありませんでした。
このギャップが重要なのは、Gemini 4 Argon、Claude Opus 5.5、GPT-6といったリリースのベンダー発表チャートが、新モデルを首位に押し上げるベンチマークばかりを並べる傾向にあるからです。ここで紹介する建設テストは、その問題を回避するため、現場事務所が実際に行う業務でモデルを採点するよう設計されています。図面に基づく質問への回答、数量の計数と計測、プロジェクト記録からの事実の検索、そして見積、工程表、進捗報告、調達比較、契約管理、コスト報告の作成です。
スイートは2種類のテストに分かれます。
- 客観テストは、ある部屋にUPSコンセントがいくつあるかといった正解が1つの問題で、正誤で採点します。
- 主観テストは、入札見積のような完成した成果物を求め、スコープの網羅性、作業分解、価格設定の論理、含む項目と除外項目の明確さを定めた採点基準に照らして評価します。
主観テストには仕掛けも隠されています。ある入札書類には、現場の近くに駐車場がないと述べる一文が含まれています。注意深く読むモデルであれば、見積に輸送費や追加の移動時間を計上するはずです。
ハーネスが結果を変える
建設の実務者がモデルの生のAPIを直接呼び出すことはめったにありません。ChatGPT Work、Claude Code、Claude Cowork、Google Driveに接続したGeminiといったアプリケーションを使います。ハーネスと呼ばれるこれらのアプリケーションは、指示、プロジェクトの文脈、ファイル管理ツール、推論の足場でモデルを包み込みます。そのためベンチマークでは、37の生モデルと22のハーネスとモデルの組み合わせを別々に試験しました。
▲ 生APIとハーネス利用時の精度差
両者の差は大きなものです。図面の質問応答テストでは、生APIの最高成績はOpenAIのGPT-6 Astraの82.1%で、公表された実行コストは$24.11でした。Claude Cowork内のClaude Sonnet 5.5は93.3%に達し、生の基準値から32.8ポイント上昇しました。GPT-5.6 SolはChatGPT Work内で11.2ポイント上昇しました。実務上の教訓は、コーディングをしないユーザーにとって、生APIのスコアは手元のアプリから得られる結果をほとんど教えてくれないということです。
図面の質問応答:Claudeモデルが上位に集中
図面ベンチマークは、構造、電気、土木、機械の各分野を網羅する9つの実際の図面セットについて169問を出題します。典型的な問題は、図面402の分電盤DB-GBが単線結線図でessential(重要系統)とnon-essential(一般系統)のどちらに分類されているかを問うものです。Claude Sonnet 5.5は母線のラベルを正しくnon-essentialと読み取りましたが、GPT-5.6 Solはその上にあるより広いシステムのラベルと混同し、高い確信度でessentialと答えました。
ハーネス内での結果は次のとおりです。
| モデルとハーネス | 図面Q&Aの正答率 |
|---|---|
| Claude Cowork内のClaude Sonnet 5.5 | 93.3% |
| Claude Cowork内のClaude Fable 5.1 | 92.5% |
| Claude Cowork内のClaude Opus 5.5 | 実行ごとに92.5%と91.8% |
| GPT-6 Astra、生API(生の最高成績) | 82.1% |
上位3つのClaudeモデルの91.8%から93.3%という幅は、通常の実行間のばらつきの範囲内であり、実際の能力差と読むべきではありません。
数量拾い:計数はできるが計測はできない
数量拾いベンチマークは、舞台芸術センターの電気工事パッケージとスーパーマーケットの配管工事パッケージという2つの実案件を使い、合計130の数量項目を33モデルと18ハーネスで試験しました。器具、コンセント、継手の個数は完全一致が必要で、配管やケーブルの延長の計測値は、社内で検証した数量の5%以内であれば正解としました。
| モデルとハーネス | 数量拾いの正答率 |
|---|---|
| Claude Cowork内のClaude Opus 5.5 | 53.1% |
| Gemini 4 Argon | 52.3% |
| Claude Cowork内のClaude Sonnet 5.5 | 49.2% |
| ChatGPT Work内のGPT-6 AstraとGPT-6.1 Sol | 46.2% |
| Claude Cowork内のClaude Fable 5.1 | 43.9% |
| Claude Code内のClaude Opus 5 | 43.1% |
モデルは、きれいなベクター図面上の個別の記号を数えることは得意です。フレキシブルオフィスの例では、Claude Opus 5.5は6つのUPSコンセントをすべて見つけましたが、GPT-6 Astraは4つしか見つけられませんでした。つまずくのはスケールを伴う作業で、配管経路、ケーブルの延長、複雑な寸法形状です。Claude Opus 5の43.1%からOpus 5.5の53.1%への上昇は数か月のうちに起きたもので、進歩の速さを示唆しますが、53.1%は誰であれ安心して入札価格を算出できる水準には程遠い数字です。スイートの作成者は、基盤モデルが6か月ほどでこのギャップをおおむね埋める可能性があると見込んでおり、その前提で、現時点では専用のAI数量拾いソフトウェアに費用を払わないよう勧めています。この時期は予測であって、結果ではありません。
記録検索は事実上解決済み
3つ目の客観テストでは、契約、台帳、現場記録、往復文書に関する146問を使い、286の雑然としたプロジェクトファイルから事実を探し出すよう求めました。たとえば、未回答の質疑書がいくつ残っているか、それをどの台帳が証明するかといった問題です。Gemini 3.7 Flash、GPT-5.6 Sol、Claude Opus 5はいずれも97.7%、Claude Sonnet 5は97.5%を記録し、小型のGPT-5 Nanoでさえ95.2%に達しました。旧世代やオープンウェイトのモデルは遅れをとり、Mistral Large 2512が87.7%、Mistral Medium 3.1が83.9%でした。最近のフロンティアモデルは100%に達するようになったため、このベンチマークは公開リーダーボードから外されています。
建設マネジメント:混乱した条件下での判断
主観ベンチマークは、見積、工程計画、進捗管理、調達、契約管理、コスト報告の6つのワークフローを対象とします。各シナリオは、矛盾する文書に裏付けられた同僚からの依頼を模しています。データセットは612の文書を含み、7つのモデルを比較しました。
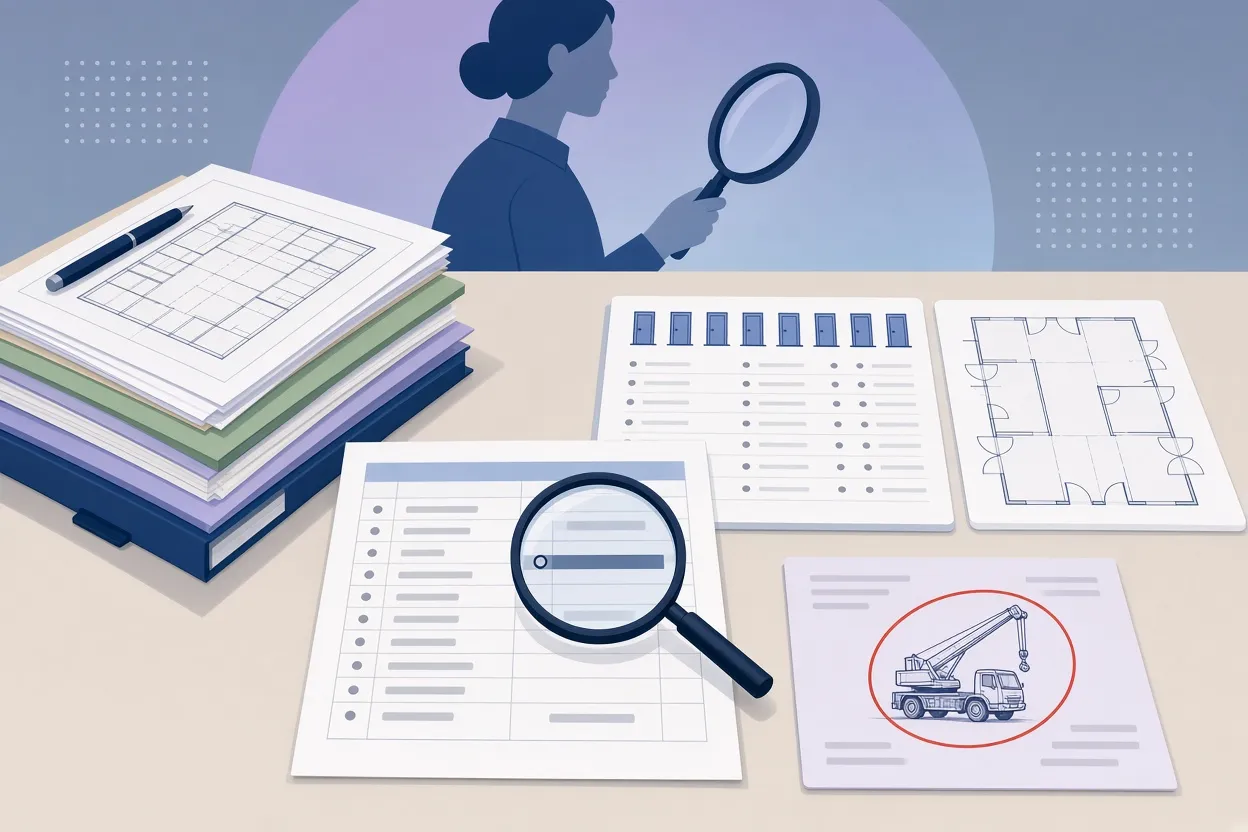
▲ 倉庫入札パッケージに仕込まれた誤り
入札タスクでは、事務所棟付きの倉庫について31ファイルの入札パッケージがモデルに渡されました。意匠図と構造図、作業範囲書、契約条件、追補のメール、除外事項付きの7社のサプライヤー見積、社内の単価ライブラリが含まれています。各モデルは、Excelの見積、PDFの入札提出書、前提条件台帳を作成しなければなりません。仕込まれた誤りには、コンクリート単価が1立方メートルあたり$396ではなく$39.60と入力されていたこと、仕様では設置込みのドア16枚が指定されているのにドアの見積は8枚の供給のみを対象としていたこと、図面台帳がパッケージに含まれていない図面を参照していたことがあります。
採点は、モデル名を伏せた3回のブラインドAIレビューセッションで行い、その中央の評価を採用して最大80点、さらに自動チェックで20点としました。
個別のタスクでは、モデル間の差がはっきり表れました。
- 調達:鉄骨下請業者は、クレーン作業込みで1班16週間の見積を出しましたが、短縮工程では10週間が必要でした。つまり2班体制で$140,000の追加となり、さらに改訂単価では省かれていた約$434,000の移動式クレーンの別途レンタルが発生します。Claude Opus 5.5はクレーン作業の欠落を見抜き、$433,819のクレーン費用を比較に加えて、予算項目で4点中3.5点を獲得しました。Claude Haiku 5.5はクレーン費用なしで短縮された日程を受け入れ、4点中1点でした。
- 見積:図面では13,270平方メートルの倉庫スラブが1,793平方メートルの事務所基礎と重なっていました。Opus 5.5はこの重複を認識してスラブを11,670平方メートルに減らしましたが、Haiku 5.5は共有部分を二重計上しました。
- 工程計画:Claude Sonnet 5.5は発注済みのリソースのみに厳密に基づいて2027年11月3日の完成日を算出し、工期短縮を未承認の選択肢として提示しました。Opus 5.5は未承認の短縮日程である2027年9月13日を採用しました。大きいモデルが常に勝つわけではありません。
- 進捗管理:Haiku 5.5は現場日報にある2月23日の打設日をそのまま受け入れましたが、Sonnet 5.5は納品伝票と試験台帳を照合し、2月24日であることを確認しました。
- 支払請求:Opus 5.5は検証を経たうえで暫定的な57%の査定を推奨しましたが、Haiku 5.5は未検証のまま70%を推奨しました。
100点満点の総合スコアは、正答率ではなく相対的に読むべき品質評価です。
| モデルとハーネス | スコア |
|---|---|
| Claude Cowork内のClaude Opus 5.5 | 65.9 |
| Claude Cowork内のClaude Fable 5.1 | 63.4 |
| Claude Cowork内のClaude Sonnet 5.5 | 63.2 |
| ChatGPT Work内のGPT-6.1 Sol | 60.5 |
| ChatGPT Work内のGPT-6 Astra | 56.8 |
| Geminiアプリ内のGemini 4 Argon | 44.1 |
| Claude Cowork内のClaude Haiku 5.5 | 35.2 |
Claude Fable 5.1がいくつかのマネジメントタスクでOpus 5.5を下回ったのは、予想に反する結果でした。
この結果が意味することと取るべき行動
業界特化テストによる順位は汎用リーダーボードが示唆するものとは異なり、他に転用できるのはその手法です。建設チームにとっての実務的なポイントは次のとおりです。
- ClaudeかChatGPTかを選ぶ。Claude Opus 5.5は現時点で複雑な文書フォルダに対する最も深い推論を示し、ChatGPTはサブスクリプション料金$1あたりおよそ2倍の利用量を提供します。Geminiと現行のオープンソースモデルは、マネジメントのワークフローでは競争力がないようです。
- 図面の質問と記録検索にはAIを安心して使い、計測された数量はすべて確認が必要な下書きとして扱う。
- およそ53%という上限を踏まえ、専用の数量拾いAIツールはまだ購入しない。
- 明示的にプロンプトを書く。工期短縮の見積にクレーンやホイストが含まれているか確認すること、スラブと基礎の数量に空間的な重複がないか探すこと、未承認の短縮工程より確定した下請契約を優先すること、現場日報を納品伝票や試験台帳と照合することをモデルに指示します。
他の分野の読者にも同じアプローチが当てはまります。生のAPIではなく、実際に使うアプリを試験してください。自分の雑然とした文書からタスクを組み立て、現実的な仕掛けを仕込み、1、2ポイントの差を信じる前に僅差の結果は再実行しましょう。AnthropicとOpenAIはリリースごとに互いを追い抜き合うため、新しいリーダーボードを追いかけ続けるより、1つのエコシステムに決めて日常業務に組み込むほうが役に立つ可能性が高いでしょう。


