OpenAI의 2026년 3분기 연환산 매출(ARR, 최근 매출을 1년치로 환산한 값)이 전 분기 대비 70% 늘어 약 $500억에 이르렀습니다. OpenAI CFO Sarah Friar가 직접 밝힌 수치입니다. 눈에 띄는 것은 성장의 모양입니다. 분기 초에 나온 5.6 버전 frontier 모델(최고 성능급 모델)과 9월 초에 나온 Astra 모델이 매출에 불을 붙였고, 그 위에서 기업 사업이 한 분기 만에 두 배로 커지면서 기업과 소비자 매출 비중이 50대 50으로 맞춰졌습니다. 새 모델이 방아쇠였다면, 분기의 체질을 바꾼 것은 기업 사업이었다고 읽을 수 있습니다.
성장의 원천은 모델인가, 기업 사업인가
Friar의 설명을 뜯어보면 두 요인은 따로 떼어 놓기 어렵습니다. 새 모델 출시가 수요를 일으켰고, 그 수요가 실제 매출로 굳어진 자리가 기업 쪽이었기 때문입니다. 기업 매출을 끌어올린 용도는 세 가지였습니다.
- 소프트웨어 개발(코딩)
- 사이버 보안
- 가상 비서 Dots의 초기 도입
중소기업용 SKU(판매 단위 상품)의 움직임도 컸습니다. 3분기 한 분기 동안 늘어난 규모가 직전 여섯 분기를 합친 것보다 컸다고 합니다. 소비자 쪽도 멈추지 않았습니다. ChatGPT를 매주 찾는 소비자는 12억 명으로 전 분기 대비 20% 늘었습니다.
정리하면, 분기 매출 70% 성장의 동력은 '새 모델이 만든 수요를 기업 제품이 받아낸 구조'로 보는 것이 가장 가깝습니다. 모델 하나의 인기라기보다 모델, 코딩, 보안, 비서가 한 묶음으로 기업에 팔리기 시작한 결과라는 해석입니다.
| 항목 | 수치 |
|---|---|
| 연환산 매출(3분기 말) | 약 $500억 |
| 연환산 매출 성장률 | 전 분기 대비 70% |
| 기업 사업 성장 | 전 분기 대비 2배 |
| 기업 대 소비자 매출 비중 | 50 대 50 |
| 중소기업 SKU 성장 | 3분기 증가분이 직전 6개 분기 합계보다 큼 |
| ChatGPT 주간 소비자 사용자 | 12억 명(전 분기 대비 20% 증가) |
| 유료 소비자 구독자 | 1억 명 돌파 |
기업 고객을 붙잡는 방식: API가 아니라 조직 안에 들어가는 제품
AI 모델은 업계 전체에서 자주 바뀌는데, 이렇게 빠르게 쌓인 기업 매출이 과연 오래 가는지가 당연히 따라붙는 질문입니다. Friar의 설명은 명확합니다. 고객이 단순히 frontier 모델 API를 호출하는 단계를 넘어, 조직의 context(업무 맥락), 자체 데이터, 지속되는 memory(이전 작업을 기억하는 기능)에 깊이 묶인 제품을 쓰기 시작하면 이탈이 크게 줄어든다는 것입니다.
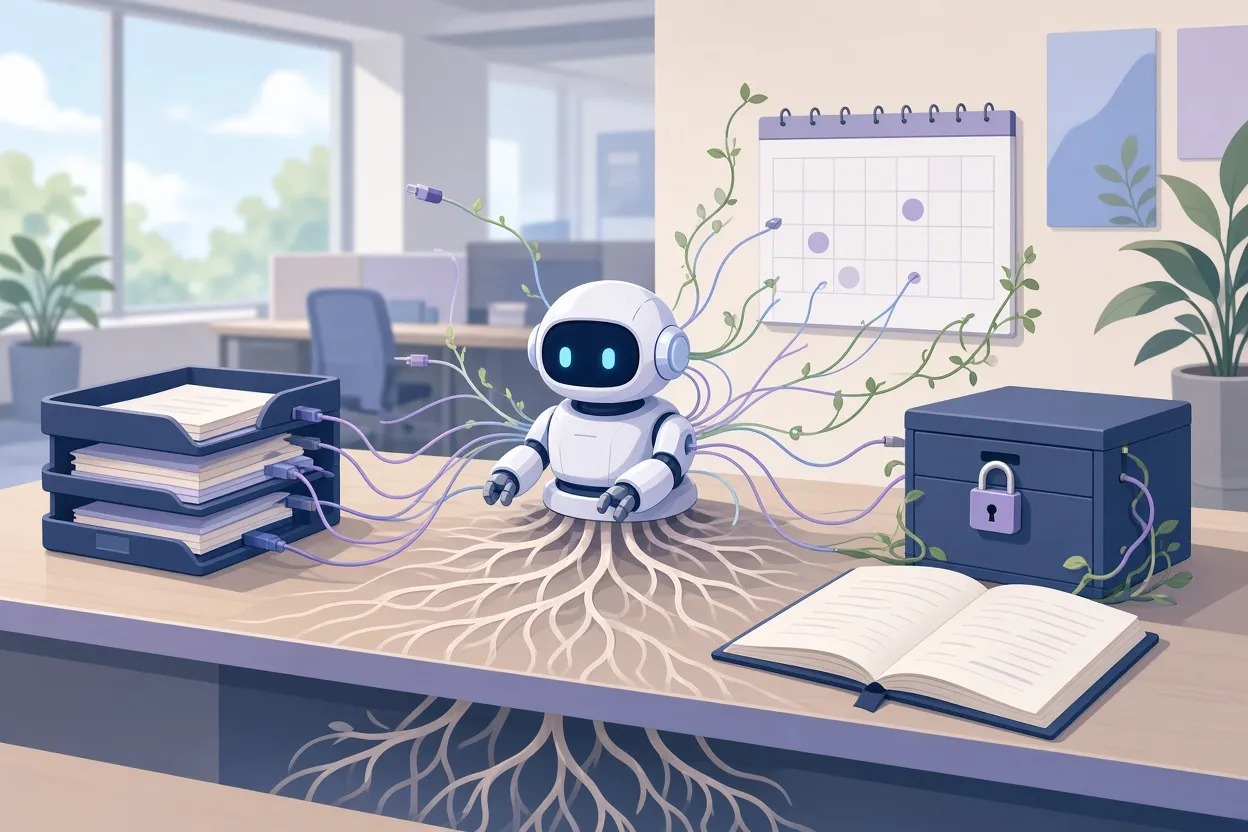
▲ 조직 안에 뿌리내린 agent
- Visa: 첫 협업은 사이버 방어였습니다.
- Amgen: 처음에는 생명과학과 신약 개발 용도로 시작했지만, 회사의 핵심 지식재산을 지키기 위해 사이버 보안을 우선순위에 올렸습니다. OpenAI는 Amgen이 자체 데이터를 밖으로 내보내지 않고도 sandbox(격리된 실험 환경) 안에서 reinforcement learning(강화 학습)으로 사이버 방어 agent를 훈련할 수 있게 지원합니다.
사이버 방어 역량의 근거로는 공개 인터넷의 약 70%를 마비시킬 수 있었던 심각한 PHP 취약점을 빠르게 patch(수정)하는 데 OpenAI가 도움을 줬다는 사례도 함께 들었습니다.
여기에 Dots 같은 가상 비서가 더해지면 붙잡는 힘이 한층 강해집니다. 직원들이 매일 하는 업무 습관이 자동화된 agent(스스로 여러 단계 작업을 수행하는 AI)를 중심으로 형성되기 때문입니다. 한 번 메일, 일정, 재무 시스템을 가로지르는 workflow가 Dots 위에 올라가면, 모델을 바꾸는 일은 곧 업무 방식을 바꾸는 일이 됩니다.
Dots는 왜 기업부터였고, 소비자는 언제 받나
Dots가 기업에 먼저 들어간 이유를 Friar는 '높은 고도에서 훈련한다'는 말로 설명합니다. 가장 복잡하고 서로 얽힌 기업 환경에서 먼저 agent를 다듬은 뒤 대중 소비자로 넓힌다는 전략입니다. 기업 환경에서 Dots는 이메일, 일정, 민감한 재무 소프트웨어까지 연결해 여러 단계의 작업을 수행합니다.
소비자 12억 명에게 같은 것을 내놓으려면 세 가지를 동시에 맞춰야 합니다.
- 컴퓨팅 자원 배분
- 마진이 남는 구조
- 작업마다 알맞은 모델을 알맞은 가격에 배정하는 일
이를 위해 OpenAI는 최근 Dots 아래에 Terra 모델을 넣어 추론 비용을 낮추겠다고 발표했습니다. Friar는 Dots의 소비자 출시가 올해 안에 시작될 것이라고 내다봤습니다. 소비자 쪽 습관은 이미 깊습니다. 매주 3억 명이 건강과 웰니스를, 2억 명이 개인 재무를 ChatGPT에 묻는다고 합니다. 이메일처럼 기업에서 소비자로 번진 기술도 있고 iPhone처럼 소비자에서 기업으로 번진 기술도 있는데, Dots는 전자의 길을 따르는 셈입니다.
다만 변수도 있습니다. Meta가 Muse 같은 제품으로 사용자 context를 적극적으로 모으고 있어, 소비자 출시가 늦어질수록 경쟁사 쪽으로 소비자 습관이 굳어질 수 있다는 지적이 가능합니다. 컴퓨팅 제약이 2027년과 2028년까지 이어질 것으로 보이는 상황에서, Friar도 제약이 실재하며 그래서 수익이 바로 나오는 기업 쪽에 agent를 먼저 배치할 수밖에 없다고 밝혔습니다.
비용 문제와 '2026년의 신화'
agent를 모든 사용자에게 주는 것은 사용자마다 클라우드 컴퓨터 한 대를 주는 것과 비슷한 부담입니다. 이 비용을 어떻게 감당하느냐에 대해 Friar는 두 갈래로 설명합니다.
첫째, 돈을 내는 소비자가 있습니다. 3분기에 유료 소비자 구독자가 1억 명을 넘었고, 이는 '소비자는 생성 AI에 돈을 내지 않는다'는 통념을 충분히 뒤집는 숫자라는 입장입니다. 동시에 사용자의 90%는 여전히 무료 등급에 있어, 장기적으로 광고와 상거래 모델로 수익화할 여지가 남아 있다고 봅니다.
둘째, 모델 자체를 가볍게 만듭니다. OpenAI는 frontier 추론 모델로 더 작은 nano, micro급 모델을 훈련해 Pareto frontier(비용 대비 성능이 최적인 지점)를 따라 효율적으로 돌아가게 합니다. 여기서 Friar가 '2026년의 신화'라고 부른 통념이 나옵니다. 중국의 open-source 모델이 frontier 연구소 모델보다 본질적으로 싸다는 믿음입니다. OpenAI의 경량 모델 Luna는 비슷한 중국 open-source 모델의 약 5분의 1에서 6분의 1 비용으로 frontier급 지능을 유지한다는 것이 반박의 근거입니다.
▲ 경량 모델로의 작업 배정
가격 탄력성도 확인됐습니다. Luna 출시 2주 뒤 가격을 80% 내리자 개발자의 token(모델이 처리하는 텍스트 단위) 사용량이 거의 10배로 뛰었습니다. Dots 같은 제품을 Luna와 Terra 위에 올리면 소비자 가격은 낮게 유지하면서 총마진을 넓힐 수 있다는 계산입니다.
기업이 open weights(가중치가 공개된 모델)를 찾는 이유는 보통 세 가지라고 합니다. 추론 비용, reinforcement learning 가능 여부, 데이터 주권입니다. OpenAI의 대응은 단일 모델 대신 Terra와 Sol 같은 모델 family(계열)를 제공하는 것입니다. 비용과 성능 목표에 따라 작업을 최적의 모델로 자동으로 배정합니다. 사이버 방어 쪽에서는 Astra가 큰 돌파구를 냈고 방어 측에 높은 지렛대를 준다고 설명했습니다.
모델 주권과 규제 산업 진입 경로
국가별 AI 주권 논의에 대해 Friar는 Stanford University 자료를 인용했습니다. 2025년에 미국은 frontier 모델 52개, 중국은 37개를 내놓은 반면 유럽은 1개에 그쳤습니다. 유럽 정책 당국도 국방과 사이버 같은 핵심 분야에서는 안전하고 신뢰할 수 있는 frontier 모델에 기대야 한다는 필요를 인식하고 있다고 합니다. 특히 사이버 보안에서는 외국의 위협 행위자가 이미 최첨단 역량을 쓰고 있어, 방어 시스템이 자국 모델이 나올 때까지 기다릴 여유가 없다는 점을 강조했습니다. 진정한 모델 주권은 막대한 자본과 컴퓨팅이 필요해 개별 국가가 이루기 매우 어렵다는 것이 Friar의 진단입니다.
이런 환경에서 정부 기관과 규제가 엄격한 금융 서비스에 OpenAI 모델을 공급하는 핵심 경로가 Amazon의 AWS Bedrock과의 협업입니다. 이미 검증된 클라우드 기반 위에서 안전하게 배포할 수 있다는 점이 주효했다고 합니다.
한국 기업 고객이 읽어야 할 세 가지
이번 실적 설명을 한국 기업의 입장에서 다시 보면 다음과 같이 정리할 수 있습니다. 어디까지나 OpenAI가 밝힌 전략에서 끌어낸 해석입니다.
| 관찰 | 한국 기업에 갖는 의미(해석) |
|---|---|
| 이탈 방지 전략이 context, 데이터, memory 결합에 있음 | 깊이 통합할수록 효율은 오르지만 나중에 모델을 바꾸는 비용도 함께 오름 |
| 모델 family가 작업을 자동 배정 | 가장 큰 모델만 쓰지 말고 싼 모델이 처리할 수 있는 작업을 먼저 가려낼 필요 |
| 규제 산업 진입 경로가 AWS Bedrock | 금융, 공공처럼 규제가 강한 조직은 검증된 클라우드 경로를 먼저 검토할 만함 |
첫째, 도입을 검토한다면 어떤 데이터와 workflow를 agent에 연결할지, 그리고 그 연결이 나중에 어떤 전환 비용으로 돌아올지 처음부터 따져 보는 것이 좋습니다. 둘째, 비용은 모델 선택으로 상당 부분 조절됩니다. 반복적이고 양이 많은 업무에는 Luna나 Terra 같은 경량 모델을, 복잡한 계획 수립에는 frontier 추론 모델을 배정하는 방식을 참고할 수 있습니다. 셋째, 자체 데이터를 밖으로 내보내지 않으면서 모델을 맞춤화하려면 sandbox와 reinforcement learning을 결합하는 경로가 있다는 점을 기억해 둘 만합니다.
Dots의 소비자 출시는 올해 안에 시작된다는 목표이지 확정된 날짜는 아닙니다. 기업 사용자라면 이미 쓸 수 있는 기업용 agent를 작은 부서 단위로 시험해 보고, 소비자라면 연말 출시 소식을 지켜보면서 어떤 데이터를 agent에 맡길지 미리 생각해 두는 것이 지금 할 수 있는 일입니다.


