같은 AI 모델과 같은 도구를 쓰더라도 사람에 따라 얻는 가치는 10배에서 100배까지 벌어질 수 있습니다. 그 차이는 요령보다 AI에 무엇을 맡기느냐는 야망의 크기에서 나오는 것으로 보입니다. Anthropic에서 Claude를 맡고 있는 한 엔지니어링 리드는 10월 13일 공개한 글에서 AI를 쓰는 야망을 속도, 고도, 깊이, 범위의 네 축으로 나눴습니다. 이 글은 그 가운데 고도, 깊이, 범위를 Claude Code와 AI agent(스스로 도구를 쓰며 작업을 이어 가는 AI)에 적용하는 방법을 정리합니다.
코드 생성은 이제 기본기
Anthropic 내부의 채용 평가 기록이 변화를 보여 줍니다. 채용 담당자의 평가 가운데 지원자의 AI 도구 활용 경험을 언급한 비율은 2024년 기술 직군에서 약 5%, 비기술 직군에서 약 7%였지만 2026년에는 각각 3배와 4배 수준으로 늘었습니다. Claude에 기능 하나를 써 달라고 하는 일은 누구나 하는 기본기가 됐고, AI 도구를 얼마나 창의적으로, 높은 수준에서 쓰는지가 평가의 중심으로 옮겨 간 것으로 읽힙니다.
네 축은 다음과 같습니다.
| 축 | 뜻 | 예 |
|---|---|---|
| 속도 | 손으로 하던 작업을 Claude로 더 빨리 끝내기 | 가장 기본적인 단계 |
| 고도 | 지시를 작업에서 결과로, 다시 목표로 끌어올리기 | 버그 하나 수정에서 충돌 없는 앱 유지로 |
| 깊이 | 한 작업을 그 분야 최고 전문가의 방법으로 하기 | 짐작 대신 profiler로 병목 찾기 |
| 범위 | 다른 분야가 이미 푼 문제인지 알아보기 | 오류 안내를 고객 지원의 눈으로 다시 설계 |
아래에서는 가장 기초적인 속도를 뺀 세 축을 차례로 살펴봅니다.
고도: 할 일 대신 결과와 그 너머의 목표를
고도를 높인다는 것은 지시의 수준을 절차적인 작업에서 원하는 결과로, 다시 결과 너머의 목표로 끌어올리는 일입니다. 절차를 하나하나 정해 주는 prompt(AI에 주는 지시문)는 모델의 능력을 지시하는 사람의 기술 지식 안에 묶어 둡니다. 결과와 목표를 주면 모델이 더 나은 구조와 해법을 스스로 따져 볼 여지가 생깁니다. 데이터베이스 성능 문제를 예로 들면 세 수준의 차이가 분명합니다.
| 수준 | Claude에 주는 지시 |
|---|---|
| 작업 | 주문 조회에 index를 추가해 줘 |
| 결과 | 실제 사용자에게 모든 페이지가 200ms 안에 열리게 해 줘 |
| 목표 너머의 목표 | 사용자가 일을 더 빨리 끝내게 해 줘. 가장 오래 기다리거나 이리저리 클릭하는 곳을 찾아 줄여 줘 |
결과 수준의 지시를 받으면 Claude는 index(데이터 검색을 빠르게 하는 색인)를 다는 것이 정말 최선인지부터 판단할 수 있습니다. 앞서 말한 리드도 20개월쯤 전에는 Claude에 특정 충돌(crash) 하나를 고쳐 달라고 했지만, 차츰 수준을 높여 앱 전체를 충돌 없이 유지하라고 맡기게 됐다고 합니다. 이 고도에서 agent가 일하려면 충돌 기록을 모으는 도구와 Windows, macOS, Linux에서 문제를 재현할 환경이 있어야 합니다.
도구부터 갖춰 주기
큰 목표를 맡기기 전에 먼저 agent에게 ’이 목표를 이루려면 어떤 도구와 권한, 환경이 필요한가’를 묻습니다. 예를 들어 Slack에 충돌 제거 전용 채널을 만들고, 그곳의 agent에 서비스를 충돌 없이 만들라는 목표와 함께 필요한 설정과 권한을 물은 뒤 12시간마다 스스로 돌게 할 수 있습니다. agent는 저장소와 의존성을 살펴본 뒤 지출 한도를 건 실험용 AWS 계정 같은 자원을 요청할 수 있고, 새 권한이 필요할 때 사람을 직접 불러 알릴 수 있어야 합니다.
agent는 빠진 도구를 스스로 요청하는 일이 드물어서, 일을 맡기기 전에 다음을 먼저 갖춰 주는 ‘도구 먼저’ 접근이 중요합니다.
- 오류 로그와 분석 이벤트에 대한 접근
- Stripe 같은 업무 시스템의 읽기 전용 권한
- 시험용 기기와 실제로 쓸 수 있는 로그인 계정
- sandbox(실제 서비스와 분리된 실험 환경)용 시험 계정을 만드는 권한
다만 넓은 인프라 생성 권한을 주기 전에는 sandbox에 분명한 비용 상한과 안전 경계를 정해 둬야 합니다.
사람이 중간 다리 노릇을 그만두기
고객 문의를 사람이 읽고 Claude Code에 줄 prompt로 옮긴 뒤 결과를 시험하며 몇 차례 주고받아야 문제가 풀리는 방식에서는, 사람이 고객과 AI 사이에서 말을 옮기는 중간 다리일 뿐이고 그 단계가 병목이 됩니다.
이 다리를 걷어 내려면 고객 문의를 받는 MCP(AI가 외부 도구와 데이터에 연결하는 표준 규격) 서버와 Sentry의 실시간 오류 기록을 agent에 함께 연결합니다. agent는 들어온 문의를 Sentry의 충돌 기록과 맞춰 보고 가상 환경에서 버그를 재현해 봅니다. 재현하지 못하면 어떤 브라우저를 썼는지, 단축키를 어떻게 설정했는지 사용자에게 직접 묻습니다. 한 앱에 일본어로 단축키 문의가 들어왔을 때는 agent가 macOS 기기를 빌려 문제를 재현해 보고, 사용자가 말한 ’key’가 키보드 단축키인지 API 키인지 되묻는 질문까지 스스로 작성했습니다.
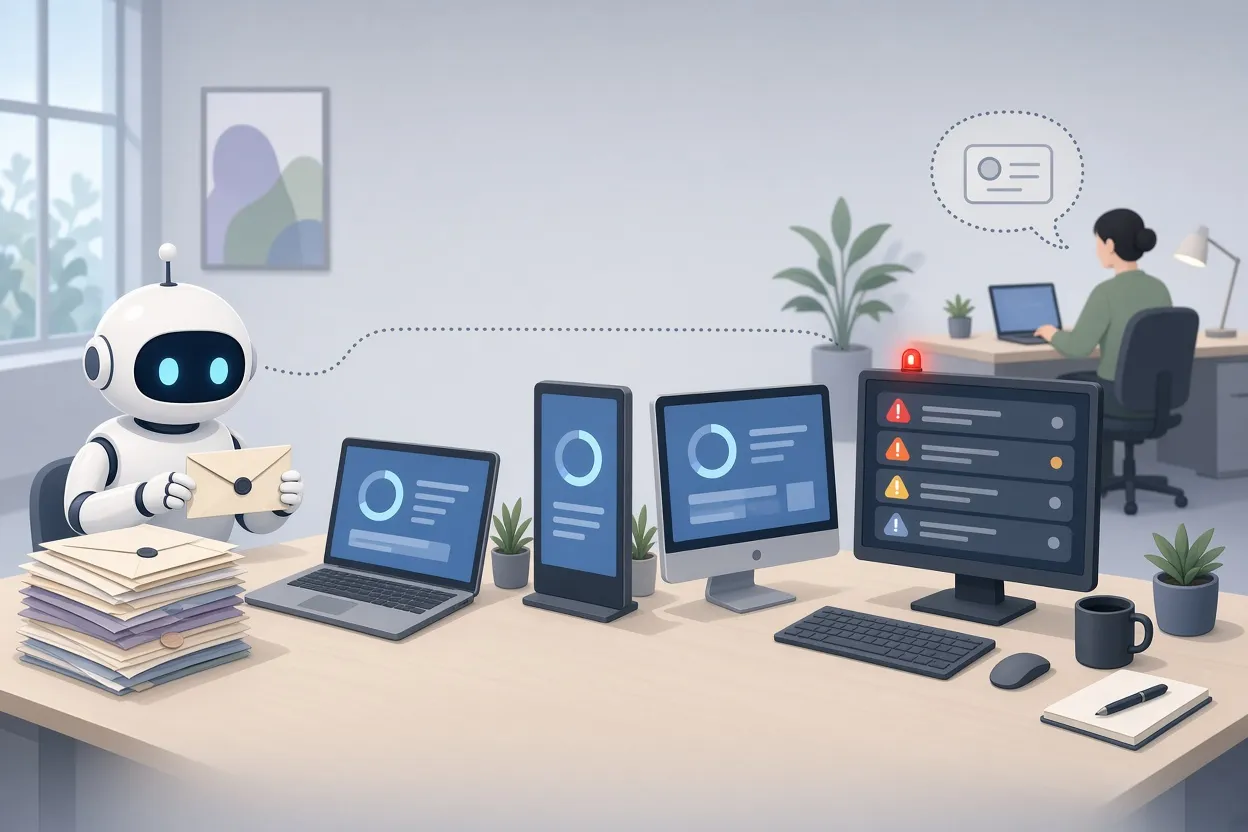
▲ 고객 문의를 재현하는 agent
대시보드 대신 질문하는 agent
분석 서비스를 MCP 서버로 agent에 연결하면 여러 서비스의 수치를 합친 대시보드를 그때그때 만들 수 있습니다. 그러나 대시보드를 보는 진짜 목적은 사업에 관한 질문에 답하는 데 있으므로, agent를 대시보드 제작자에서 질문하는 분석가로 올릴 수 있습니다. 예를 들어 다음처럼 지시합니다.
내 목표는 고객 만족과 매출을 높이는 것이야. 이 목표를 위해 매주 물어야 할 질문 10개를 생각하고, 답을 찾아서 그래프가 들어간 분석 보고서를 만들어 줘.
질문을 맡은 agent는 첫 방문에서 구매까지 걸린 시간의 중앙값이 약 4분이라는 점을 찾아 충동구매 패턴을 짚었습니다. 홍보용 영상을 끝까지 본 사용자일수록 오히려 구매가 적다는, 예상과 반대되는 관계도 발견했습니다.
지표를 맡기고 시스템을 겨냥하기
고도를 더 올리면 사람이 시킬 때만 움직이는 agent에서 지표를 책임지는 agent로 넘어갑니다. 고장 날 때마다 사람이 작업을 시작하는 대신, agent가 매출, 가입, 환불, 이탈, 앱 오류 같은 핵심 지표를 매일 또는 며칠 간격으로 살피고 이상이 생겼을 때만 사람에게 알립니다.
마지막 단계는 기능을 하나씩 맡기는 방식에서 벗어나 소프트웨어를 만들어 내는 시스템 자체, 곧 software factory(소프트웨어를 만들어 내는 공정 전체)를 겨냥하는 것입니다. 앱 하나에서 버그를 고치면 그 버그 하나만 사라지지만, 시스템 안의 패턴이나 구조를 고치면 그 수정이 시스템에 기대는 모든 앱과 화면으로 퍼집니다. 시스템을 겨냥한 agent는 사람이 계속 지켜보지 않아도 여러 앱에서 기능을 만들고 버그를 고칩니다. 실제로 한 GitHub 저장소에서는 agent들이 하루 24시간 문제를 찾아 PR(pull request, 코드 변경 요청)을 올리고 검증을 거쳐 병합까지 합니다. 다만 반복 작업과 버그는 agent에 맡기더라도 아주 크고 중요한 기능은 사람이 직접 살피고 구현하는 편이 안전해 보입니다.
깊이: 전문가의 말투가 아니라 방법을
깊이는 한 가지 작업을 그 분야 최고 전문가의 수준으로 해내는 것입니다. 모델에 ’전문가처럼 해 줘’라고만 하면 p-value(통계적 유의성을 나타내는 값)나 cohort retention(가입 시기별 고객 유지율) 같은 용어를 쓰기 시작할 뿐 실제 방법은 달라지지 않는 경우가 많습니다. 진짜 깊이는 Markdown 표나 짐작 대신 실제 데이터베이스, 통계 모델, 회귀 분석 도구를 쓰게 할 때 나옵니다.
앱 화면이 열리는 데 10초가 걸린다고 해 봅시다. 빠르게 해 달라는 평범한 지시에는 lazy loading(필요한 시점에 불러오는 방식)이나 React의 useMemo 같은 일반적인 처방이 돌아옵니다. 반면 성능 엔지니어처럼 profiler(프로그램의 어느 부분이 시간을 쓰는지 재는 도구) 기록부터 만들어 보라고 지시하면, Claude는 routing(요청을 처리할 곳을 정하는 단계), 인증, rendering(화면을 그리는 단계), 데이터베이스 조회를 하나씩 살펴 오래 걸리는 데이터베이스 조회처럼 정확한 병목을 짚어 냅니다.
목표는 일부러 무리해 보이게 잡는 편이 좋습니다. 5초면 충분한 상황에서도 200ms를 요구하고, agent가 처음에 불가능하다고 답해도 계속 밀어붙이면 모델이 겉핥기식 수정을 넘어 구조적인 최적화에 들어갈 수 있습니다.
앞의 리드가 평범한 prompt를 깊이 있는 명세로 바꾸려고 내놓은 meta-prompt(prompt를 다시 쓰게 하는 prompt)는 모델에 다음 네 가지를 묻게 합니다.
- 이 분야 최고 전문가라면 썼을 텐데 내가 빠뜨린 것은 무엇인가
- 가공하지 않은 원자료는 무엇인가
- 전문가가 쓰는 도구는 무엇인가
- 결과를 객관적으로 검증할 기준은 무엇인가
범위: 명사를 동사로 바꿔 다른 분야의 해법 빌리기
범위는 지금 부딪힌 문제를 전혀 다른 분야가 이미 풀어 두었는지 알아보는 능력입니다. 자기 분야에 갇히면 이런 연결을 놓치기 쉬운데, 이때 쓸 방법이 작업의 중심 명사를 사람의 행동과 목적을 담은 동사구로 바꾸는 것입니다. ’발표 자료’라는 명사를 ’바쁜 사람들이 원인과 결과에 관한 이야기를 믿고 불확실한 상황에서 30분 안에 결정하게 하기’로 바꾸면 기자, 편집자, 분석가의 방법이 눈에 들어옵니다. 어느 분야를 참고할지 모르겠다면 Claude가 내게 질문을 던지며 문제 구조를 파악해 비슷한 문제를 다루는 직업을 찾게 할 수 있습니다.
오류 안내를 고객 지원의 눈으로
HTTP 500 오류(서버 내부 오류) 화면에 이 방법을 적용하면 ’오류 메시지’는 ‘혼란에 빠진 사람이 누구에게도 연락하지 않고 혼자 막힌 곳을 풀게 돕기’, 곧 고객 지원 담당자의 일이 됩니다. Claude가 6개월 치 고객 문의를 분석해 오류를 빈도별로 묶자 로그인, 업로드, 결제, 내보내기의 네 가지 오류가 전체 문의의 약 61%를 차지했습니다. 이 가운데 파일 업로드 용량 제한 오류라면 ‘잠시 후 다시 시도해 주세요’ 같은 막연한 안내 대신, 6GB 파일이 요금제 한도인 5GB를 넘었다는 사실을 분명히 알리고 그 자리에서 파일을 압축하거나 요금제를 올리는 선택지를 보여 줄 수 있습니다.
기능 요청은 증상으로 읽기
사용자들이 CSV 내보내기 버튼을 거듭 요청하면 보통은 버튼을 만들고 요청을 닫습니다. 하지만 항생제를 달라는 환자에게 좋은 의사가 바로 처방하지 않고 증상부터 살피듯, 요청 뒤의 실제 필요를 먼저 진단할 수 있습니다. 진단하는 의사처럼 일하라는 지시를 받은 Claude가 CSV 요청 43건을 분석한 결과입니다.
| 요청 뒤의 실제 필요 | 요청 수 |
|---|---|
| 매주 월요일 Google Sheets 자동 동기화 | 29건 |
| 회계사에게 명세서를 손수 메일로 보내던 일 | 8건 |
| CSV 내려받기 버튼 자체 | 6건 |
이렇게 진단하면 기본 내보내기 버튼과 함께 Google Sheets 실시간 동기화, 매월 예약해 보내는 명세서 메일처럼 더 효과가 큰 기능을 만들 수 있습니다. 다만 지금의 최상위 모델은 이런 범위의 사고를 스스로 하지 않아 사용자가 분명하게 이끌어 내야 합니다. 앞으로 나올 모델은 특별한 prompt 없이도 이런 능력을 갖출 것으로 보입니다.
▲ 기능 요청을 진단하는 시각
모델은 계속 오르는데 기대치는 제자리
모델의 능력은 2주마다 한 단계씩 오르는 것으로 보이는데 사람의 기대치는 제자리에 머물러, 둘 사이의 간격이 벌어지고 있습니다. 그 리드의 글이 마지막에 꺼내는 개념도 자기 효능감, 곧 자신이 큰 결과를 낼 수 있다고 믿는 마음입니다. 다른 사람이 어려운 일을 해내는 모습을 보면 스스로 정한 한계가 다시 맞춰집니다. Roger Bannister가 1954년 5월 1마일을 4분 안에 달리자 46일 만에 다른 선수가 같은 일을 해냈습니다. 수학자 George Dantzig는 UC Berkeley 수업에 늦게 들어갔다가 칠판의 유명한 미해결 통계 문제 두 개를 숙제로 알고 풀었습니다. AI 활용도 다르지 않아 보이므로, 다른 사람이 agent로 해낸 일을 꾸준히 살피며 기대치를 올릴 필요가 있습니다.
정리: 다음 지시부터 바꿔 볼 것
같은 모델에서 더 많은 것을 얻는 길은 더 높은 목표, 더 깊은 방법, 더 넓은 시야에 있습니다. 바로 해 볼 수 있는 일은 다음과 같습니다.
- 다음에 Claude Code에 줄 지시 하나를 작업, 결과, 목표 너머의 목표의 세 수준으로 다시 써 봅니다.
- 큰 목표를 맡기기 전에 필요한 도구와 권한을 agent에게 묻고, sandbox에는 비용 상한과 안전 경계를 정합니다.
- 고객 문의와 오류 기록을 MCP로 agent에 연결하고, 재현하지 못한 문제는 사용자에게 직접 묻게 합니다.
- 대시보드를 보는 대신 매주 물어야 할 질문 10개와 그 답을 담은 보고서를 agent에 맡깁니다.
- 성능 문제에는 profiler 기록과 무리해 보이는 목표를 요구하고, 막히면 명사를 동사로 바꿔 다른 분야의 해법을 찾게 합니다.
아주 크고 중요한 기능은 사람이 직접 살피되, 반복되는 일부터 목표 단위로 넘겨 보면 같은 모델로 할 수 있는 일의 폭을 확인할 수 있을 것입니다.