이번 주에는 이미지, 언어, 음성 분야에서 새 AI 모델이 한꺼번에 쏟아졌습니다. 직접 써 보면 benchmark(모델 성능을 비교하는 표준 시험) 순위와 실제 쓸모는 꼭 같지 않았습니다. 특히 실용적으로 보인 것은 이미지에서 고칠 부분만 골라 바꾸는 Krea 3의 편집 기능이었고, 음성에서는 xAI의 Grok Voice 3.0이 사람과 대화하듯 멈칫함 없이 답했습니다. 반면 코딩 benchmark 1위에 오른 Meta의 Muse Wonder는 같은 과제로 만든 게임의 완성도가 경쟁 모델보다 떨어졌습니다.
이미지 모델, 생성보다 편집과 실행 환경
주요 이미지 모델의 기본 생성 품질은 이미 상당 수준이라, 이제 차이는 원하는 곳만 정확히 고칠 수 있는지, 내 컴퓨터에서 돌릴 수 있는지에서 나는 것으로 보입니다.
Krea 3, 고칠 곳만 상자로 골라 편집
공개 베타로 나온 Krea 3은 기본 생성에서는 GPT Image 2.5나 Nano Banana와 비슷한 수준이지만, 편집 방식이 다릅니다. 이미지 위에 상자를 그려 고칠 영역을 정하고 그 영역에 적용할 지시를 글로 입력하면, 나머지는 그대로 둔 채 그곳만 바뀝니다.
인물 사진과 스마트폰 화면이 담긴 썸네일로 시험해 봤습니다.
- 스마트폰 화면과 인물의 눈에 상자를 치고 화면 배경은 파랗게, 눈은 충혈된 붉은 눈으로 바꾸라고 하자 약 10초 만에 결과 3개가 나왔습니다.
- 화면 속 모델 이름을 Claude Haiku 5.5에서 Gemini 4 Argon으로, Anthropic 로고를 Google 로고로 바꿨습니다.
- 위쪽 큰 제목을 ’NEW MODEL!’로 바꾸면서 노란 글꼴 모양을 살렸고, 모자의 자수 문양은 야구 로고로 바꿨습니다.
바뀐 부분은 바느질 질감과 글자 굵기까지 주변과 자연스럽게 이어졌습니다. 썸네일이나 디자인 소재를 자주 손보는 사람에게는 대화로 고치는 편집기보다 깔끔한 결과를 주는 도구로 보입니다. 바꿀 요소만 꼭 맞게 상자로 감싸야 주변이 흔들리지 않고, 상자 여러 개에 지시를 달아 한 번에 보내면 여러 곳을 동시에 고칠 수 있습니다.
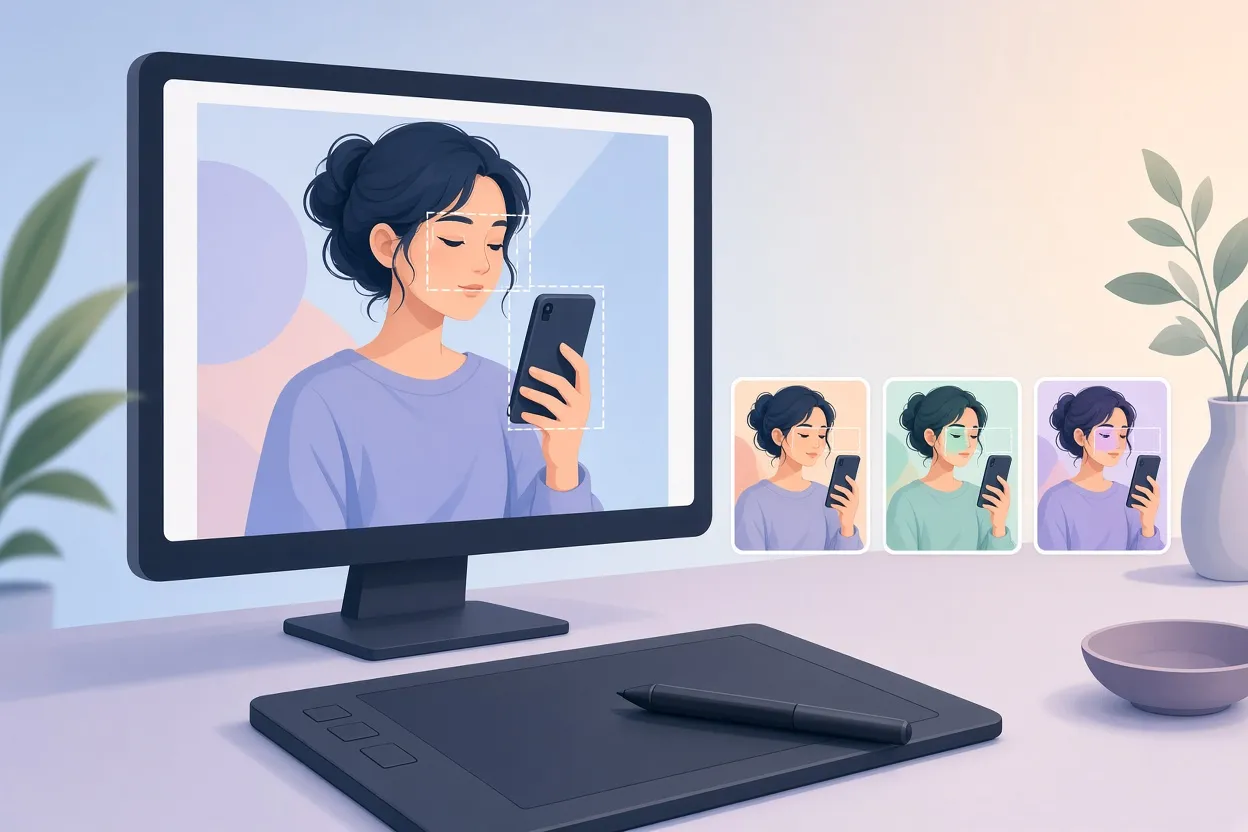
▲ 선택 영역만 바꾸는 부분 편집
소비자용 GPU로 내려온 open-weight 이미지 모델
open-weight(모델 가중치를 공개해 누구나 내려받아 쓸 수 있게 한 방식) 이미지 모델도 둘 나왔습니다. Black Forest Labs의 FLUX 3 Image Klein은 매개변수 56억 8,000만 개 규모로 이미지 생성, 여러 참고 이미지를 쓴 생성, 편집을 지원합니다. Hugging Face에서 가중치를 받아 fine-tuning(이미 학습한 모델을 특정 작업에 맞게 더 학습시키는 방법)할 수 있고, 지연 시간을 줄인 경량 구성도 있습니다.
| 실행 장비 | 이미지 생성 | 이미지 편집 |
|---|---|---|
| NVIDIA DGX Spark(약 $4,000급 장비) | 약 7.3초 | 16.2초 |
| NVIDIA GeForce RTX 4070(소비자용 GPU) | 8.9초 | - |
생성 시간 차이가 2초도 되지 않는 만큼, 보통 사용자에게는 내 데스크톱에서 고해상도 생성과 편집을 돌릴 수 있다는 점이 더 중요해 보입니다.
Alibaba의 Qwen-Image-2.1-Turbo는 Qwen-Image-2.1의 속도를 높인 판으로, 잡음을 걷어 내며 그림을 완성하는 단계를 8번으로 줄였습니다. 미세한 묘사는 조금 손해 보지만 처리량은 크게 늘어납니다. 분자 그림과 손글씨 메모가 들어간 화학 학습 포스터처럼 구조가 복잡한 이미지도 만들어 냈습니다. 두 모델 모두 Hugging Face Spaces에서 무료로 먼저 써 볼 수 있지만, 사용자가 몰리면 느려지거나 대기열이 생길 수 있습니다.
음성 모델, 응답 속도가 대화를 바꿉니다
xAI가 내놓은 Grok Voice 3.0은 말을 듣고 바로 말로 답하는 실시간 음성 모델입니다. xAI는 응답 지연과 목소리의 자연스러움에서 benchmark 최고 기록을 세웠다고 밝혔고, 음성 benchmark 종합 점수 86.9를 내세웠습니다.
xAI의 시험 환경에서는 음성 agent(목표를 받아 스스로 작업을 이어 가는 AI 프로그램)의 지시문, 첫인사, 답변 규칙, 말을 끊을 때의 처리, 목소리를 정할 수 있습니다. 이렇게 만든 웹사이트 고객 지원 agent는 말이 끝나자마자 답해 흔히 쓰는 음성 비서보다 훨씬 빠르게 느껴졌습니다. 중간에 말을 끊어도 자연스럽게 받아 냈고, 영상 제작에 쓸 도구를 묻자 사이트 자료에서 두 가지를 추천했으며, 최신 AI 소식을 묻자 사이트 기사를 인용해 답했습니다.
음성 agent를 만든다면 prompt(AI에 주는 지시문)에 답하면 안 되는 범위를 금지 조건으로 적어 정한 자료 안에서만 답하게 하고, 침묵 대기 시간과 끼어들기 기준을 조정해 사람 말에 겹쳐 말하지 않게 하는 것이 좋습니다.
ElevenLabs는 ElevenCreative에 Instant Soundtracks를 내놓았습니다. 영상을 올리면 장면 변화, 속도, 전환을 분석해 배경 음악과 효과음을 시간에 맞춰 자동으로 붙여 줍니다.
▲ 지연 없는 실시간 음성 상담
언어 모델, benchmark 순위와 결과물은 달랐습니다
Gemini 4 Argon, 할인 가격은 11월 말까지
Google은 9월 30일 처음 발표한 Gemini 4 Argon을 개발자용 API와 Google AI Studio, 유료 요금제 AI Ultra와 Pro에 정식으로 공개했습니다. OpenAI의 GPT-6 Astra, Anthropic의 Claude Opus 5.5와 겨루는 모델입니다. API 출시 기념 가격은 100만 token(모델이 글을 처리하는 단위)당 입력 $2, 출력 $10이며 11월 말이 지나면 대략 두 배로 오릅니다. 모델 평가 기관 Artificial Analysis의 지능 지수는 53점으로 Claude Opus 5.5보다 5점 낮지만, 작업당 비용은 훨씬 적습니다.
인물 캐리커처를 SVG(점과 선을 수식으로 그리는 벡터 그림 형식) 코드로 그리게 하고 AI 심사단이 채점하는 시험에서는 약 4분, $0.34로 7.6점을 받아 GPT-6.1 Sol에 이어 2위에 올랐습니다. prompt 한 번으로 만들게 한 3D 액션 게임도 3인칭 이동, 연속 점프, 강화 카드까지 실제로 작동했지만 그래픽은 기초적이었습니다. Google 개발팀이 강점으로 꼽은 3D 프린팅용 CAD 모델 생성도 시험해 보니, 얼굴 사진 한 장으로 만든 STL 파일로 출력한 흉상은 정면이 꽤 닮았고 옆모습은 다소 납작했습니다.
Muse Wonder, 코딩 benchmark 1위와 투박한 결과물
Meta의 Muse Wonder는 코딩 benchmark DeepSWE에서 Muse Wonder Full이 79.0%, 기본 Muse Wonder가 78.8%로 Claude Opus 5.5(74.2%)와 GPT-6 Astra(74.1%)를 앞섰습니다. Artificial Analysis 지능 지수도 Gemini 4 Argon, GPT-6 Astra보다 높고 Claude Sonnet 5.5와 같습니다. 가격은 Claude Opus 5.5와 비슷하고, 작업당 비용은 평가 모델 가운데 다섯 번째로 높지만 Claude Opus 5.5보다는 조금 낮습니다.
직접 써 보면 숫자만큼 압도적이지 않았습니다. 캐리커처 시험은 6.6점으로 14위였고, 3D 게임 과제에서는 조작, 충돌 판정, 카메라, 몰려오는 적까지 갖춘 게임을 만들었지만 화면이 단순하고 움직임이 뻣뻣해 Claude Opus 5.5나 Gemini 4 Argon의 결과물보다 덜 다듬어졌습니다. benchmark 순위만 보고 모델을 고르기 어려운 이유입니다.
| 항목 | Gemini 4 Argon | Muse Wonder |
|---|---|---|
| API 가격(100만 token당) | 입력 $2, 출력 $10(11월 말까지) | 입력 $4, 출력 $20 |
| 캐리커처 SVG 시험 | 7.6점, 2위, $0.34 | 6.6점, 14위, $0.3422 |
| 3D 게임 한 번에 만들기 | 작동, 그래픽은 기초적 | 작동, 단순하고 뻣뻣함 |
크기, 속도, 가격으로 나뉜 다른 새 모델
Meta의 Muse Spark Open은 비공개 최상위 모델이던 Muse Spark를 Muse Wonder 출시 뒤 open-weight로 공개한 것으로, Meta는 미국에서 나온 open-weight 모델 가운데 가장 뛰어나다고 소개합니다. 매개변수 8,160억 개 가운데 token마다 420억 개만 쓰고, context window(모델이 한 번에 다루는 입력 길이)는 100만 token입니다. Apple과 함께 MLX로 최적화해 M5 Ultra Mac Studio 두 대에서 돌아가고, 일반 과제에서는 Mistral Large 4와 Qwen 3.8을 앞서지만 DeepSWE에서는 Kimi K3에 뒤집니다. 다만 로컬 실행에 $1만 가까운 장비가 필요해 소비자용이라 부르기는 어려워 보이고, 캐리커처 시험 점수도 3.9점에 그쳤습니다.
- Nemotron 3.5 Super VL: NVIDIA의 매개변수 1,200억 개 open-weight 시각·언어 모델입니다. 지능 지수는 26으로 DeepSeek, Qwen 3.8, GLM 5.3보다 낮지만 더 똑똑한 open-weight 모델보다 초당 출력 token이 약 5배 많아, 응답 지연이 중요한 agent 작업에 맞아 보입니다.
- MAI-Base 2: Microsoft가 초기 사전 학습을 마친 매개변수 2조 8,000억 개(활성 800억 개) 기반 모델입니다. 기존 open-weight 모델보다 사전 학습 평가가 앞선다고 밝혔지만, 사후 학습 전이라 일반 공개와 외부 평가는 아직입니다.
- Ultramarine 1 Flash: 한 AI 기업이 내놓은 지식 업무용 open 모델로, 100만 token당 입력 $0.15, 출력 $0.50입니다. 금융, 법률, 컨설팅 업무에서 Claude Fable 5.1 수준의 성능을 약 60분의 1 비용으로 낸다고 주장하지만 아직 외부 검증 전입니다.
OpenAI의 28일 연속 발표, 둘째 주는 잠잠
OpenAI가 10월 4일 발표한 ‘28 Days of Shipping’(28일 동안 새 기능을 잇달아 내놓는 행사)은 둘째 주에는 첫 주보다 눈에 띄는 발표가 적었습니다.
| 날짜 | 내용 |
|---|---|
| 5일째 | Codex의 Composer Predictions, Pro 사용자에게 다음 prompt 제안 |
| 6·8·10일째 | 새 기능 없이 사용량 초기화 |
| 7일째 | Codex 등에서 GPT-6.1 Sol의 기본 context window를 27만 2,000 token에서 50만 token으로 약 84% 확대 |
| 9일째 | ChatGPT와 Codex 데스크톱 앱의 디스크 사용량 약 60% 감소 |
| 11일째 | 컴퓨팅 자원 증설, 모델 용량이 차면 막지 않고 뒤에서 자동 재시도 |
9일째와 11일째 발표에는 늦은 버그 수정과 서버 관리를 새 기능처럼 내놓았다는 이용자 비판이 많았습니다.
판단만 맡기는 decision model
글을 길게 만드는 대신 정해진 선택지에서 답을 고르고 확률을 매기는 decision model도 잇따라 나왔습니다. Microsoft-Decision-1은 Qwen2.5-9B를 fine-tuning해 예·아니오, 객관식, 점수 매기기, 기준표에 따른 AI 답변 평가에 보정된 확률을 내놓습니다. 한 AI 기업의 Nimble-v4-max는 판단 과제 정확도 85.0%로 경쟁 모델보다 오류가 43% 적다고 밝혔습니다. 회사마다 성능 차이는 크지 않아 보이지만 요청 배분, 콘텐츠 검토, 채점처럼 판단만 필요한 작업에 큰 언어 모델 대신 쓰면 비용과 응답 시간을 줄일 수 있습니다.
순위표보다 내 작업으로 시험할 때
새 모델들은 benchmark 점수보다 편집 제어, 응답 속도, 실행 비용에서 쓸모가 갈린 것으로 보입니다. 코딩 benchmark 1위 모델이 결과물 완성도에서 밀리고, 지능 지수가 낮은 모델은 속도로 쓸 곳을 찾습니다.
- 이미지를 자주 고친다면: Krea 3 공개 베타에서 부분 편집을 시험합니다.
- 내 PC에서 이미지를 만들려면: FLUX 3 Image Klein이나 Qwen-Image-2.1-Turbo를 Hugging Face Spaces에서 먼저 시험합니다.
- API 비용이 고민이라면: 11월 말 할인이 끝나기 전에 Gemini 4 Argon을 시험합니다.
- 응답 속도가 중요한 agent라면: Nemotron 3.5 Super VL 같은 빠른 모델이나 decision model을 검토합니다.
- 음성 agent를 만든다면: 답할 범위와 끼어들기 기준부터 정합니다.
- 모델을 고를 때는: 종합 순위표보다 코딩은 DeepSWE, 법률·금융은 DiligenceBench처럼 내 분야의 benchmark를 봅니다.