Google이 Gemini 4 Argon을 Gemini 앱과 Google AI Studio, Google Cloud의 Gemini API, Antigravity에서 쓸 수 있게 정식 공개했습니다. 첫 benchmark(모델 성능을 비교하는 시험) 결과를 내놓은 지 약 2주 만이고, 출시 전에는 직원 10만 명 이상이 모델을 직접 시험했습니다. 눈에 띄는 변화는 한 번에 최대 100만 token(AI가 글을 잘게 나눠 처리하는 단위)을 출력하는 능력과, AI 특유의 뻔한 글투를 걷어 내도록 다듬은 글쓰기입니다. Google은 Argon이 다음 세대 모델을 만드는 데도 이미 쓰이고 있다고 강조합니다. 달라진 점과 써 볼 작업, 결과 확인 요령을 정리합니다.
공개까지 2주, 무엇을 시험했나
Google은 첫 benchmark 결과를 발표한 뒤 정식 공개까지 약 2주 동안 다음과 같은 점검을 거쳤다고 설명합니다.
| 점검 | 내용 |
|---|---|
| 보안 점검 | 보안 기업 Wiz 등 협력사와 Argon으로 주요 시스템의 취약점을 찾아 고침 |
| 단계적 공개 | 일부 기업 고객에게 먼저 제공해 실제 운영 환경의 피드백과 예외 사례 수집 |
| 전문 분야 평가 | Google DeepMind 연구자들이 양자 컴퓨팅, 로봇공학, 첨단 과학 연구 분야에서 평가 |
| 안전성 평가 | 미국 정부에 모델을 제출해 안전성 평가를 맡김 |
| 내부 시험 | 직원 10만 명 이상이 사용, Google 역사상 손꼽히는 규모의 출시 전 내부 평가 |
안전 대책은 두 겹입니다. 모델 가중치 안에서 작동하는 내부 감시와, 추론 과정 바깥에 두는 guardrail(위험한 입력과 출력을 걸러 내는 장치)을 함께 강화했습니다.
내부 사용은 개발자에 그치지 않고 Google Cloud 영업팀까지 넓어졌습니다. Google은 이를 코드뿐 아니라 일반 지식 업무에서도 쓸 만하다는 근거로 봅니다. 이전 checkpoint(학습 도중 저장해 둔 모델 버전)에 깐깐한 평가를 내놓던 내부 시험자들의 반응도 눈에 띄게 긍정적으로 바뀌었다고 합니다.
출력 100만 token, 한 번에 길게 생각한다
Google은 입력 100만 token을 업계에서 먼저 선보인 데 이어, 이번에는 한 번의 생성 단계에서 최대 100만 token을 출력하는 기능을 업계 최고 수준이라며 내놓았습니다. 이전 세대의 출력 상한은 64k token이었고, 이 상한이 어려운 문제에서 모델의 추론 능력을 억눌렀다는 것이 개발진의 설명입니다.
| 항목 | 이전 | Gemini 4 Argon |
|---|---|---|
| 한 번에 낼 수 있는 출력 | 64k token(이전 세대 상한) | 100만 token |
| 100만 token 생성 방식 | 여러 단계를 이어 붙여야 가능(Gemini 1.5 Flash 등) | 한 번의 추론 단계에서 가능 |
쓰임새는 어려운 수학 문제나 정답이 정해지지 않은 과학 연구처럼 chain-of-thought(단계를 밟아 생각을 이어 가는 추론 과정)를 길게 펼쳐야 하는 문제입니다. 개발자는 reasoning effort(모델이 얼마나 깊이 생각할지 정하는 설정)를 high로 두면 됩니다. 문제가 깊은 계산을 요구하면 모델이 생각의 길이를 최대 100만 token까지 늘립니다.
Google 공동 창업자 Sergey Brin의 계산으로 100만 token은 약 50만 초 동안 집중해서 생각한 분량입니다. 쉬지 않고 생각하면 꼬박 일주일, 일하는 시간으로 치면 한 달가량의 사고를 질문 하나에 담는 셈입니다.
AI slop을 걷어 낸 글쓰기
Google Labs 부사장 Josh Woodward는 Gemini 앱에서 특히 공을 들인 부분으로 글의 질을 꼽습니다. 목표는 AI slop(AI가 찍어 낸 듯한 뻔하고 질 낮은 글)을 걷어 내는 것이었습니다. 지나치게 많은 글머리 기호 목록, 예상 가능한 채움말, ‘솔직히 말하면’ 같은 상투적인 연결어가 대표적입니다. Google은 전문 작가들이 모델 출력에 주석을 달아 만든 모범 데이터를 학습의 기준으로 삼았고, 그 결과 Argon의 글은 대형 언어 모델 특유의 획일적인 말투를 피해 더 간결하고 개성 있게 읽히도록 다듬어졌다고 설명합니다.
개발진이 직접 쓰는 방법은 말로 쓰고 AI로 다듬는 방식입니다. Woodward는 걷거나 출퇴근하면서 떠오르는 생각을 음성 메모로 남긴 뒤, Argon에 깐깐한 교열자 역할을 맡겨 가장 약한 논거 세 가지, 놓친 관점, 독자가 헷갈릴 만한 개념을 짚어 달라고 요청합니다. 다만 모델이 뛰어난 교열자이자 생각 상대가 될 수는 있어도, 독창적인 생각을 세우는 데는 여전히 사람의 판단이 필요하다고 말합니다.
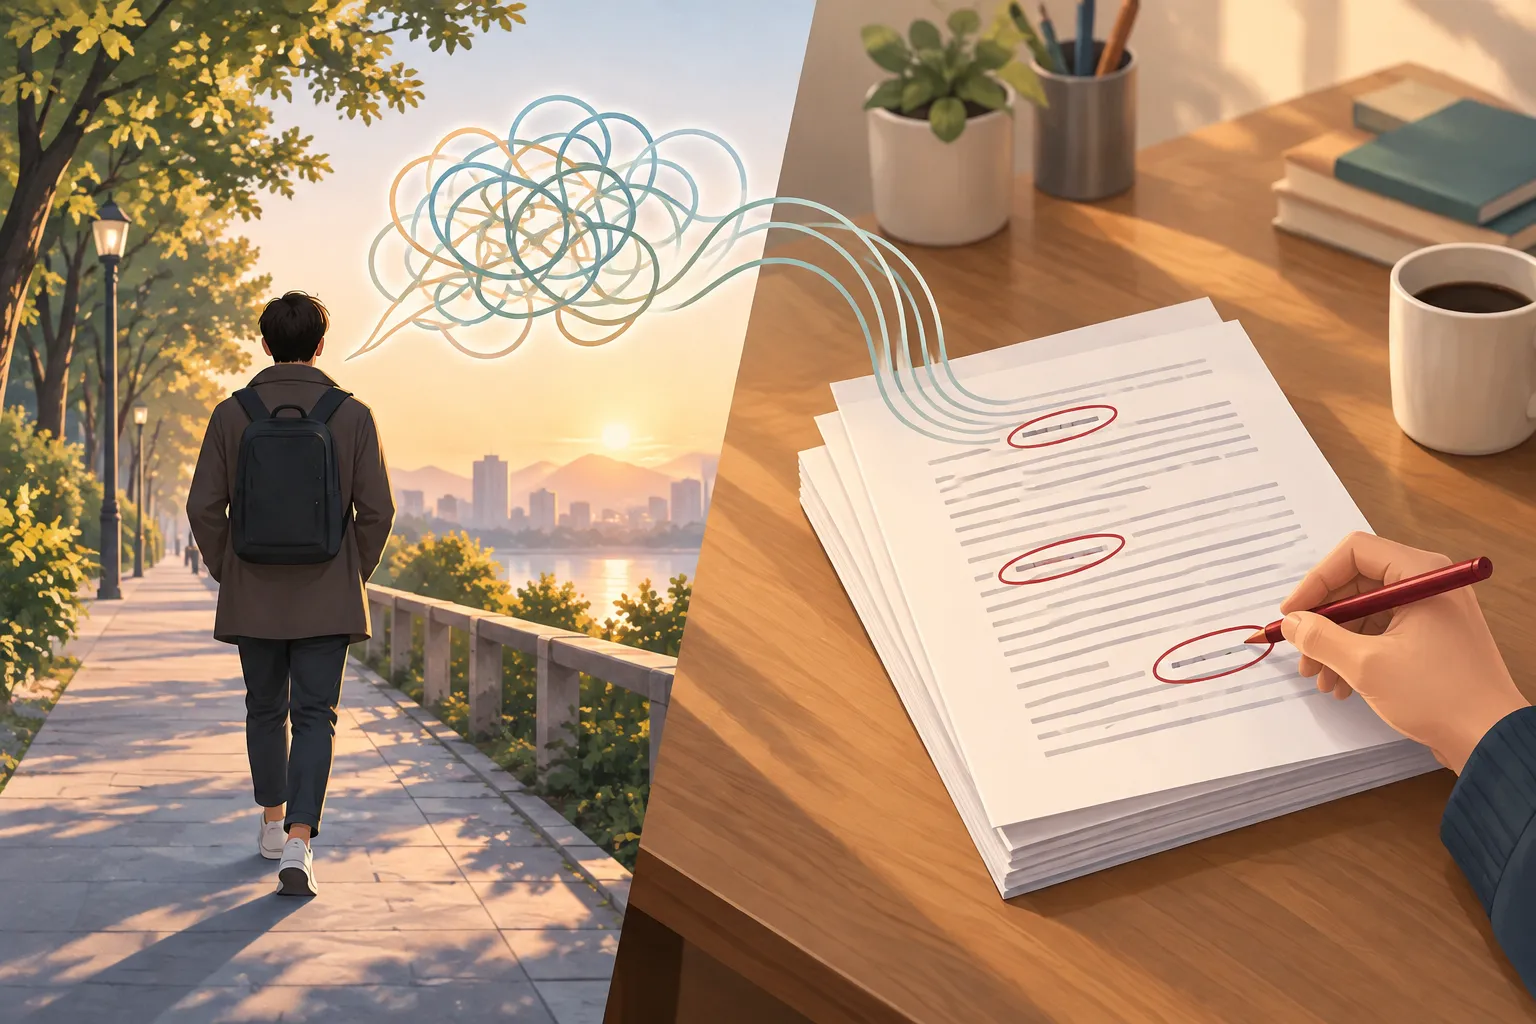
▲ 음성 메모를 다듬는 교열
Google DeepMind의 한 제품 책임자는 손목 통증을 덜려고 정리되지 않은 생각을 두서없이 말로 모델에 들려줍니다. 이전 모델은 이런 말을 빽빽하고 어색한 요약으로 바꾸기 일쑤였지만, Argon은 구조가 잡힌 깔끔한 문서로 정리해 준다고 합니다. 글투가 마음에 들지 않으면 목록 남발과 ‘솔직히 말하면’ 같은 채움말, 틀에 박힌 구성을 피하라고 직접 지시하는 방법도 있습니다.
AI가 다음 AI를 만드는 개발 방식
Gemini의 post-training(기본 학습을 마친 모델을 다듬는 추가 학습)을 이끄는 연구 부사장은 Argon을 AI agent(스스로 판단해 일을 처리하는 AI)가 학습 과정 전반에 적극 참여한 첫 주요 모델이라고 설명합니다. 학습 파이프라인에 들어간 agent가 맡은 일은 다음과 같습니다.
- 가장 큰 규모의 학습 작업을 계속 지켜보며 시스템 설정 오류 감지
- 학습에서 좋은 행동에 주는 보상의 크기가 적절한지 점검
- 버그를 찾아 코드 수정안 제안
- post-training 전과 도중에 데이터의 중복과 불일치 검사
연구자들이 자원을 요청하는 방식도 바뀌었습니다. 예전에는 GPU나 TPU 칩을 500개, 1,000개 단위로 요청했다면, 이제는 Argon의 QPS(초당 처리하는 요청 수)를 5, 10, 15처럼 요청합니다. 모델에 학습 데이터를 만들게 하고 그 데이터로 다음 버전을 학습시키기 때문입니다. Sergey Brin은 Argon이 자신의 학습 데이터에 섞인 잘못된 수학 정리 증명을 찾아내고 올바른 반례를 만들어 낸 일도 있었다고 전합니다.
개발 주기도 짧습니다. Google DeepMind는 3~4주 단위로 학습을 반복하며 2~3주마다 후보 checkpoint를 평가해 다음 단계로 올리고, Argon도 공개 전 3~4주 동안 내부 post-training 시험을 거쳤습니다. Brin은 Flash 모델을 3.6, 3.7, 3.8로 잇달아 내놓은 최근의 출시 속도를 예로 들며, 모델이 연구자와 함께 다음 모델을 설계하는 recursive self-improvement(AI가 다음 AI 개발을 도우며 발전 속도를 스스로 높이는 순환)의 쳇바퀴에 올라섰다고 표현합니다. 내부 연구팀은 보통 공개된 모델보다 몇 세대 앞선 모델을 다룹니다.
Brin이 꼽은 진전의 동력은 출시 주기를 의도적으로 앞당긴 결정, 그리고 지금 모델로 다음 세대 모델을 끌어올리는 방식입니다. 세대가 바뀔 때는 일정표대로 나오지 않는 기초 연구의 돌파도 있었다고 덧붙였습니다. 그는 AI 발전과 출시 속도가 앞으로 더 빨라질 것으로 내다보지만, 이는 Google 공동 창업자의 전망인 만큼 실제 속도는 다음 모델들로 확인해야 할 것으로 보입니다.
Google 안에서 먼저 나온 사례
공개에 앞서 사내 사례를 모아 보니 여러 엔지니어링 팀이 이미 Argon을 폭넓게 쓰고 있었습니다.
| 사례 | Argon이 한 일 |
|---|---|
| Chromium 팀 | 브라우저 개발 흐름과 복잡한 코드 작업에 적극 활용 |
| Gemma 개발 | Google의 open-weight 모델(학습된 가중치를 공개한 모델) 계열 Gemma를 여러 benchmark에서 최적화 |
| 오래된 코드 이전 | Antigravity 팀이 외부 고객사의 Fortran 코드를 Rust로 옮기는 작업에 활용 |
| 데이터센터 게임 | prompt(AI에 주는 지시문)만으로 GPU 교체와 유지보수를 다루는 시뮬레이션 게임 제작 |
| 읽기 학습 앱 | 팀원의 어린 아들을 위해 유아 학습 이론부터 조사해 학습 단계를 짜고 코드 작성과 배포까지 처리 |
| Minecraft 같은 게임 | prompt 두 번으로 화면과 동굴 채굴, 상태 표시까지 갖춘 게임 생성 |
몇 달 묵은 하드웨어 결함을 찾아내다
가장 인상적인 사례는 하드웨어 진단입니다. Google의 대규모 학습 작업에서 학습용 기계가 자꾸 손상된 상태에 빠졌지만, 팀은 오랫동안 원인을 찾지 못해 이 실패를 안고 지내 왔습니다. 한 엔지니어가 진단 문제를 Argon에 맡기자, 모델은 원인이 물리 하드웨어 자체의 결함이라고 짚었습니다.
하드웨어 팀은 처음에 이 분석을 AI slop이라며 믿지 않았습니다. 엔지니어들이 직접 마주 앉아 따져 보고 부품 공급업체에 확인한 끝에, 원인이 HBM(고대역폭 메모리)의 조용한 데이터 손상으로 밝혀졌습니다. 메모리 오류를 잡아내는 ECC(오류 정정 코드)도 이 손상을 감지하지 못했기에 모델의 진단이 결정적이었고, Google은 전체 서버에서 문제가 있는 기계를 찾아 격리할 수 있었습니다.
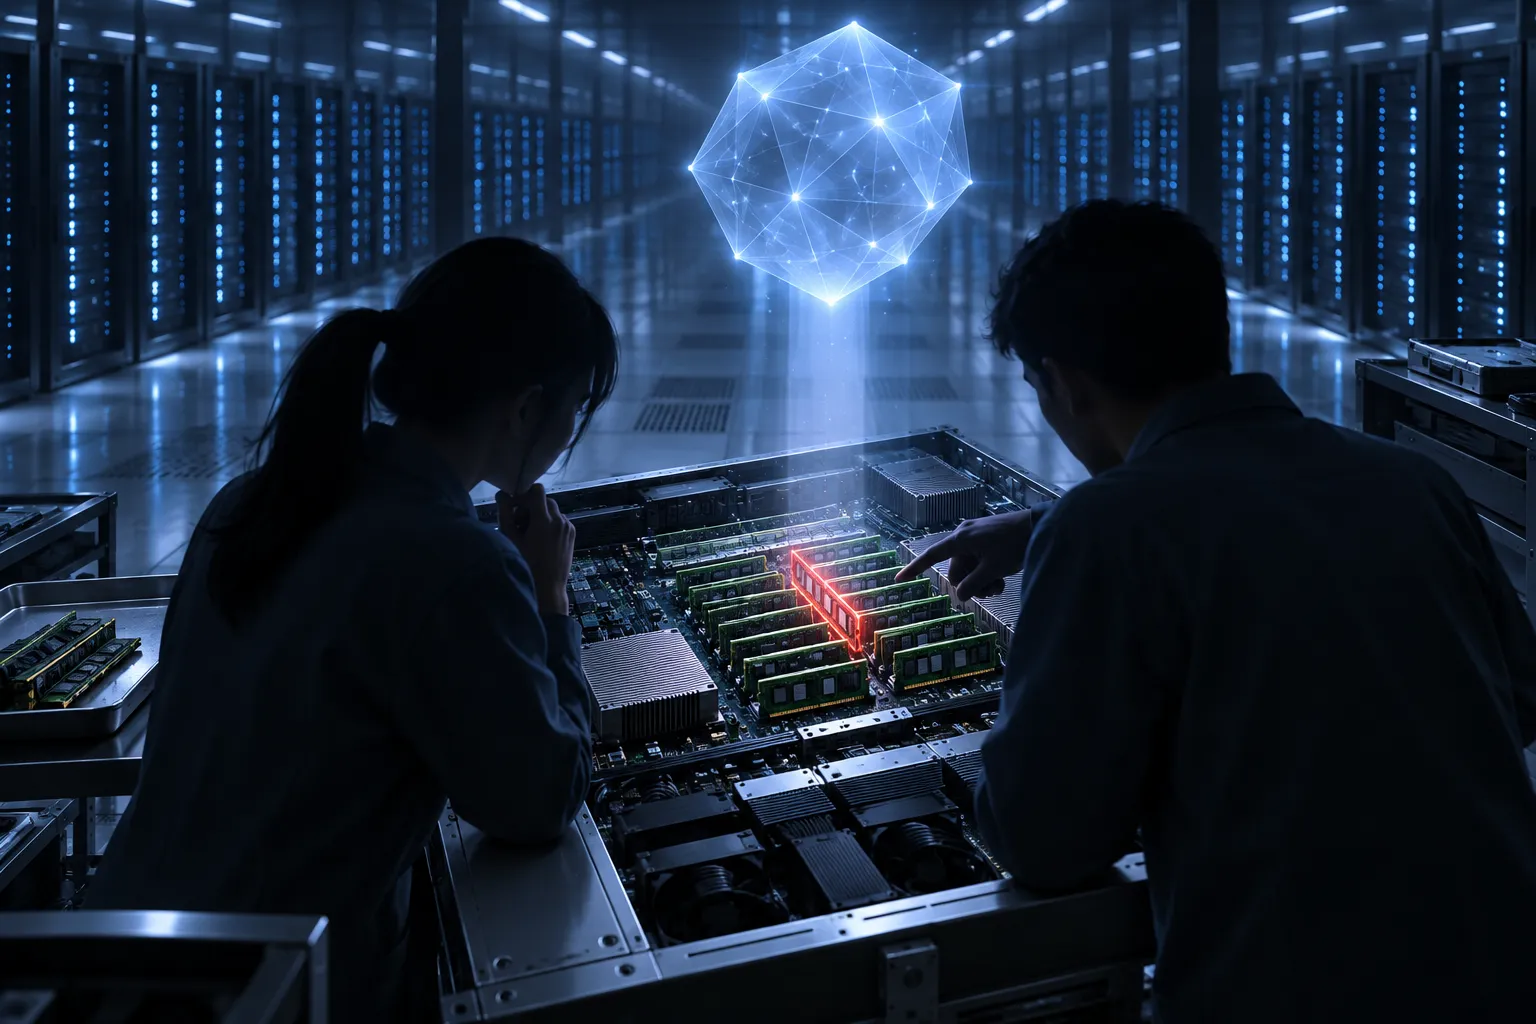
▲ 숨어 있던 메모리 손상 진단
Sergey Brin은 1998~1999년 무렵 Google이 처음 들인 서버 20여 대에서 겪은 일을 떠올립니다. 업체가 넣은 고사양 메모리가 메인보드와 맞지 않아 몇 시간마다 데이터가 깨졌고, 원인을 찾는 데 며칠이 걸렸습니다. 약 30년 만에 비슷한 메모리 문제를 이번에는 AI가 찾아낸 셈입니다.
결과를 그대로 믿지 않는 법
Argon이 널리 쓰이면 놀랍거나 복잡한 결론을 어떻게 믿을지가 과제가 됩니다. 대기업 밖의 개발자에게는 Google처럼 직원 10만 명이 함께 검증해 줄 동료 집단이 없습니다. Google은 Argon이 근거에 충실하고 sycophancy(사용자의 비위를 맞추려 듣기 좋은 답을 하는 경향)를 피하며, 결과를 부풀리거나 설명을 지어내지 않는다고 설명합니다. 그래도 결과를 확인하는 습관은 필요합니다. 개발진이 권하는 방법은 다음과 같습니다.
- 의심의 기준을 같게 두기: Sergey Brin은 생각이 AI에서 나왔든 동료에게서 나왔든 똑같이 의심해야 한다고 말합니다.
- 다른 모델에 비평 맡기기: 모델은 자존심이 없어 다른 모델이나 이전 결과의 결함을 거리낌 없이 짚습니다. 서로 다른 모델을 함께 쓰면 여러 관점에서 검증할 수 있습니다.
- 한 번에 나온 답에 머물지 않기: Josh Woodward는 개발의 병목이 코드 작성에서 코드 검토로 옮겨 가고 있다고 봅니다. 이상한 답은 원래 prompt를 동료와 함께 다듬어 다시 묻고, 더 깊이 파고들라고 거듭 요청하면 더 나은 결과가 나옵니다.
- 생각을 통째로 맡기지 않기: 모델을 브레인스토밍 상대로 보고, 출력을 꼼꼼히 읽으며 이상한 대목은 직접 되묻습니다. 미묘한 논리 오류는 추론이 앞뒤가 맞는지 적극적으로 따져 볼 때 드러나고, 비전문가일수록 놓치기 쉽습니다.
끈질김과 확인 질문 사이의 균형
모델의 행동을 조율하는 일은 서로 부딪히는 목표 사이에서 균형을 잡는 일입니다. 지나치게 끈질긴 모델은 방향을 바꿔야 할 때도 밀고 나가다 엉뚱한 길로 빠지고, 너무 소극적인 모델은 질문을 지나치게 많이 던져 사용자를 지치게 합니다.
생각 과정을 얼마나 보여 줄지도 같은 문제입니다. 자세히 보여 주면 투명해지지만 지나치게 길면 화면을 압도합니다. Google은 내부 시험 대화방의 반응을 Argon으로 요약해 균형점을 찾고, Gemini 앱에서는 생각 과정을 얼마나 오래 펼쳐 둘지, 사용자가 언제 접거나 열어 보는지를 실험했습니다. Josh Woodward에 따르면 초기 사용자는 자세한 생각 과정을 꼼꼼히 들여다보지만, 신뢰가 쌓이면 요약을 더 원하게 됩니다. Google은 개발자용 API에도 생각 과정을 간결하게 정리해 주는 전용 요약 기능을 넣고 있습니다.
정리: Gemini 4 Argon으로 지금 해 볼 일
Gemini 4 Argon은 이제 일반 사용자와 개발자 모두 쓸 수 있습니다. Google이 내세우는 변화는 한 번에 100만 token을 출력하는 긴 추론, AI slop을 줄인 글쓰기, 그리고 다음 모델 개발에까지 넓어진 쓰임새입니다. 직원 10만 명 시험과 정부 안전성 평가를 거친 출시 과정은 새 모델을 공개하는 기준이 갈수록 높아지고 있다는 뜻으로 읽힙니다.
- 써 볼 곳 고르기: 일반 사용자는 Gemini 앱, 개발자는 Google AI Studio와 Gemini API에서 시작합니다.
- 글 다듬기: 생각을 음성 메모로 남긴 뒤 가장 약한 논거 세 가지와 놓친 관점을 짚어 달라고 요청합니다. 글투가 뻔하면 목록 남발과 채움말을 피하라고 지시합니다.
- 어려운 문제 맡기기: 수학 증명이나 깊은 연구 과제는 reasoning effort를 high로 두어 긴 추론을 허용합니다.
- 결과 검증하기: 놀라운 결과일수록 다른 모델에 비평을 맡기고, prompt를 고쳐 다시 묻고, 최종 판단은 직접 내립니다.
- 의견 보내기: 모델이 확인 질문을 던질 때와 스스로 가정하고 진행할 때에 대한 의견을 보냅니다. Google은 다음 버전의 균형을 맞추는 데 이런 의견이 필요하다고 말합니다.