Anthropic의 주 코드 저장소에 하루 병합되는 변경은 2026년 5월 평균 2,500건에서 9월 3만 건 이상으로 늘었습니다. 9월 9일 하루에만 30,401건이 병합됐습니다. Claude가 연구 실험을 스스로 반복하고 백엔드 서비스를 처음부터 만들 만큼 많은 코드를 쓰게 된 결과입니다. 그러자 사람의 속도에 맞춰 만든 개발 인프라, 곧 Git 기반 소스 관리와 CI(코드를 올릴 때마다 자동으로 빌드하고 시험하는 체계)가 회사의 가장 큰 병목이 됐습니다. Anthropic은 10월 13일, 7명으로 꾸린 팀이 5개월 만에 새 버전 관리 시스템 Scion과 코드 검토 도구 Antique를 만들어 주 저장소를 Git에서 옮겼다고 밝혔습니다. AI 코딩 agent(스스로 코드를 쓰고 고치는 AI)를 늘리는 개발 조직이라면 머지않아 비슷한 벽을 만날 수 있습니다.
Git이 agent 작업량을 버티지 못한 이유
Git은 코드를 사람이 쓰고, 쓰는 데 비용이 많이 들어 꼼꼼히 검토해야 한다는 전제 위에 만들어졌습니다. 구조도 분산형이라 clone(저장소를 통째로 복제한 사본) 하나하나가 전체 이력을 갖고, 변경 비교도 각자의 컴퓨터에서 하며, 오프라인에서도 일할 수 있습니다. 오픈소스나 사람 규모의 개발에는 맞지만, 기계가 쉬지 않고 코드를 만들고 시험하는 거대한 monorepo(여러 프로젝트의 코드를 한 저장소에 모은 방식)에서는 한계가 드러났습니다.
| 항목 | 규모 |
|---|---|
| main branch의 이력 | 100GB 이상 |
| 압축한 작업 사본 하나 | 25GB 이상 |
| CI의 하루 checkout 횟수 | 약 2,500만 회 |
| Git으로 그대로 받을 때 하루 트래픽 | 600PB 이상 |
checkout은 작업할 코드를 저장소에서 꺼내 오는 일이며, 이 횟수에는 개발자 환경, agent의 격리 환경, 연구 작업이 빠져 있습니다. Anthropic은 shallow clone, sparse checkout, blobless clone처럼 이력이나 파일 일부만 받는 기법을 쓰고 내부 Git 미러 서버를 수백 대까지 늘렸지만, 병합이 빨라질수록 구성이 불안정해졌습니다. 미러의 기준 스냅숏이 앞서가는 main branch(모든 변경이 모이는 기본 줄기)를 따라잡지 못했고, 일부만 받은 사본에서 diff(두 버전의 차이)나 blame(줄마다 마지막으로 바꾼 기록을 찾는 기능)을 계산하는 비용도 커졌습니다.
더 근본적인 문제는 사용자가 바뀌었다는 점입니다. 기존 버전 관리는 연결이 자주 끊기고 오프라인에서도 일하는 환경을 전제로 하지만, Anthropic 소스 관리의 주된 사용자인 agent, CI 봇, 연산 작업은 늘 온라인입니다. Git을 분산 개발에 강하게 만든 성질이 오히려 확장을 막은 셈입니다. Anthropic은 이 전제에서 버전 관리를 다시 설계했고, Google의 Piper와 Meta의 Sapling 같은 대규모 소스 관리 시스템을 참고했습니다. Meta도 거대한 monorepo를 감당하려고 Mercurial을 고쳐 쓴 적이 있습니다.
▲ 전체 사본 복제의 부담
서버가 계산하고 클라이언트는 가볍게
Scion은 여러 면에서 Git과 반대 방향을 택했습니다.
| 구분 | Git | Scion |
|---|---|---|
| 클라이언트 | 모든 clone이 전체 이력 보관 | 필요한 객체만 제한된 캐시에 보관 |
| 이력·diff·blame 조회 | 전체 이력을 받아 로컬에서 계산 | 서버가 계산해 API로 응답 |
| commit | 로컬에서 만든 뒤 서버로 올림 | 서버에서 바로 만들고 병합도 서버가 처리 |
소스 관리 기능이 원격 API로 열려 있어 CI 작업과 자동화 도구는 저장소를 내려받지 않고 commit(저장소에 남긴 변경 기록) 관계와 파일 이력을 조회합니다. 문제를 일으킨 변경을 찾아 되돌리는 자동화도 API로 바로 원인을 가려냅니다. commit은 가볍고 잠금 없이 처리돼 수백 개의 agent가 동시에 commit해도 차례를 기다리지 않고, 비용은 저장소 크기가 아니라 변경의 크기에 비례합니다. 여러 서버가 합의해야 하는 전역 branch 참조는 main과 정식 배포용 branch로만 제한했습니다.
작업 사본은 선택 사항이고 기본값도 필요한 부분만 받는 방식입니다. 가상 checkout을 쓰면 파일이 있는 것처럼 보이다가 프로세스가 실제로 읽을 때만 내용을 받아, 읽은 만큼만 네트워크와 디스크를 씁니다. 차이만 필요한 CI 작업은 API로 메타데이터만 요청하고, 쓰기 작업은 checkout 없이 API로 변경을 제출할 수 있습니다.
바뀐 파일만 기록하는 changeset
Scion의 기본 단위는 changeset입니다. 변경을 순서대로 먼저 적어 두는 write-ahead log의 한 항목으로, 첫 번째 부모와 비교해 바뀐 파일 목록만 담습니다. 파일 내용은 내용의 해시값을 주소로 삼아 Google Cloud Storage에, 작성자·시각·메시지·부모 같은 메타데이터는 Google Cloud Spanner에 둡니다. 데이터는 덧붙이기만 하고 변경분 대신 파일 전체를 저장하므로, Git의 packfile(객체를 압축해 묶은 파일)도, 서버 사이의 잠금이나 조율도 필요 없습니다.
메타데이터에는 author와 committer를 따로 적어, 작업을 요청한 사람이나 시스템과 실제로 변경을 실행해 commit한 agent를 구분합니다. blame, 경로별 이력, commit 그래프 탐색용 skip list 같은 파생 데이터는 부모 changeset의 값에서 재귀적으로 계산해 서버에 둡니다. 클라이언트는 내부 구조를 몰라도 되고, 새 인덱스를 더할 때도 클라이언트 코드를 고치지 않습니다.
3단 캐시
클라이언트는 이력 전체를 협상하는 대신 빠진 tree(디렉터리 구조) 노드를 위에서부터 차례로 요청한 뒤 필요한 파일만 받습니다. 작은 요청으로 나뉘어 끊겨도 이어 받을 수 있고 캐시하기도 쉽습니다. 캐시는 세 층입니다.
- scion-daemon: 개발자 컴퓨터와 CI 노드마다 돌며 그 기기의 모든 프로세스에 객체를 나눠 주는 프로그램
- scion-cache: 요청받은 객체를 메모리에서 바로 보내는 지역 캐시
- scion-server: 캐시에 없는 요청을 받아 Spanner와 Google Cloud Storage에서 가져오는 원본 서버
세 층은 같은 RPC(다른 컴퓨터의 기능을 함수처럼 호출하는 방식) 프로토콜을 쓰지만 층 사이 규칙을 엄격히 지켜, 지역 캐시가 멈춰도 원본 서버로 요청이 몰리지 않게 합니다. 데이터가 commit 뒤에는 바뀌지 않으므로 어느 서버나 캐시든 서로 맞춰 보지 않고 바로 응답할 수 있습니다. Scion은 처음에 메타데이터 서비스로만 쓰였고, 전용 클라이언트와 전송 프로토콜은 그 뒤에 만들었습니다.
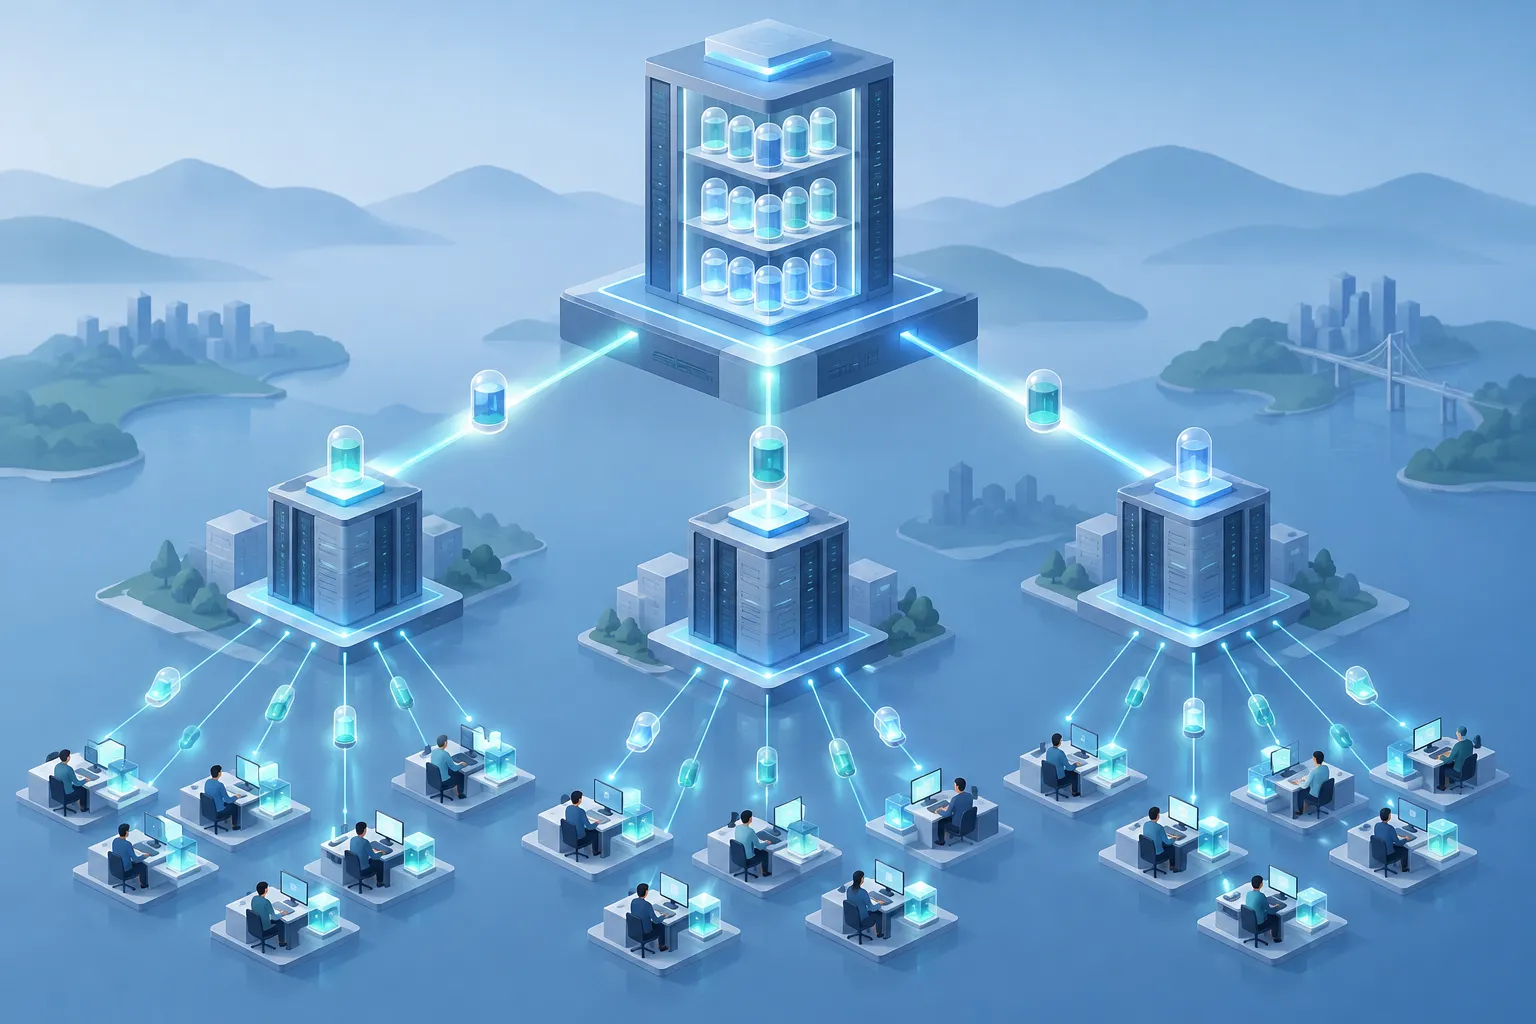
▲ Scion의 3단 캐시 구조
숫자로 본 효과
캐시 적중률은 99%를 넘고, CPU와 메모리 기준 인프라 규모는 이전 Git 미러 구성의 200분의 1로 줄었습니다. CI에서만 CPU 용량의 25%가 풀렸고 checkout은 몇 분에서 몇 초로 짧아졌습니다.
| 작업 | Git | Scion | 차이 |
|---|---|---|---|
| 최신 코드 받기 | 87초 | 3.5초 | 25배 |
| checkout | 15초 | 1.1초 | 14배 |
| 작업 사본 상태 확인 | 3.9초 | 19ms | 207배 |
| diff | 407ms | 67ms | 6.1배 |
| agent용 worktree 만들기 | 7.1분 | 5.1초 | 84배 |
앞의 세 작업은 개발자 환경에서 잰 값이고, worktree는 한 저장소에서 작업 공간을 여러 개 따로 여는 기능입니다. 이렇게 줄인 시간은 하루 agent 시간 1,000시간 이상, 연산 작업과 CI 전체의 기계 시간 약 17만 5,000시간에 이릅니다.
7명, 5개월을 가능하게 한 것
7명의 팀은 5개월 동안 Scion과 Antique를 만들고 관련 내부 시스템 여섯 개 안팎을 옮겼습니다. 같은 기간 하루 병합되는 코드 양은 10배로 늘었습니다. 내부 코드 검색, 권한 관리, 검토를 마친 변경을 자동으로 반영하는 도구도 만들었고, 디렉터리마다 접근 권한을 걸어 민감한 하위 폴더를 보호합니다. 큰 조직이 여러 해를 들이던 이전 작업을 agent 도구가 몇 달로 줄인 셈입니다.
- 사람이 짠 초기 시제품, 곧 Git 이력을 Scion으로 옮기는 수집 프로그램을 Claude Mythos Preview가 사람의 지시 없이 다시 써, 숨은 순서 조건을 모두 지키면서 메모리는 20분의 1만 쓰고 4배 빨라졌습니다.
- Claude가 격리된 시뮬레이션 시험과 fuzzer(무작위 입력으로 버그를 찾는 도구), 요청량 제한 장치를 만들어 Scion은 Anthropic에서 가장 철저하게 시험된 코드 가운데 하나가 됐습니다.
- 조상 commit을 찾는 질의가 데이터베이스 인덱스를 타지 못하던 문제도 Claude가 찾아 해결했습니다. 보통은 성능 전문가가 며칠에서 몇 주를 들여야 하는 일입니다.
Anthropic에서 엔지니어의 일은 코드 한 줄 한 줄을 읽는 데서 시스템 사이의 제약과 득실을 따지는 설계로 옮겨 갔습니다. 특히 agent가 설계 원칙을 깨는 해법을 내놓을 때 ’아니오’라고 말해야 합니다. 이전 작업 중 여러 Claude agent가 Antique에 물으면 될 PR(코드 변경 검토 요청)의 commit 이력을 Git 로그를 처음부터 훑어 복원하려 한 일이 있었고, agent끼리 공격적으로 검토하게 하자 가상의 지적에 대비한 방어 코드와 과도한 검증이 불어났습니다. 그래서 사람의 검토는 문법보다 의도와 설계의 타당성을 봅니다. Antique도 겉모양만 바뀐 변경은 건너뛰고 의미 있는 논리 변경에 집중하게 돕습니다.
운영에서는 전용 Slack 채널마다 Claude agent를 두고 scion-daemon, scion-cache, Antique의 병합 대기열 같은 구성 요소의 상태를 늘 지켜보게 합니다. Anthropic은 이들을 각 구성 요소의 ’열성 팬(superfan)’이라 부르며, 단순한 지표 경보가 놓치는 미묘한 이상을 로그와 차트에서 잘 찾는다고 봅니다.
병합 앞 관문보다 병합 뒤 복구
개발 관행도 바뀌었습니다. 대표적인 예가 merge queue(병합할 변경을 줄 세워 차례로 시험하는 대기열)입니다. 저장소 전체를 잠그고 CI 결과를 기다리는 방식은 수천 개의 agent 변경이 몰리면 풀 수 없는 병목이 됩니다. Anthropic은 이를 버리고 동시에 들어오는 변경을 받아들인 뒤 병합 후와 배포 전에 자동으로 검증하며, 충돌은 Claude가 빠르게 해결하게 했습니다.
이는 병합 버튼의 위험을 미리 낮춰 두는 접근과 맞닿아 있는 것으로 보입니다. 사람이 보기 전에 자동 검증으로 안전을 확인하고, 일부 사용자에게 먼저 배포하는 canary 방식과 즉시 되돌리는 rollback으로 피해 범위를 좁히는 것입니다. 병합 앞 절차를 아무리 쌓아도 고장 난 코드를 다 막기는 어려운 만큼, 빨리 복구하는 도구에 투자하는 편이 agent 시대에 더 현실적인 선택으로 보입니다.
Scion을 공개하지 않는 이유
Anthropic은 Scion이 Git을 대신할 범용 도구가 아니라고 선을 긋습니다. 수천 명의 엔지니어와 대규모 agent가 함께 쓰는 거대한 monorepo에 맞춘 시스템이어서, 공개하면 쓰는 쪽이 코드 검토, 검색, 빌드·배포 자동화 전반에서 Git을 버려야 합니다. 내부 token(AI 모델이 글을 처리하는 단위) 사용량도 일반 기업이 인프라 도구에 쓸 수준을 크게 넘는다고 밝혔습니다. 대신 표준 Git 클라이언트가 GitHub, GitLab과 함께 쓸 수 있는 서버 RPC 프로토콜을 표준으로 만들어 Git 서버 구조를 현대화하자고 제안합니다. Anthropic은 AI로 코드를 대량으로 만드는 팀이라면 결국 같은 한계를 만나며, 6~12개월 안에 업계에서 흔한 문제가 될 것으로 내다봤습니다.
지금 점검할 것
agent가 코드를 쓰는 속도가 검토와 도구의 속도를 앞지르면 병목은 코드 작성에서 소스 관리와 CI로 옮겨 갑니다. Scion은 이를 서버 중심 구조, 잠금 없는 commit, 필요한 만큼만 받는 전송, 병합 뒤 검증으로 풀었습니다. 같은 시스템을 당장 만들 필요는 없지만 다음은 확인해 볼 만합니다.
- CI의 Git clone과 checkout 시간을 잽니다. 한 소규모 스타트업은 약 46만 5,000번의 checkout에 runner(CI 작업을 실행하는 기계) 시간 1,000시간 가까이, 누적 42일을 Git 준비에만 썼고 그 대기에 $350~600을 냈습니다.
- 차이나 메타데이터만 필요한 CI 작업에는 전체 clone 대신 sparse checkout처럼 실제로 읽는 파일만 받게 합니다.
- commit에 작업을 요청한 사람과 실행한 agent를 구분해 남깁니다.
- 병합 앞 관문을 늘리기보다 병합 뒤 자동 시험, 단계적 배포, 빠른 되돌리기에 투자합니다.
- agent끼리 검토하게 할 때는 가상의 위험에 대비한 과도한 방어 코드를 만들지 말라고 지시하고, 사람은 의도와 설계를 봅니다.
다만 표준 도구가 실제로 규모를 감당하지 못하기 전부터 자체 도구로 바꿀 필요는 없습니다. 추론 비용이 빠르게 내려가고 있어 1년 안에는 일반 소프트웨어 회사도 적은 비용으로 자기 조직에 맞춘 소스 관리 계층을 만들 수 있을 것으로 보입니다. 우선 우리 팀의 병목이 어디로 옮겨 가고 있는지부터 재 두는 것이 출발점입니다.