9種類のコーディングおよびデータ処理タスクで82回の密閉テストを行った統制されたベンチマークで、Claude Codeで広く共有されている「チーム」構成、すなわちClaude Fable 5.2が作業を指揮し、Claude Opus 5.5がコードを書き、Claude Sonnet 5.5がテストし、Claude Haiku 5.5がコードベースを調査する編成は、Opus 5.5の単独セッションと同じ品質しか出せず、コストは3.5~4.5倍、所要時間は最大6倍になることが分かりました。9タスクのうちチームが有利だったのは、互いに関係のない8つのコードライブラリを作る1件だけで、それでも短縮した時間の代償としてほぼ2倍の費用がかかっています。
チーム構成が広まった理由
Fable 5.2の公開直後、Xには、Claude Codeのユーザーは1つのモデルに頼るのをやめ、階層型のチームを組むべきだという投稿が相次ぎました。最も高性能なモデルを計画担当のリーダーに、Opus 5.5をビルダーに、Sonnet 5.5やHaiku 5.5をテスターや調査役に据える構成です。高価なモデルはアーキテクチャの推論だけにトークンを使い、機械的な作業やテストスイートは安価なサブエージェントに任せる、という触れ込みでした。出力品質の向上と大幅なトークン節約を同時に実現できる、というのがその主張です。
机上では、この分業は理にかなっているように見えます。今回のベンチマークは、請求書が届いた時点でもそれが成り立つのかを確かめるために行われました。
比較の方法
すべての実行は、可能な限り隔離され、ブラインドになるよう設計されました。
- 各実行は、空のClaude設定、ランダム化したディレクトリ名、gitの履歴なしという状態の新しいDockerサンドボックス(使い捨ての隔離コンテナ)から開始しました。
- すべての構成に同一のSPEC.md仕様ファイルと同じプロンプト文を渡し、Node 26、Python 3、Playwright Chromium(画面を表示せずスクリプトで操作できるブラウザー)がインストールされた環境で自律的に作業するよう指示しました。
- 機能面は、モデルが一度も目にしていない非公開の検証スイートで確認しました。ヘッドレスブラウザーのスクリプトや、ゲームを自動でプレイするボットが含まれます。
- 品質は、Opus 5.5とSonnet 5.5という2つの独立したAI審査員がブラインドで採点しました。どのモデルやチームが作ったかを知らされないまま、各成果物の5つの観点を1~10点で評価しています。
- Fable 5.2には、新しいエージェント構成を自ら考案して評価する自律的な「ラボループ」も与え、上位の構成を上回るものが見つかるかを試しました。
ラウンド1:ブラウザーゲームと2つの小さな修正
最初の課題は、3種類の敵、ウェーブごとの難度上昇、アップグレードショップ、ローカルストレージに保存されるハイスコアを備えた、見下ろし型のアリーナサバイバルゲームを丸ごと作ることでした。デフォルトの中エフォート設定(エフォートは、モデルが1回の応答にどれだけ推論を費やすかを制御する設定です)で単独動作するOpus 5.5と、4エージェントのチームを、それぞれ3回ずつ実行して比較しました。
| 構成 | 品質(10点満点) | 1回あたりコスト | 1回あたり所要時間 |
|---|---|---|---|
| Opus 5.5単独、中エフォート | 7.2 | $1.64 | 10分 |
| 話題の4エージェントチーム | 7.1 | $5.75 | 61分 |
チームの実行のうち1回は88分を過ぎても終わらず、手動で停止せざるを得ませんでした。未完成のゲームは非公開チェックのうち6件に失敗しています。
続く2つの課題は既存のコードベースに対する作業で、ポーズメニューとボス戦の追加、そして曖昧に記述された6件のバグの修正です。ここではSonnet 5.5の単独動作を比較対象としました。
| 課題 | Sonnet 5.5単独 | 話題のチーム |
|---|---|---|
| ポーズメニューとボス戦の追加 | 6分、$0.77 | 31分、$4.06 |
| 報告された6件のバグ修正 | 1分、$0.18 | 52分、$2.61 |
既存コードベースへの小さな作業は、調整のオーバーヘッドによる影響を最も強く受けるようです。
ラウンド2:より大きな5つの仕事
最初のラウンドは課題が小さすぎてチームの強みが出なかったという反論に答えるため、第2ラウンドでは規模の大きい5つのプロジェクトを使いました。REST API、画面、テスト、ドキュメントを備えたフルスタックのヘルプデスクチケット管理アプリ。独立した8つのJavaScriptユーティリティライブラリ(csv、cron、diff、expr、semver、lru、template、glob)。自転車店向けの9ページのECサイト。複利をテーマにした、コード生成によるアニメーション解説動画。そして、雑然としたCSVエクスポートを解析して経営層向けレポートにまとめる、整理されていないデータレポート作成の仕事です。Fable 5.2をアーキテクトとし、4つのOpus 5.5ビルダーが同時に作業する第2のチーム設計も比較対象に加えました。
5つの仕事を通じて、すべてのモデルとすべてのチームが25件の非公開機能チェックに全て合格しました。品質は同等に並びましたが、コストと時間はそうではありませんでした。
| 構成 | 平均品質 | 5件の合計コスト | 合計時間 |
|---|---|---|---|
| Opus 5.5単独 | 8.0 | $10.57 | 45分 |
| 話題の4エージェントチーム | 8.0 | $47.14 | 176分 |
最も差が際立ったのは解説動画です。Opus 5.5単独は11分、$1.81で制作し、スコアは7.8でした。チームは78分と$21.73を費やし、スコアは7.6にとどまりました。
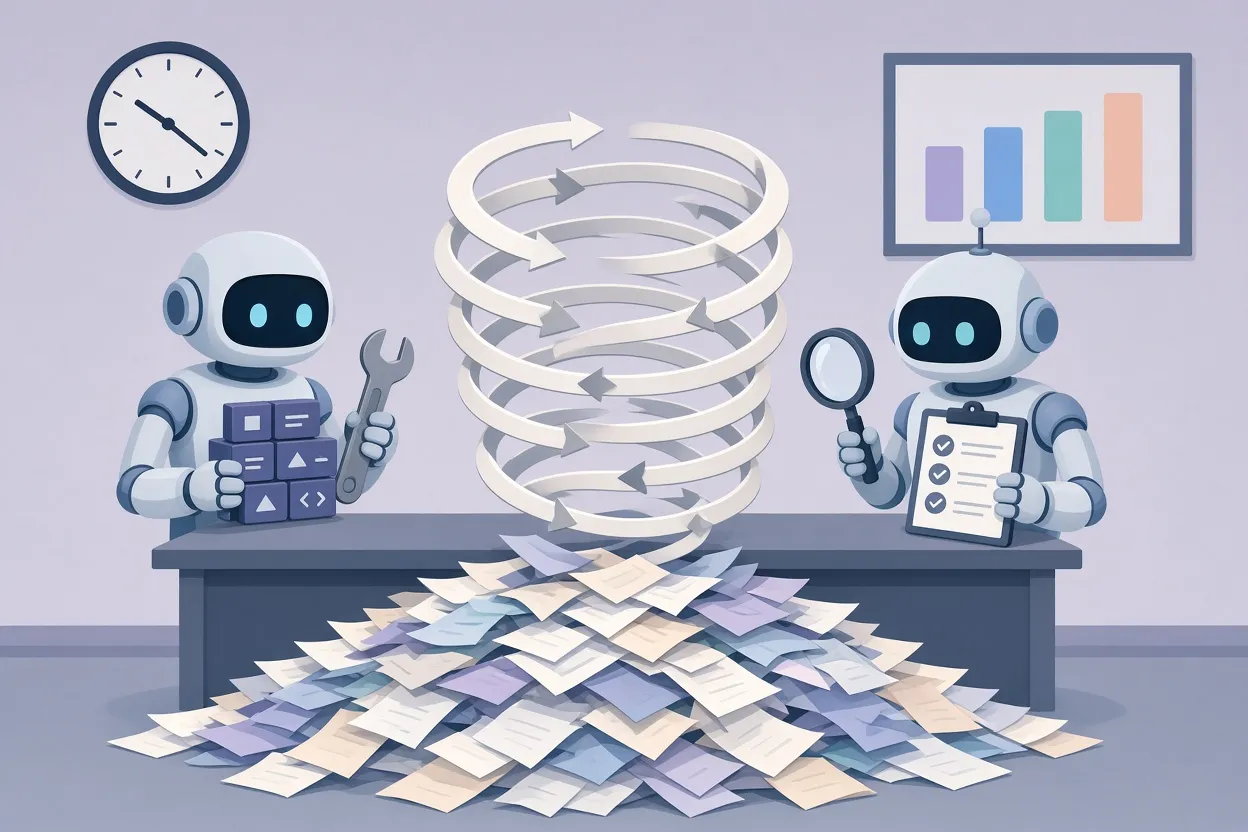
▲ コストだけ増えるビルダーとテスターの往復
コストはどこへ消えたのか
エージェントごとのトークン集計から浮かび上がった主犯は1つ、OpusビルダーとSonnetテスターの間の往復ループでした。テスターは些細な問題を指摘し続け、ビルダーはそれに応じて大きなコードブロックを何度も生成し直し、このサイクルが数十周繰り返されても、非公開チェックの結果も品質スコアも動きませんでした。
このループがほとんど価値を生まない理由もデータから読み取れます。現在のモデルは、生成しながら自分の成果物を既に確認しています。さまざまなエフォート設定で行った21回の単独実行では、テスターエージェントなしで19回がゲームの67件の非公開チェックに全て合格しました。専任のテスターは、ビルダーがいずれ自分で気づいたはずのことを再発見するためにお金を払っているに等しいのです。
結果にはもう1つの構造的な限界も見えます。話題の構成ではFable 5.2は監督役に専念し、一度もコードを書かなかったため、最終的な品質はOpusビルダーが単独で出せる水準を超えられません。このように組織されたチームは、ビルダーの上限をそのまま受け継いだうえに、コーディネーターのコストを上乗せすることになります。
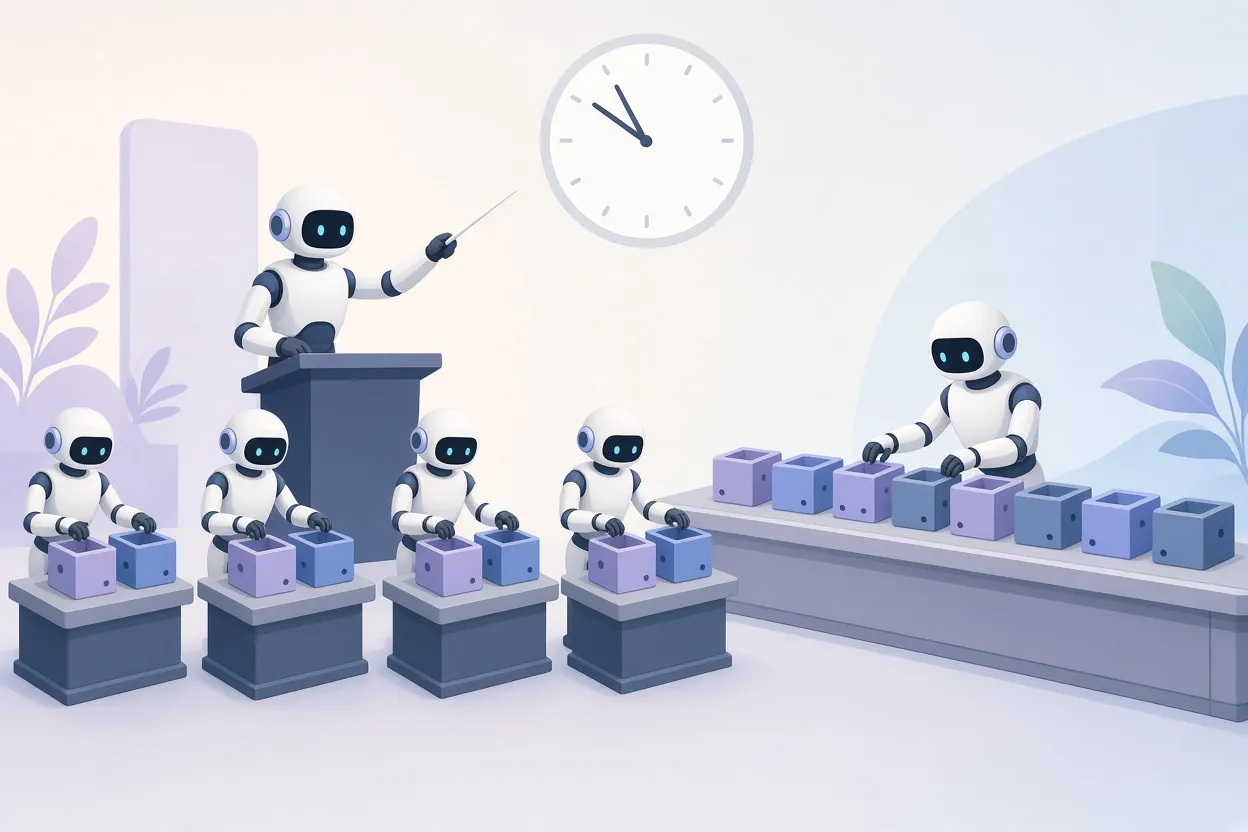
▲ 独立モジュールの並列ビルダー
チームが勝った唯一の課題
8ライブラリの仕事が例外でした。モジュール同士に依存関係がなかったため、Fable 5.2はそれらを2つずつの組に分け、同時に動く4つのOpus 5.5ビルダーにそれぞれ2つを割り当てました。
| 構成 | 時間 | コスト | 品質 |
|---|---|---|---|
| 並列チーム、Opusビルダー4基 | 6分 | $4.01 | 8.5 |
| Opus 5.5単独 | 9分 | $2.27 | 8.6 |
短縮できたのは3分で、コストは約77%増、品質の向上はありませんでした。同じ並列チームがフルスタックアプリをバックエンド、UI画面、テスト、ドキュメントに分割して取り組むと、この優位は消えました。Fableが計画に約3分、各部分の結合にさらに3分を費やしたため、チームは18分と$8.30を要し、アプリを一体として構築した単独Opusの12分と$3.87に負けています。並列化が効くのは、部品同士が本当に接触しない場合だけです。
Fable自身が描いたドリームチーム
本番のベンチマークの前に、Fable 5.2には品質とトークン効率の面で理想的なチームを設計するよう求めました。Fableが選んだのは5モデル構成で、自身をリーダー、Sonnet 5.5をビルダー、Opus 5.5をレビュアー、Sonnet 5.5をテスター、Haiku 5.5を調査役とするものでした。
ところが実際には、Fableは自分の計画を無視しました。すべての実行で、Fableは実装コードを全て自分で書き、テスターと調査役は一度も呼ばず、Opusレビュアーを呼び出したのは最後の1回だけでした。このレビューは約$1.00のコストを加えましたが、ゲームのスコアは改善せず、Fable単独の7.3に対して7.0でした。実行後に自ら書いた分析ファイルの中で、Fableは当初のチーム仮説が誤っていたと結論づけています。
際立ったコストパフォーマンスと最難問
このベンチマークでは、どの単一モデルがどの仕事に向くかについてもいくつかの知見が得られました。
- 高エフォートのSonnet 5.5は、今回の調査で最もコストパフォーマンスが高い選択でした。データレポート作成の課題では12問中12問に正答し、費用は$0.68でした。機能追加($0.77)とバグ修正($0.18)も速く安く処理しており、既存コードの編集には自然な選択肢です。
- 費用を抑える目的でOpus 5.5を低エフォートに下げるのは逆効果でした。ゲームのスコアが1.6点下がったのに対し、節約できたのは$1.05にすぎません。
- 最も要求の厳しいアルゴリズム課題、すなわち衝突と摩擦を扱う2D剛体物理エンジンでは、Fable 5.2単独が$10.21で8.2点と最高スコアを記録し、$9.51で7.9点のOpus 5.5をわずかに上回りました。
- 予算が限られた中での難しいエンジニアリングには、Opus 5.5がリード、Sonnet 5.5がビルダー、Haiku 5.5がテスターを務める「予算チーム」が、物理エンジンで$3.00で7.4点に達しました。Opus単独のコストの3分の1未満です。
ベンチマークが対象にしなかったこと
この結果には限界もあります。品質の判定は全てAIモデルが行ったため、見た目の仕上がり、UIの手触り、ありきたりに見える出力は人間には一度も採点されていません。第2ラウンドでは、トークン費用の都合で5つの仕事を各構成につき3回ではなく1回ずつ実行しました。ただし傾向は第1ラウンドと一致しています。また、どの課題も単独モデルなら1時間以内に完了するものでした。複数のコンテキストウィンドウにまたがる数日規模やエンタープライズ規模の作業は試しておらず、そうした領域ではチーム構成がまだ元を取れる可能性があります。
構成の選び方
通常のソフトウェア開発では、計測の結果が示す答えは、有能なモデル1つの方がチームより速く、安く、品質も劣らないというものです。数字から導かれる単純な判断手順は次の通りです。
- 新規のビルド、Webサイト、コード駆動のモーショングラフィックスは、中エフォートのOpus 5.5から始め、低エフォートには落とさない。
- 小さな修正、バグ修正、データ分析には、高エフォートのSonnet 5.5に切り替える。
- 最難関の数学、物理、アルゴリズム問題にはFable 5.2単独を取っておき、そうした作業を安く済ませる必要があるときはOpus・Sonnet・Haikuの予算チームを使う。
- 並列ビルダーは、仕事が厳密に独立したモジュールで構成され、数分早く終わることがトークン請求額のほぼ倍増に見合う場合に限って使う。
- 自動化ワークフローでは専任のテスターサブエージェントを避ける。モデルは既に自己チェックしており、このループは品質を上げずにトークンを消費しがちです。
より広い教訓は、効率的に聞こえるワークフローを採用する前に計測することです。チーム構成は論理的に魅力的で広く支持されていましたが、それでも狭い1つのケースを除くすべての軸で負けました。


