Claude Code에서 Claude Fable 5.2가 계획을 세우고, Opus 5.5가 코드를 짜고, Sonnet 5.5가 테스트하고, Haiku 5.5가 코드베이스를 탐색하는 네 agent(자율적으로 작업을 수행하는 AI 실행 단위) 팀 구성이 X에서 크게 화제가 됐습니다. 역할을 나누면 결과물이 더 좋아지고 token(모델이 처리하는 텍스트 단위)도 크게 아낄 수 있다는 주장이었습니다. 그런데 이 구성을 아홉 가지 코딩·데이터 작업, 82회의 격리된 실행으로 단일 모델과 직접 비교한 결과는 정반대였습니다. 품질은 사실상 같았고, 팀 구성은 비용이 최대 4.5배, 시간은 거의 4배 더 들었습니다. 팀이 단일 모델을 이긴 과제는 아홉 개 가운데 하나뿐이었습니다.
화제가 된 팀 구성과 비교 방법
Fable 5.2가 공개된 직후 X에서는 단일 모델 대신 팀을 꾸려야 한다는 글이 잇따라 공유됐습니다. Fable 5.2를 계획을 세우는 lead로, Opus 5.5를 builder(구현 담당)로, Sonnet 5.5와 Haiku 5.5를 tester(검증 담당)와 scout(코드베이스 탐색 담당)로 두라는 내용입니다. 비싼 모델은 설계 판단만 하고 저렴한 모델이 기계적인 구현과 테스트를 맡는다는 논리여서 이론적으로는 그럴듯해 보입니다.
이 주장을 검증한 방법은 다음과 같습니다.
- 모든 실행은 깨끗한 Docker sandbox(격리된 실행 환경) 컨테이너에서 진행했습니다. Claude 설정은 비어 있고, 디렉터리 이름은 무작위이며, git 기록도 남기지 않았습니다.
- 모든 구성에 같은 사양 파일(SPEC.md)과 같은 prompt(모델에 주는 지시문)를 주고, Node 26, Python 3, Playwright Chromium이 설치된 환경에서 자율적으로 작업하게 했습니다.
- 기능 검증은 모델이 보지 못한 외부 검증 suite로 했습니다. headless browser(화면 없이 동작하는 브라우저) 스크립트와 게임을 자동으로 플레이하는 bot이 포함됩니다.
- 품질 채점은 Opus 5.5와 Sonnet 5.5 두 AI 심사자가 어떤 구성이 만든 결과인지 모르는 상태에서 다섯 항목을 1~10점으로 매겼습니다.
- 비교 대상은 화제의 4-agent 팀, 단일 모델들, 그리고 Fable 5.2가 직접 설계한 대안 팀 구성들이었습니다.
1라운드: 게임 제작, 기능 추가, 버그 수정
첫 과제는 위에서 내려다보는 시점의 arena survival 브라우저 게임을 빈 디렉터리에서 처음부터 만드는 일이었습니다. 추격형, 탱크형, 사격형 세 종류의 적, wave가 진행될수록 난도가 오르는 구조, 업그레이드 상점, local storage에 저장되는 최고 점수를 요구했습니다. 각 구성을 3회씩 실행한 평균은 다음과 같습니다.
| 구성 | 품질(10점 만점) | 1회 비용 | 소요 시간 |
|---|---|---|---|
| Opus 5.5 단독(medium effort) | 7.2 | $1.64 | 10분 |
| 화제의 4-agent 팀 | 7.1 | $5.75 | 61분 |
품질은 거의 같은데 팀은 비용이 3.5배, 시간은 6배 들었습니다. 팀 실행 가운데 하나는 88분이 지나도 끝나지 않아 수동으로 중단했고, 미완성 게임은 숨겨진 검증 항목 6개를 통과하지 못했습니다.
이어서 기존 코드를 수정하는 작은 작업도 비교했습니다. 하나는 일시정지 메뉴와 boss 전투를 추가하는 기능 작업, 다른 하나는 모호하게 적힌 버그 보고 6건을 해결하는 작업입니다.
| 작업 | Sonnet 5.5 단독 | 4-agent 팀 |
|---|---|---|
| 기능 추가 | 6분, $0.77 | 31분, $4.06 |
| 버그 6건 수정 | 1분, $0.18 | 52분, $2.61 |
코드베이스가 작은 작업일수록 팀 구성의 조율 비용이 결과에 비해 지나치게 크다는 점이 드러납니다.
2라운드: 과제를 키워도 결과는 같았습니다
1라운드 과제가 너무 작아서 팀 협업의 이점이 드러나지 않았다는 반론이 나올 수 있습니다. 그래서 2라운드에서는 규모가 큰 과제 다섯 가지를 준비했습니다.
- backend REST API, 화면, 테스트, 문서를 모두 갖춘 full-stack help-desk 티켓 앱
- 서로 의존하지 않는 JavaScript 유틸리티 라이브러리 8개(csv, cron, diff, expr, semver, lru, template, glob)
- 자전거 매장의 9페이지 홍보·상품 카탈로그 웹사이트
- 복리 원리를 시각화하는 코드 생성 애니메이션 MP4 영상
- 고객, 주문, 티켓 CSV 여러 개를 정리해 분석하고 경영진용 Markdown 보고서를 만드는 데이터 작업
여기에 Fable 5.2가 설계한 병렬 팀(Fable 5.2가 architect, Opus 5.5 builder 네 개가 동시에 작업)도 추가했습니다.
결과를 보면, 모든 모델과 팀 구성이 숨겨진 검증 25개를 전부 통과했습니다. 단일 모델도 전담 tester 없이 기능 면에서 100% 유효한 결과물을 냈다는 뜻입니다. 품질 점수는 Opus 5.5 단독과 4-agent 팀이 모두 평균 8.0으로 동점이었습니다.
| 구성 | 5개 과제 평균 품질 | 5개 과제 합산 비용 | 합산 시간 |
|---|---|---|---|
| Opus 5.5 단독 | 8.0 | $10.57 | 45분 |
| 화제의 4-agent 팀 | 8.0 | $47.14 | 176분 |
가장 극단적인 차이는 애니메이션 설명 영상 과제에서 나왔습니다. Opus 5.5 단독은 11분, $1.81에 7.8점을 받았지만, 팀은 78분, $21.73을 쓰고도 7.6점에 그쳤습니다. builder와 tester가 같은 작업을 반복한 결과입니다.
비용이 불어난 진짜 이유: builder와 tester의 반복 고리
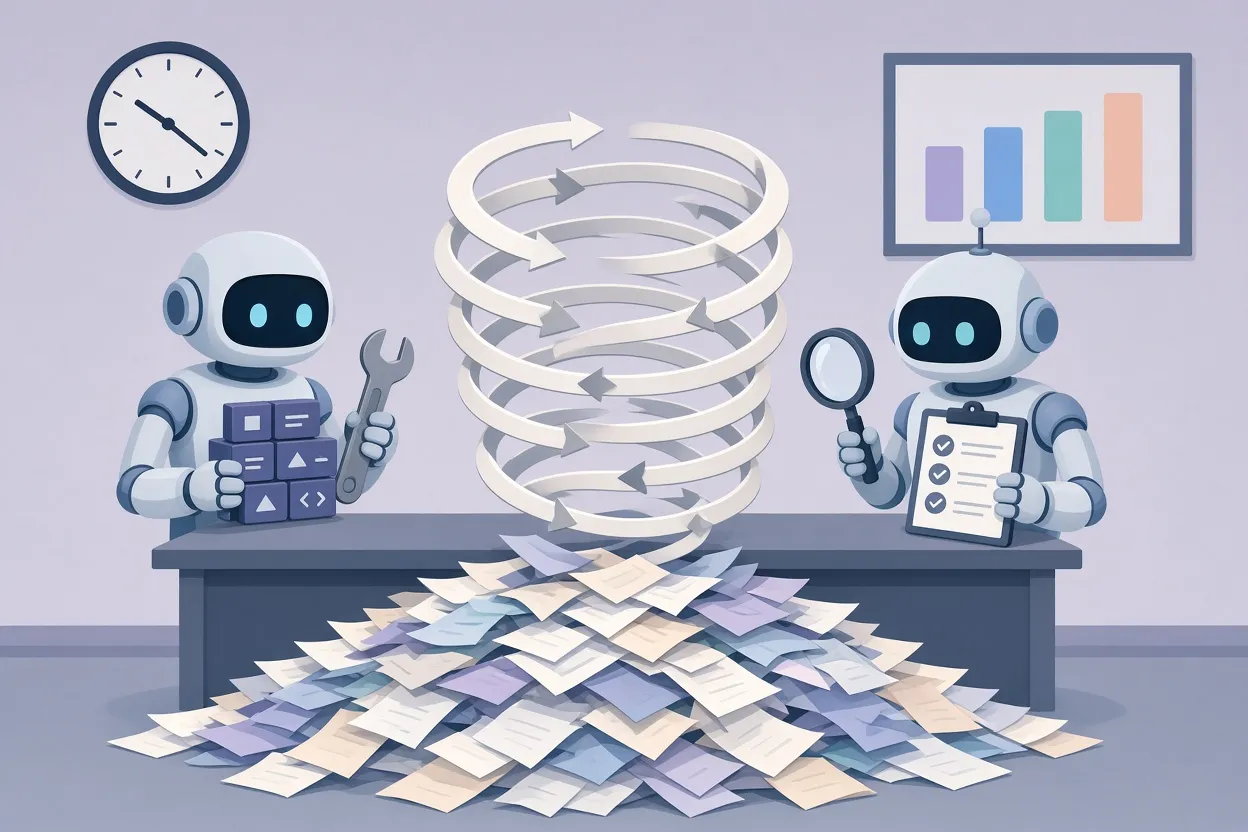
▲ builder와 tester의 반복 고리
agent별 token 사용량을 분석하면 비용이 부풀어 오른 핵심 원인이 드러납니다. Opus builder와 Sonnet tester 사이의 재귀적인 고리입니다. tester가 사소한 문제를 반복해서 보고하고, builder는 그때마다 큰 코드 블록을 다시 생성하는 과정이 수십 바퀴 이어졌지만 점수는 의미 있게 오르지 않았습니다.
이런 현상은 최신 모델이 이미 생성 과정에서 자체 점검을 수행하기 때문으로 보입니다. 실제로 단일 모델 21회 실행 가운데 19회가 별도 tester 없이도 게임 검증 항목 67개를 모두 통과했습니다. 별도의 tester agent를 두는 일이 대체로 중복이고, 비용만 키우는 셈입니다.
또 하나 짚을 점은 품질의 상한입니다. 이 구성에서 Fable 5.2는 코드를 직접 쓰지 않는 감독자 역할만 했기 때문에, 결과물의 품질은 결국 builder 모델 하나의 능력에 묶입니다. 팀 구성이 builder 모델 단독보다 높은 품질을 낼 구조적 이유가 없다는 해석이 가능합니다.
팀이 이긴 유일한 과제: 독립 모듈의 병렬 처리
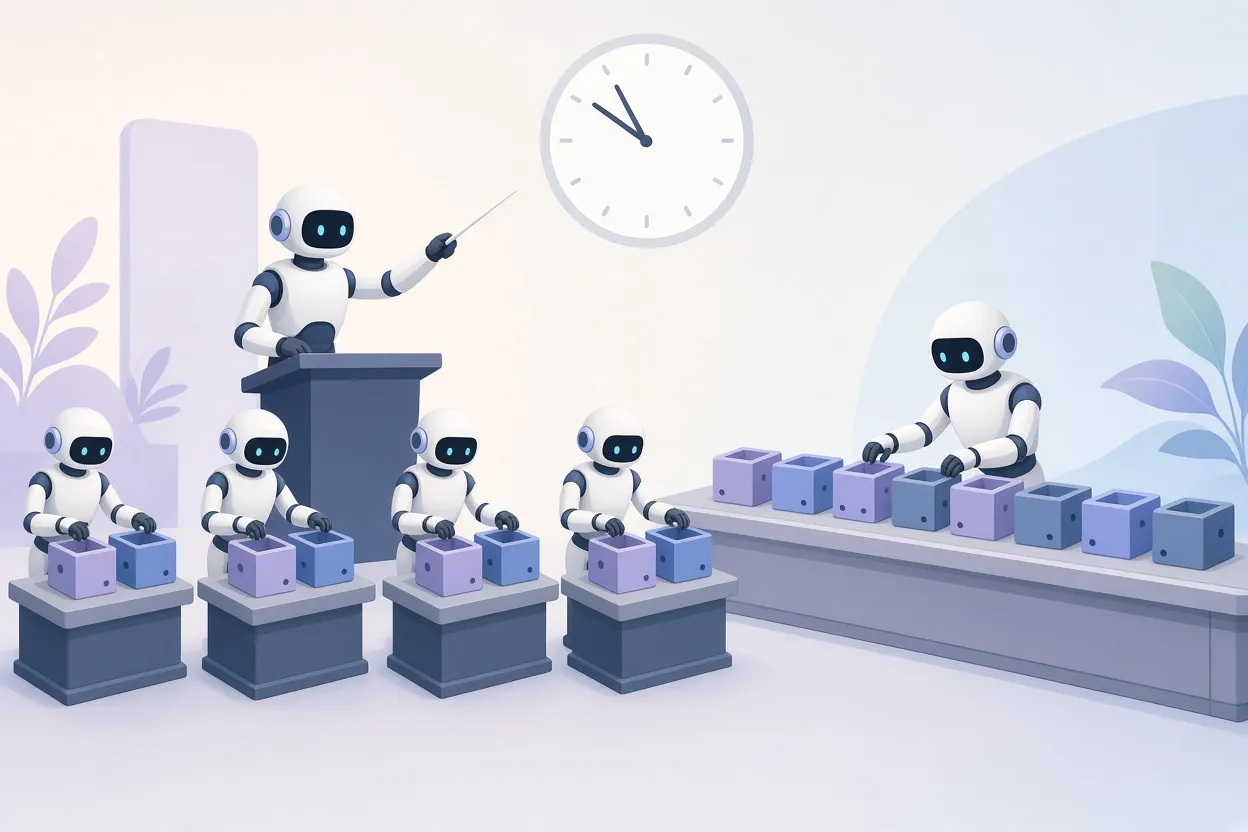
▲ 독립 모듈의 병렬 처리
benchmark(성능 비교 시험) 전체에서 팀이 단일 모델을 이긴 과제는 JavaScript 라이브러리 8개를 만드는 작업 하나였습니다. 모듈 사이에 의존성이 전혀 없어서 Fable 5.2가 라이브러리를 두 개씩 네 Opus 5.5 builder에 나눠 동시에 진행할 수 있었습니다. 병렬 팀은 6분, Opus 5.5 단독은 9분이 걸렸고 품질은 8.5 대 8.6으로 같았습니다. 다만 비용은 $4.01 대 $2.27로 거의 두 배였습니다.
같은 병렬 팀이 full-stack 앱을 맡았을 때는 시간조차 줄이지 못했습니다. backend, UI 화면, 테스트, 문서로 작업을 나눴지만 Fable 5.2가 전체 계획을 쓰는 데 3분, 네 builder가 병렬 작업하는 데 12분, 다시 모듈을 이어 붙이는 데 3분이 들어 총 18분, $8.30이 소요됐습니다. Opus 5.5 단독은 한 번에 통합된 앱을 12분, $3.87에 완성했습니다. 모듈을 서로 맞춰야 하는 작업에서는 조율과 통합 비용이 병렬 처리의 이점을 상쇄한다는 점이 확인됩니다.
Fable 5.2가 스스로 설계한 팀의 결말
benchmark를 시작하기 전, Fable 5.2에게 품질과 token 효율을 최대로 끌어올릴 이상적인 팀을 직접 설계하도록 했습니다. Fable 5.2는 자신을 lead로, Sonnet 5.5를 builder, Opus 5.5를 reviewer, Sonnet 5.5를 tester, Haiku 5.5를 scout로 두는 5모델 팀을 제안했습니다.
그런데 실제 실행에서는 모든 회차에서 자신이 지정한 builder를 건너뛰고 구현 코드를 100% 직접 작성했습니다. tester와 scout는 한 번도 호출하지 않았고, 작업이 끝날 때 Opus 5.5 reviewer를 한 번 불러 검토를 받았습니다. 이 검토는 약 $1.00의 비용을 더했지만 게임 점수는 7.0으로, Fable 5.2 단독의 7.3보다 오히려 낮았습니다. 실험 뒤 작성한 분석 문서에서 Fable 5.2는 자신의 원래 팀 설계 가설이 틀렸다고 인정했습니다.
이 결과를 읽을 때 유의할 점
이 비교에는 몇 가지 한계가 있습니다.
- 품질 채점은 전적으로 AI 심사자가 맡았습니다. 시각적인 완성도나 UI의 느낌처럼 사람이 직접 봐야 할 요소는 평가되지 않았습니다.
- 2라운드는 token 비용 때문에 구성당 1회만 실행했습니다. 다만 결과 양상은 3회 평균을 낸 1라운드와 일치했습니다.
- 모든 과제는 단일 Opus 5.5가 1시간 안에 끝낼 수 있는 규모였습니다. 여러 날, 여러 세션에 걸치는 대규모 작업은 검증하지 않았으며, 작업이 하나의 context window(모델이 한 번에 다룰 수 있는 입력 범위)를 넘어서는 경우에는 팀 구성이 여전히 유효할 수 있습니다.
작업 유형별 추천 구성과 독자가 할 일
실측 결과를 바탕으로 작업 유형별 구성을 정리하면 다음과 같습니다. effort는 모델이 추론에 들이는 노력 수준을 정하는 설정입니다.
| 작업 유형 | 추천 구성 | 근거 수치 |
|---|---|---|
| 새 앱, 웹사이트, 코드 기반 모션 그래픽 | Opus 5.5 단독, medium effort | 게임 7.2점에 $1.64, 2라운드 평균 8.0점에 합산 $10.57 |
| 기존 코드 수정, 국소 기능 추가, 버그 수정 | Sonnet 5.5 단독, high effort | 기능 추가 $0.77, 버그 6건 수정 $0.18 |
| 데이터 정리와 분석 보고서 | Sonnet 5.5 단독, high effort | 12문항 전부 정답, $0.68 |
| 2D 물리 엔진 같은 최고 난도 알고리즘 | Fable 5.2 단독 | 8.2점에 $10.21(Opus 5.5는 7.9점에 $9.51) |
| 고난도 작업을 적은 예산으로 | budget 팀(Opus 5.5 lead, Sonnet 5.5 builder, Haiku 5.5 tester) | 물리 엔진 7.4점에 $3.00 |
| 서로 독립된 모듈을 빠르게 | 병렬 Opus 5.5 builder 팀 | 6분 대 9분, 비용은 약 2배 |
한 가지 주의할 점은 비용을 아끼려고 Opus 5.5의 effort를 low로 내리는 선택입니다. 게임 과제에서 점수가 1.6점 떨어진 반면 절약한 금액은 $1.05에 그쳤습니다. 비용을 줄이려면 effort를 낮추는 대신 작업 성격에 맞는 모델로 바꾸는 쪽이 낫습니다.
Claude Code를 쓰는 독자라면 다음 세 단계로 판단하면 됩니다. 첫째, 새 프로젝트는 Opus 5.5 medium effort 단독으로 시작합니다. 둘째, 작은 수정, 버그 수정, 데이터 작업은 Sonnet 5.5 high effort로 바꿉니다. 셋째, 수학적·알고리즘적으로 가장 어려운 과제에만 Fable 5.2 단독을 씁니다. 병렬 팀은 모듈이 서로 완전히 독립적이고 token 비용보다 완료 속도가 중요할 때만 고려하고, builder와 tester를 오가는 자동 반복 고리는 피하는 편이 좋습니다. 이 결과는 1시간 안에 끝나는 작업 범위에서 얻은 것이므로, 여러 날에 걸치는 대규모 작업에 그대로 적용할지는 각자 작업에서 비용과 시간을 재어 보고 판단하는 편이 안전합니다.


