Databricks、Googleマップ、Ford、Uber、Instacartのエンジニアリングリーダーが、Android Dev Summitのパネルディスカッションに集まり、エージェント型コーディング、つまり人間が逐一指示しなくてもAIエージェントにコードを書かせ、実行させ、修正させる手法について知見を持ち寄りました。共通する結論は、コードの生産量は爆発的に増えた一方で、機能をユーザーに届けるまでの時間はそれほど縮んでいない、というものです。ソフトウェア提供で時間がかかる部分は、もともとタイピングではなかったからです。大企業が成果をどう測り、パイプラインのどこが詰まり、ツールのコストにどう上限を設け始めているのか、その具体的な姿が浮かび上がりました。
生産量は増えたが、成果の証明は難しい
DatabricksでAIツール群を統括するエンジニアリングマネージャーによると、同社はこの6か月で、以前のはるかに長い期間よりも多くのコードを投入しました。プルリクエスト数とコード行数があまりに急増したため、ストレージとリポジトリ管理そのものがスケーリング上の課題になっています。しかしこの量の多さが、経営層に生の数字を祝うのではなく成果指標を探すことを迫りました。AIが生成したコードの量をビジネス価値に結びつける標準的な方法は、業界にまだありません。
同じリーダーは、突出した開発者と中央値のエンジニアの間に5倍から10倍の生産性の差が根強く存在すると述べました。Databricksは、最速の人をさらに速くするのではなく、中央値の層にAI施策の照準を合わせ、組織全体の底上げを図る道を選んでいます。
Uberのモバイル開発者プラットフォームを担当するプリンシパルエンジニアは、最も印象的な数字を挙げました。レガシーの制約がない新規コードを扱うグリーンフィールドのプロジェクトでは、現行ツールに習熟した開発者1人が1日に最大100件のプルリクエストを生み出せるというのです。一方、ミスが重要なインフラを壊しかねないブラウンフィールドのプラットフォーム開発では、依然として人間の慎重な判断が欠かせません。Uberはこの1年、コーディングの高速化が顧客向け機能の提供を実際に速めるのかを調べてきました。初期の指標は前向きですが、結論はまだ出ていません。
消火ホース問題
Instacartのプリンシパルエンジニアは、多段階のパイプラインのうち1つの段階だけが突然何倍も速くなると何が起きるかを説明しました。下流のすべてを飲み込む消火ホースのような状態になるのです。従来のモデルでは、人間のエンジニアが変更を1つずつ順番に本番環境まで導いていました。今はエージェントが、人間のペースを前提に設計されたパイプラインに変更を流し込んでいます。
Googleマップのエンジニアリングマネージャーは、提供プロセスをコーディング、本番準備(プライバシーや法務のレビューなど)、リリースの3段階に分けて整理しました。この見方では、第1段階だけを速めるのは、高速道路を飛ばしても次の渋滞箇所に早く着くだけのようなものです。サーバー側のサービスは継続的にリリースできますが、コンシューマー向けアプリでは、変更が全ユーザーに届く前に実験、テレメトリの検証、段階的ロールアウトが必要になります。
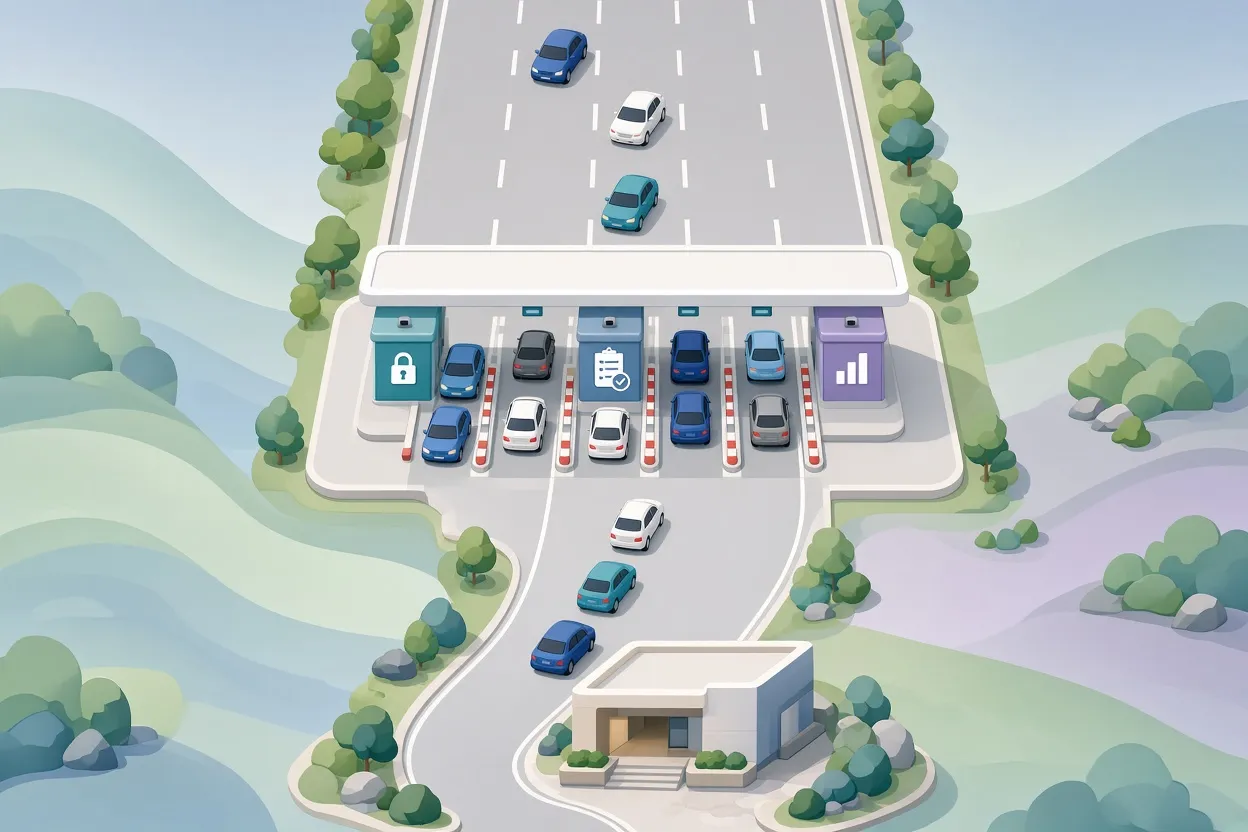
▲ コーディング・準備・リリースの3段階
Uberのエンジニアは、「裁量」という有用な視点を加えました。アイデアからリリースまでのライフサイクル全体を自分たちで握る社内ツールチームは、AIによって劇的に速くリリースできます。一方、社外向け製品を作るチームは、デザインの引き継ぎ、プロダクトレビュー、アプリストアのロールアウト日程を経なければならず、コーディングの高速化のうち最後まで残る分には上限があります。
車両サブスクリプションと顧客ロイヤルティのプラットフォームを率いるFordのエンジニアリング担当シニアディレクターは、議論全体の前提を問い直す指摘をしました。AI以前から、エンジニアリングがボトルネックになることはめったになかったというのです。上流の要件定義と部門横断の議論がスケジュールの大半を占め、プロダクトとデザインが固まれば、実装は既知の解決策を適用するだけで済むことが多かったといいます。Fordが大きな速度向上を見ているのは、Spring Bootのバージョンアップのようなコンプライアンス対応や保守作業です。本当に新しい機能を構想してから届けるまでの期間は、ほとんど変わっていません。
効果が集中する領域
| 作業の種類 | AIエージェントで観察された効果 |
|---|---|
| グリーンフィールドのプロジェクトと社内ツール | 最大の加速。Uberでは開発者1人あたり1日最大100件のPRという例 |
| フレームワークと依存関係のアップグレード | 大きな効果。FordはSpring Bootのアップグレードを挙げる |
| レガシーなプラットフォームコード | 限定的。依然として人間の判断が必要 |
| コンシューマー向けの新機能 | ほぼ変化なし。仕様、レビュー、ストアのロールアウトに制約される |
コードレビューを検証問題として考え直す
最も遅い段階が組織全体の速度の上限を決め、多くの企業ではその段階が人間によるコードレビューです。そこで中心的な問いは、プルリクエストの100%をレビューすることにまだ意味があるのか、になります。
Databricksのリーダーは、レビューを本質的には再設計可能な検証問題として捉えました。レビューには、正しさを確認することと、何が変わるのかをチームに知らせることの2つの目的があります。あるパネリストは、現在のレビューのおよそ70%が本格的な設計の精査ではなく、表面的な「問題なさそう」の承認だと見積もりました。すべてのレビューがアーキテクチャのパターンを確認しているふりをするのではなく、定型的な承認で済む特徴をエージェントに学習させ、そうしたケースを委ねることができます。示された見通しは、最終的にプルリクエストの「かなり高い2桁パーセント」が人間による完全なレビューなしで取り込まれるようになる、というものでした。ただし、すべてがそうなることは決してありません。
Instacartのエンジニアは、リスク階層別のレビューを提案しました。強力なテストですでにカバーされている自動リファクタリングや機械的な変更は必須のピアレビューを省略し、重要なアーキテクチャ上の経路ではレビューを維持する、という考え方です。ただし、バグが$数百万の損失を招きCEOの注目を集めかねない場面では、人間による検査が引き続き不可欠だと釘を刺しました。やや冗談めかした例がその幅を物語っています。UberアプリのAndroidモジュールをリファクタリングするのは中程度のリスクですが、すべてのAndroid開発者に無料乗車を与えてしまうバグにはCEOレベルの承認が必要だ、というものです。
関連するアイデアもいくつか出ました。
- レビューの軸を1行ごとの構文チェックから意図の検証へ移す。最先端モデルが単純な技術的ミスを減らすにつれ、リスクはビジネス要件やプロダクトの意図の読み違えへ移っていく。
- 差分を読む代わりに、視覚的な成果物、テスト出力、変更前後の表現を使い、レビュアーが構文ではなく振る舞いを判断できるようにする。
- レビューを「良い摩擦」として扱う。目的はレビュアーの負担を減らすことであり、安全装置を取り除くことではない。
- 上流に投資する。詳細な仕様と明示的なアーキテクチャのプロンプトは、生成コードの質を目に見えて高める。曖昧な入力からは、あるパネリストが「スロップ」と呼ぶものしか出てこない。入力の質を上げることが、下流のレビュー負荷を直接減らす。
モバイルがバックエンドより難しい理由
自動生成コードを安全に取り込むためのツールは、フィーチャーフラグ、ブルーグリーンデプロイ、インシデント追跡、分散トレーシングなど、すでに揃っています。ある登壇者によれば、欠けているのは、テレメトリとオブザーバビリティのデータが互いに切り離されたサイロに置かれている点です。これらを統合されたエンジニアリングコンテキストサービスにまとめることが、自信を持った自動マージを可能にする鍵になります。
モバイルには非対称な制約が加わります。バックエンドチームは社内のオブザーバビリティを使ってリアルタイムにホットフィックスやロールバックができます。モバイルの修正はPlayストアの審査を通過し、その後ユーザーがアップデートするのを待たなければなりません。この遅延があるため、モバイルではサーバーより慎重になることが正当化され、コンシューマーアプリのチームがバックエンドの同僚よりエージェント型コーディングの恩恵を小さくしか受けられない理由にもなっています。
インフラへの負荷とコストの精算
数千件の自動プルリクエストは、物理的に現実の影響を及ぼします。Uberのエンジニアによると、すべての変更をビルドしてテストする継続的インテグレーション(CI)システムは開発者プラットフォームの各チームで高負荷にさらされ、計算資源の急増による社内の「コードレッド」が頻発しています。対策には、Bazelのリモートビルド実行、分散キャッシュ、自己修復するCIパイプライン、テストの自動トリアージが含まれます。
あるパネリストは、障害で否応なく直面する前に、10倍の成長軌道を想定してインフラを点検するよう促しました。別の企業のCEOの言葉として、Googleが数十億行のコードを蓄積するのにおよそ20年から28年かかったが、AIによる加速で一般の企業も数年で同規模に達する、しかもそれを支えるGoogle規模の社内プラットフォームなしに、という話を紹介しました。
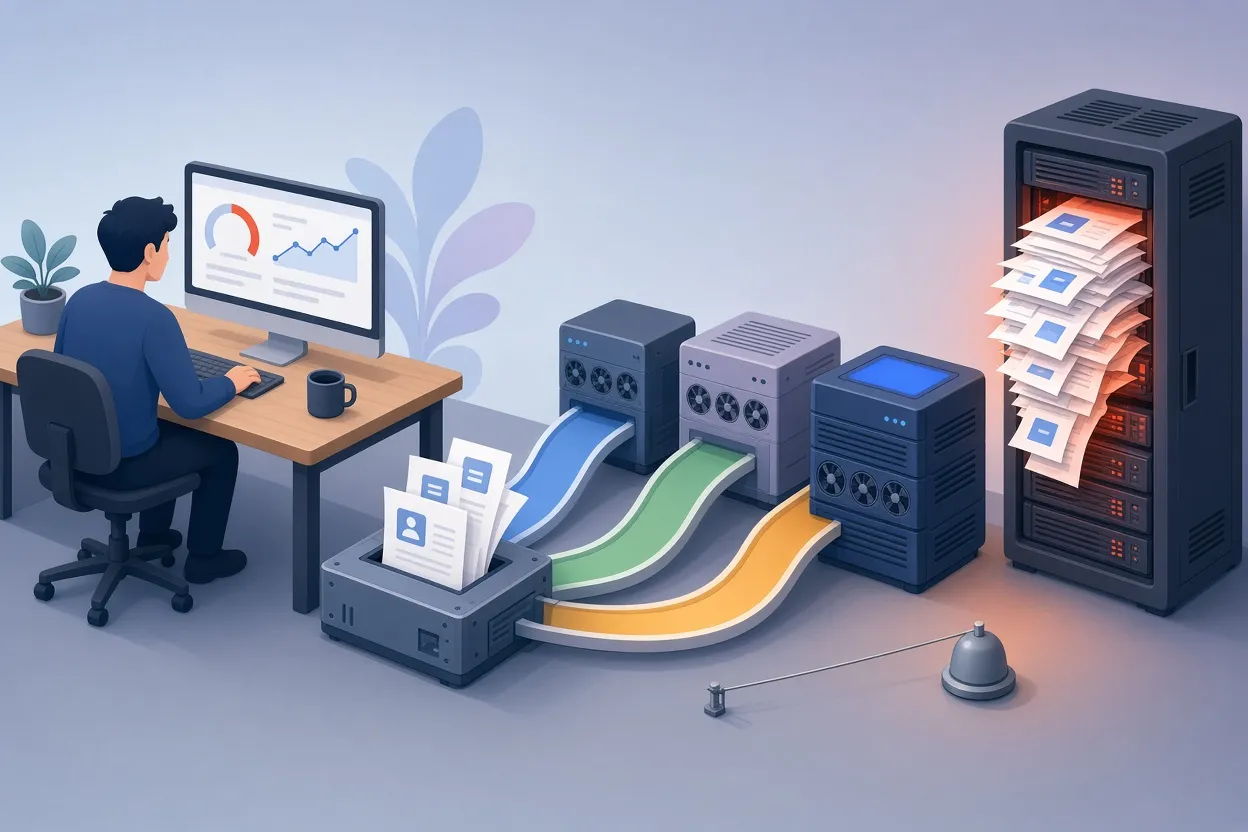
▲ モデルルーティングと支出のトリップワイヤー
コストの話は明確な筋道をたどりました。あるエンジニアリングリーダーは、昨年を実験の年と位置づけ、エンジニアには金銭的な制約なしにあらゆることでAIを試すよう奨励していたと振り返ります。今年前半には期待値が合理的な利用へと移り、9月には彼女の組織がトークン上限を正式に導入しました。健全なセッションの指標や、1回のやり取りあたりのターン数を追跡する計測基盤がそれを支えています。目的は教育です。AIへの問い合わせには実際にお金がかかるということを、エンジニアが体に染み込ませる必要があります。彼女はこれを初期のAWSになぞらえました。当時はエンジニアが不必要にECSインスタンスを立ち上げ、クラウド料金を膨らませていました。現代版は、コマンドを1つ打てば済むGitブランチの切り替えに、モデル呼び出しで$5を使うことです。
別のパネリストは、こうした上限はアーキテクチャにとって健全だと主張しました。初期にはエンジニアがコードベース全体を言語モデルに投げ込んで魔法を期待していましたが、請求書が見直しを促しました。彼は、標準的なUIコンポーネントやユニットテストのボイラープレートには、モデルのリアルタイム推論ではなく決定論的なジェネレーターを使うことを勧めています。Instacartのエンジニアも、そこでの上限の狙いは絞り込みではなく衛生管理だと同意しました。スクリプトが永久に無料でやってくれるシステム時刻の確認に、最先端モデルを使う必要は誰にもありません。
各社の支出ガバナンス
| 仕組み | 動き方 |
|---|---|
| コストの可視化 | チームは作業環境の中で進行中のセッションのコストとモデル使用量を確認できる |
| ワンクリック申請付きのトークン閾値 | 標準の上限に達した開発者は、直属のマネージャーに追加分の申請を送る |
| 日次トリップワイヤー | 夜間に暴走するテストやベンチマークのループを止めるソフトな上限。エンジニアは社内ポータルでワンクリックで自分で解除できる |
| 月次フロンティア予算 | 最先端モデル向けの余裕ある枠。それを超える分はマネージャーの例外承認 |
| モデルルーター | タスクの種類を適切なモデル階層にプログラムで対応づけ、エンジニアが手動でモデルを選ばなくて済むようにする |
設計原則として2点が際立ちました。第1に、上限はブロッカーではなくトリップワイヤーだということです。放置すれば一晩で$数千に膨らむ自動ループを捕まえつつ、人間を介在させ続けることが目的です。第2に、プラットフォームチームは意図的にゲートキーパーになることを避けています。予算の判断は、ビジネスの文脈を理解しているエンジニアリングマネージャーの手に残ります。パネリストらは、プロバイダー間の競争でトークン価格が下がっていると指摘しつつも、それでも開発者による自覚的な管理は必要だと考えており、個人から負担を取り除く長期的な方法として自動モデルルーティングに期待を寄せています。
ある登壇者は、トークン単位で支払う企業の現実と、定額サブスクリプションで売られるコンシューマー向けツールを対比し、定額モデルもいずれトークン単位の経済性と向き合わざるを得なくなると予測しました。Google自身の社内トークン予算について、Googleマップのマネージャーは注意書きだけを述べました。これほど大きな企業には無数の個別予算があり、単一の答えは当てはまらない、ということです。
AI対応のための時間を確保する
大規模な既存コードベースを抱えるチームが、AIに合わせた再設計のために3か月の休止期間を得られることはまずありません。助言は、AI対応を技術的負債と同じように扱うことでした。たとえば一般的な20%の技術的負債枠のうち5%を、プロンプトの改善とコンテキストの調整に継続的に割り当てるのです。多くのエンジニアはいまだにモデルを神秘的なブラックボックスとして扱い、プロンプトを設定することも十分なコンテキストを与えることもしていません。開発者がモデルを設定可能なエンジニアリングシステムとして扱えるようチームをスキルアップさせる仕事は、リーダーシップの責任だとパネルは主張しました。
トレーニングは一度きりのイベントではあり得ません。専用のトレーニング週間を1回設けただけでは、能力の進化が速すぎて1年以内に大きく取り残されます。チームは「飛びながら飛行機を組み立てている」状態で、モデルの進歩に合わせてガードレールを調整しています。大企業では、プラットフォームチームが蒸留フィルターの役割を果たし、めまぐるしい進展の流れを使える社内ガイドラインに変換しています。
ここから持ち帰るべきこと
5つの大規模エンジニアリング組織に共通するメッセージは、エージェント型コーディングは現実の測定可能な成果をもたらすが、それは主にライフサイクル全体が1つのチームの中に収まり、作業が機械的な領域、つまり社内ツール、グリーンフィールドのプロジェクト、フレームワークのアップグレード、コンプライアンス作業に集中している、というものです。ユーザー向け製品では、仕様の質、レビューの処理能力、リリースパイプライン、そしてモバイルではアプリストアでの配布が制約要因になります。
導入を検討するチームへの指針は次のとおりです。
- プルリクエスト数ではなく成果を測り、スター開発者ではなく中央値の開発者を対象にする。
- 裁量が大きくリスクが限定されるアップグレード、移行、社内ツールからエージェントを使い始める。
- 人間のゲートを緩める前に、強力なテスト、フィーチャーフラグ、統合されたオブザーバビリティに支えられたリスク階層別レビューと意図の検証へ移行する。
- 変更量が10倍に増えることを想定して、CIとビルドのインフラに負荷試験を行う。
- コストのテレメトリを開発者の目の前に置き、ハードなブロックではなくトリップワイヤーを設定し、予算の判断はマネージャーに委ね、反復的な作業には決定論的なスクリプトを使う。
- 専用のモダナイゼーション期間を待つのではなく、プロンプト、コンテキスト、継続的な学習のためにエンジニアリング時間の一定枠を恒常的に確保する。
これらはどれもツールの有用性を下げるものではありません。仕事の場所を移すだけです。コードを書くことから、コードをきちんと仕様化し、効率よく検証し、意識してコストを払うことへと。


