AI coding agent(스스로 도구를 호출하며 코드를 짜고 고치는 AI)를 도입한 개발 조직에서 pull request(PR, 코드 변경 요청)와 코드량은 분명히 급증했습니다. 그런데 사용자에게 실제로 전달되는 기능이 그만큼 빨라졌는지는 별개의 질문입니다. Android Dev Summit에 모인 Databricks, Google Maps, Ford, Uber, Instacart의 엔지니어링 리더들이 공유한 경험을 종합하면, 코딩 단계가 빨라진 만큼 병목은 코드 리뷰, 법무·개인정보 검수, 배포 파이프라인, CI 인프라, 그리고 token 비용으로 옮겨 가고 있습니다. 이 글은 그 경험을 팀 단위 도입을 고민하는 독자가 참고할 수 있도록 다시 정리합니다.
코드량은 늘었는데 성과 지표는 아직
Databricks의 한 엔지니어링 매니저에 따르면 PR 수와 코드 줄 수 같은 지표는 폭발적으로 늘어, 최근 6개월 동안 밀어 넣은 코드가 과거 훨씬 긴 기간보다 많았습니다. 코드 저장소 관리에 부담이 생길 정도여서, 경영진은 코드량이 아니라 실제 성과를 재는 지표를 찾아야 하는 과제를 안게 되었습니다. 다만 AI가 만든 코드량을 사업 성과와 연결하는 표준화된 지표가 업계에 아직 없다는 점도 함께 지적되었습니다.
같은 매니저가 짚은 또 하나의 숫자는 개발자 사이의 격차입니다. 최상위 개발자와 중앙값 개발자 사이에는 5~10배의 생산성 차이가 꾸준히 존재하는데, Databricks는 AI 도입의 초점을 최상위를 더 끌어올리는 데가 아니라 바닥과 중앙값을 높이는 데 둡니다.
Uber의 principal engineer는 최신 AI 도구에 능숙한 일부 개발자가 greenfield(기존 코드가 없는 새 프로젝트) 작업에서 하루 100개까지 PR을 만들어 낸다고 전합니다. 반면 오래된 brownfield(기존 코드 위에서 작업하는) 시스템, 특히 핵심 인프라에 가까운 platform 작업은 한 번의 실수가 큰 장애로 이어질 수 있어 사람의 신중한 판단이 여전히 필요합니다. Uber는 지난 1년간 코딩 가속이 실제 고객 기능 출시 속도로 이어지는지를 조사해 왔고, 초기 지표는 긍정적이라고 합니다.
병목은 사라지지 않고 옮겨 간다
Instacart의 엔지니어는 여러 단계로 이루어진 전달 파이프라인에서 한 단계만 빨라지면, 뒤 단계가 소방 호스처럼 쏟아지는 변경을 감당하지 못한다고 설명합니다. 이전에는 사람 엔지니어가 변경을 하나씩 순서대로 production까지 끌고 갔지만, 지금은 AI가 기존 파이프라인에 변경을 한꺼번에 흘려보내는 구조입니다. 배포가 늦어질까 봐 밤늦게 동료에게 급히 메시지를 보내 PR 리뷰와 merge를 부탁하는 장면이 그 단면입니다.
Google Maps의 엔지니어링 매니저는 소프트웨어 전달 과정을 세 단계로 나눕니다.
| 단계 | 하는 일 | AI로 빨라진 정도 |
|---|---|---|
| 코딩 | 코드 작성과 수정 | 크게 빨라짐 |
| production 준비 | 개인정보·법무 검토, 실험 평가, telemetry 검증 | 거의 그대로 |
| 출시 | 단계적 rollout, App Store 심사 | 거의 그대로 |
고속도로에서 빨리 달려 봐야 다음 정체 구간에 더 빨리 도착할 뿐이라는 비유가 여기서 나옵니다. 서버 쪽 서비스는 계속 배포할 수 있지만, 소비자 앱은 실험 평가와 telemetry 검증, 단계적 rollout을 거쳐야 합니다.
Uber 쪽에서는 '주도권(agency)'이라는 기준을 더합니다. 작성부터 배포까지 전 과정을 스스로 통제하는 내부 도구 팀은 극적으로 빨라진 반면, 소비자 앱 팀은 디자인 handoff, 제품 검토, App Store rollout 일정에 묶여 AI로 얻는 속도 이득이 제한됩니다.
Ford의 엔지니어링 디렉터는 더 근본적인 지적을 합니다. AI 이전에도 엔지니어링 구현이 주된 병목인 경우는 드물었고, 요구사항 정의와 부서 간 논쟁 같은 상류 단계가 지연의 대부분을 만들었다는 것입니다. 제품과 디자인 사양이 확정되고 나면 개발자가 Stack Overflow의 답을 응용해 구현을 마무리하는 경우가 많았습니다. 그래서 Ford에서는 Spring Boot 버전 업그레이드 같은 compliance와 시스템 유지보수 작업에서 AI로 큰 속도 향상을 얻고 있지만, 새 기능을 구상하는 일정은 거의 달라지지 않았습니다.
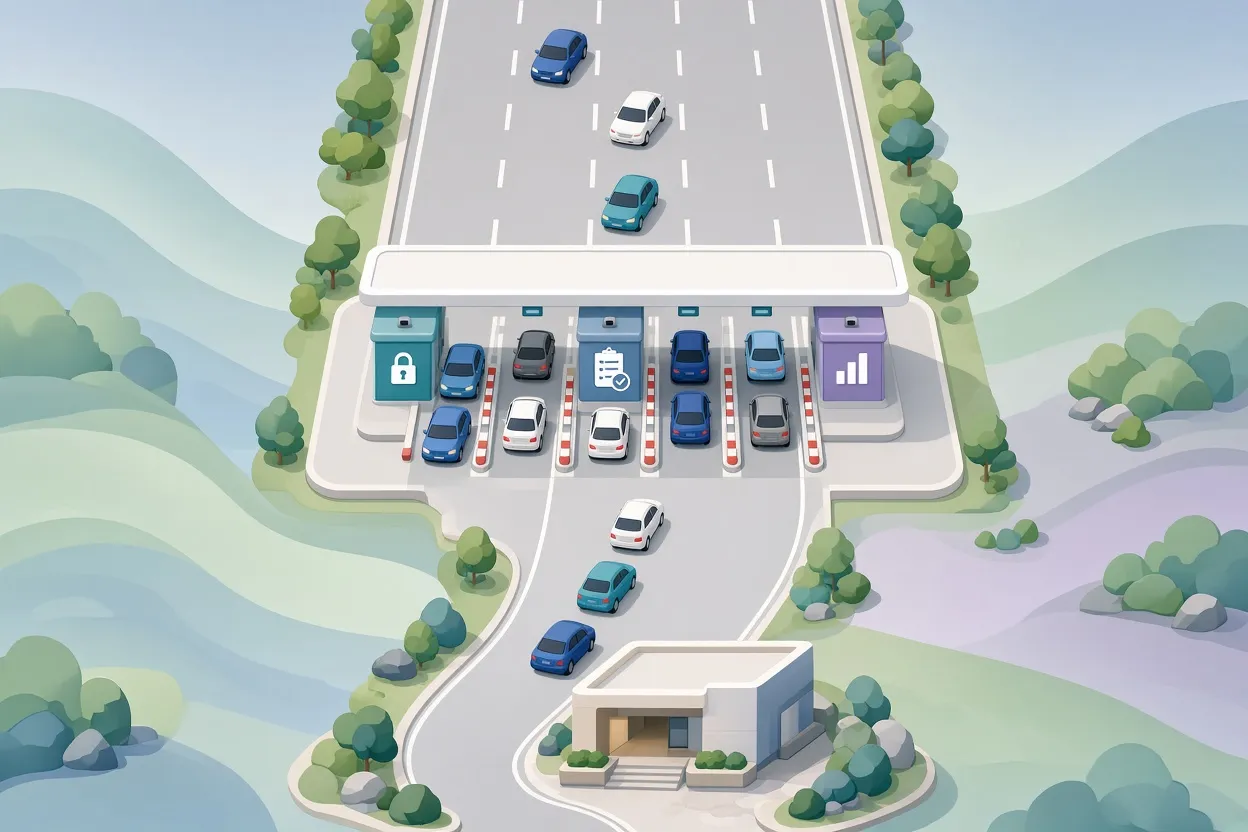
▲ 코딩, 준비, 출시의 세 단계
코드 리뷰를 '검증 문제'로 다시 보기
가장 많은 논점이 모인 곳은 코드 리뷰입니다. Instacart의 엔지니어는 강한 테스트가 이미 덮고 있는 자동 refactoring이나 기계적 작업에 대해 의무적인 동료 리뷰를 재고하자고 제안합니다. 다만 큰 매출이 걸린 금융 실패 모드가 있는 영역에서는 사람 검사를 완전히 생략할 수 없으므로, 핵심 architecture 경로와 저위험 변경을 구분하는 위험도별 리뷰가 현실적인 대안이라고 봅니다. Databricks의 매니저는 코드 리뷰를 본질적으로 검증 문제로 정의하면 체계적으로 다시 설계할 수 있다고 정리합니다.
리뷰의 목적은 크게 두 가지, 정확성 검증과 팀이 변경 내용과 설계 결정을 함께 알게 하는 교육입니다. 자동 검증을 충분히 신뢰할 수 있게 되면 일부 변경은 사람 리뷰 없이 바로 코드베이스와 release로 들어갈 수 있고, 전부는 아니어도 매우 높은 두 자릿수 비율의 PR이 그 대상이 될 것이라는 전망이 나왔습니다. 조직의 전달 속도는 가장 느린 단계에 묶이는데, 대부분의 조직에서 그 단계가 수동 코드 리뷰라는 점이 근거입니다.
현재 리뷰의 약 70%는 설계나 architecture를 깊이 보는 것이 아니라 'LGTM(Looks Good To Me)' 같은 형식적 승인이라는 추정도 나왔습니다. 모든 사람 리뷰가 command pattern 같은 구조를 꼼꼼히 확인하는 척하기보다, 어떤 코드 특성과 조직 패턴이 표준 승인에 해당하는지를 agent에게 학습시켜 그 부분을 맡기자는 제안입니다. 또 다른 제안은 리뷰를 한 줄씩 읽는 방식에서 시각적 산출물, 자동 테스트 결과, 변경 전후 비교 같은 multimodal 요약 중심으로 바꾸어, 사람은 전체 동작과 검증에 집중하게 하자는 것입니다.
좋은 마찰과 나쁜 마찰
개발 과정의 마찰이 모두 나쁜 것은 아닙니다. 품질을 지키는 생산적 마찰과 불필요한 지연을 만드는 해로운 마찰을 구분해야 하고, 코드 리뷰는 대체로 좋은 마찰에 속합니다. 따라서 목표는 안전장치를 없애는 것이 아니라 리뷰어의 부담을 줄이는 것입니다. 그 방법 가운데 하나가 상류의 명확성에 투자하는 것입니다. 상세한 사양과 명시적인 architecture prompt를 주면 AI가 만드는 코드 품질이 눈에 띄게 올라가고, 결과적으로 리뷰 부담이 줄어듭니다. 모호한 입력은 엉성한 코드를, 정밀한 입력은 production 수준의 코드를 낳는다는 '쓰레기를 넣으면 쓰레기가 나온다'는 원칙이 그대로 적용됩니다.
검증 대상은 문법에서 의도로
Uber 쪽은 코드가 사람의 한 줄 검사 없이 production에 도달하는 것이 일상이 되는 방향으로 업계가 가고 있다고 봅니다. frontier model이 좋아질수록 기술적 오류는 줄고, 위험은 사업 요구사항이나 제품 의도를 잘못 해석하는 쪽으로 옮겨 갑니다. 그래서 리뷰는 문법 검사가 아니라 사람의 의도와 설계 목표를 확인하는 일로 갈라져야 한다는 것입니다. 위험은 영역별로 나누어, 기반 코드와 보안 구성 요소, compliance 로직에는 높은 마찰을, 실험적 기능에는 최소한의 마찰을 둡니다. Uber 앱을 예로 들면 Android 모듈 refactoring은 중간 위험이지만, 모든 Android 개발자에게 무료 탑승을 주는 버그라면 CEO 결재가 필요한 수준이라는 농담 섞인 예가 이를 잘 보여 줍니다.
자동 merge를 안전하게 할 도구는 이미 있습니다. feature flag(기능을 코드 배포와 분리해 켜고 끄는 장치), blue-green 배포(두 환경을 번갈아 전환하는 배포), incident 추적이 그것입니다. 진짜 걸림돌은 telemetry와 행동 추적, observability 데이터가 서로 분리된 시스템에 흩어져 있다는 점이고, 이를 하나의 engineering context 서비스로 합쳐야 자신 있게 자동 merge할 수 있다는 진단입니다.
모바일에는 비대칭적인 제약이 하나 더 있습니다. 백엔드는 내부 observability로 즉시 hotfix하거나 되돌릴 수 있지만, 모바일 코드는 Google Play Store 심사와 사용자의 업데이트 속도를 거쳐야 합니다. 이 지연 때문에 모바일 배포는 서버보다 더 신중해야 합니다.
인프라와 학습: 날면서 비행기를 만든다
큰 brownfield 코드베이스를 AI에 맞게 현대화할 시간을 어떻게 확보할지가 문제인데, 사업 부서가 3개월짜리 재설계 중단을 승인하는 일은 거의 없다는 것이 현실입니다. 그래서 AI 준비 작업은 기술 부채처럼 반복적으로 다루어야 합니다. 구체적으로는 보통 20%로 잡는 기술 부채 시간 가운데 5%를 prompt 다듬기와 context 조정에 꾸준히 배정하자는 제안입니다. 많은 엔지니어가 여전히 생성 모델을 신비한 블랙박스로 여겨 prompt 구성이나 context 제공을 제대로 하지 않는데, 이를 가르치는 일은 리더십의 책임으로 지목되었습니다.
학습은 한 번으로 끝나지 않습니다. 교육 주간을 한 번 따로 잡는 방식으로는 1년 안에 크게 뒤처진다는 것이 Uber 쪽의 경험입니다. 모델 능력이 빨라지는 속도에 맞춰 guardrail과 도구를 동시에 고쳐 가는 '날면서 비행기를 만드는' 상태이고, 대기업에서는 platform 팀이 빠르게 바뀌는 AI 동향을 소화 가능한 지침으로 걸러 주는 증류 필터 역할을 합니다.
인프라 쪽 부담도 현실입니다. 수천 개의 자동 PR이 CI(지속 통합, 코드 변경마다 자동으로 빌드하고 테스트하는 체계)에 몰리면서 compute 사용량이 급증해 내부에서 'Code Red'가 자주 발령된다고 합니다. 대응으로 Bazel remote build execution, 분산 캐시, 스스로 복구하는 CI 파이프라인, 자동 테스트 triage에 투자가 몰리고 있습니다. 10배 성장을 가정하고 지금 인프라가 그 규모를 감당할 수 있는지 미리 점검하라는 조언도 있었습니다. 한 스타트업 CEO의 말을 빌리면, Google이 수십억 줄의 코드를 쌓는 데 약 20~28년이 걸렸지만 AI 가속으로 보통 회사들이 그 규모에 몇 년 만에 도달하게 될 텐데, 대부분은 Google 수준의 내부 개발 platform이 없다는 것이 문제입니다.
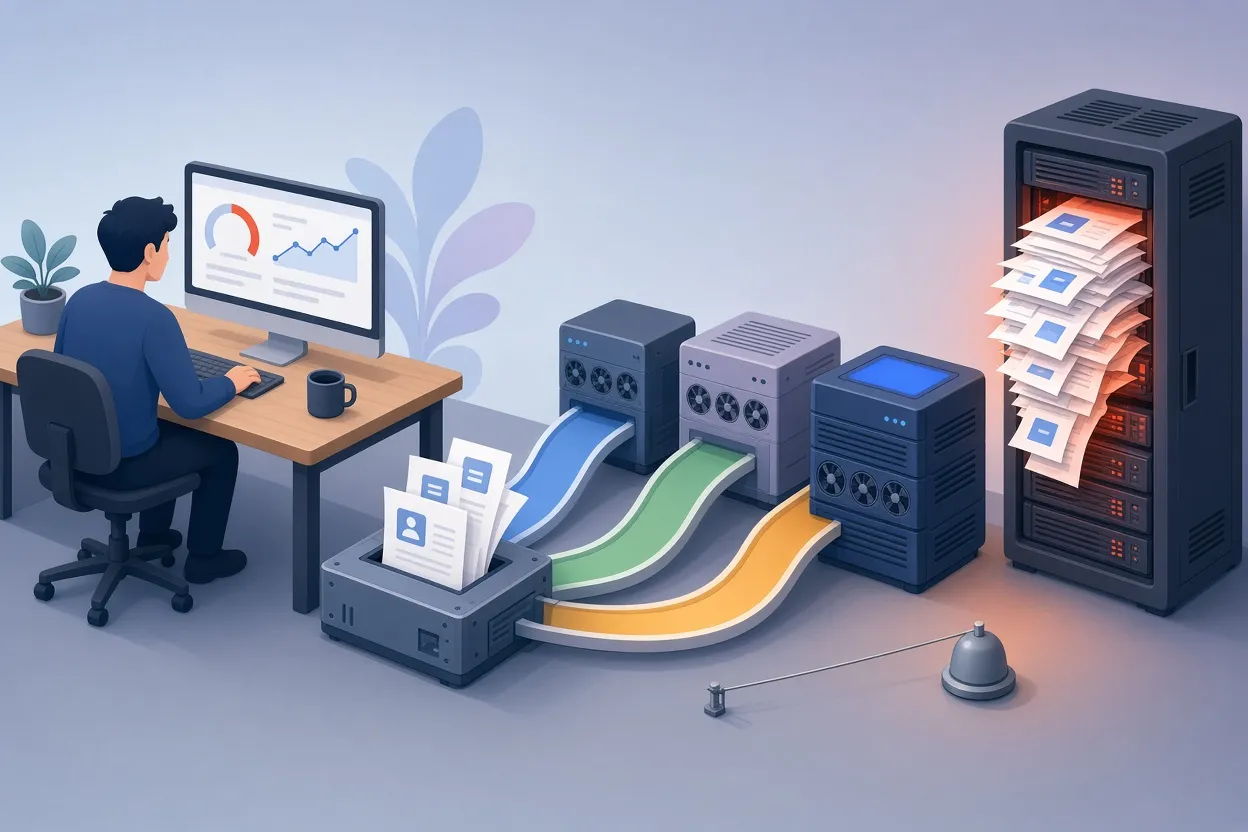
▲ token 비용 관리 구조
token 비용: 실험의 해에서 관리의 해로
비용 이야기는 Ford의 사례가 구체적입니다. 지난해는 거의 모든 workflow에 AI를 써 보도록 장려한 실험의 해였고, 올해 상반기에는 합리적 사용으로 기대치가 옮겨 갔으며, 9월부터 token 한도를 공식 시행했습니다. 개발 workflow에 telemetry를 심어 건강한 세션 지표와 상호작용당 turn 수를 추적하는데, 목적은 AI 호출이 공짜가 아니라 실제 돈이 드는 일임을 엔지니어에게 알리는 것입니다. AWS 초기에 불필요하게 ECS 인스턴스를 띄워 클라우드 비용을 키우던 시절에 빗댈 수 있는 상황입니다. Git branch 하나 바꾸는 데 $5짜리 AI 호출을 쓸 것인지, CLI 명령 하나로 끝낼 것인지를 이제 엔지니어들이 배우고 있습니다.
compute와 비용의 한계가 오히려 더 건강한 architecture로 이끈다는 시각도 있습니다. 초기에는 코드베이스 전체를 LLM에 던져 넣고 마법 같은 분석을 기대했지만 비용이 그 관행을 재검토하게 했습니다. 표준 UI 컴포넌트나 unit test boilerplate는 그때그때 LLM 추론을 돌리기보다 결정론적 generator로 만드는 편이 낫다는 것입니다. Instacart도 한도를 두었지만 목표는 생산성 억제가 아니라 개발자의 습관을 바로잡는 데 있다고 합니다. 시스템 시간 확인이나 branch 전환 같은 잡무에 frontier model은 필요 없고, 한 번 만든 script가 영구히 무료로 처리합니다.
또 다른 조직은 효율, 책임, 교육의 균형을 잡는 쪽으로 가고 있습니다. 팀에 진행 중인 세션 비용과 모델 사용량을 직접 보여 주고, safe default와 regression 확인, 최적화된 prompt에 투자해 상호작용 자체를 가볍게 만듭니다. 표준 한도에 도달한 개발자는 직속 매니저에게 원클릭으로 사유를 제출해 예산을 늘릴 수 있습니다. 모델 공급사 경쟁으로 token 가격이 내려가고 있지만, 비용을 책임지는 태도는 여전히 필요하다는 것이 이들의 판단입니다.
작업 종류에 따라 적절한 모델 등급으로 보내는 model router를 운영하는 조직도 있습니다. 한도는 하드 블록이 아니라 하루 단위 tripwire(걸리면 멈추게 하는 안전선)로, 밤새 돌아가는 자동 테스트나 benchmark 루프가 큰 비용을 쌓는 일을 막기 위한 것입니다. 실험기에는 감독 없는 루프가 하룻밤 사이 $1,000 단위의 token 비용을 쌓는 일도 있었습니다. 걸린 tripwire는 내부 개발자 포털에서 한 번의 클릭으로 풀 수 있어, 사람이 보고 있다는 확인 역할만 합니다. frontier model에는 넉넉한 월 예산을 두고 매니저 예외 절차로 관리하며, platform 팀이 문지기가 되기보다 사업 맥락을 아는 직속 매니저가 승인하게 합니다. 정해진 상한 안에서 유연성을 주면 분기별 비용 예측이 가능해집니다.
| 접근 | 비용 관리 방식 |
|---|---|
| 한도와 telemetry | 9월부터 token 한도 시행, 세션 지표로 비용 인식 교육 |
| 가시화와 승인 | 세션 비용을 팀에 공개, 한도 초과 시 원클릭 매니저 승인 |
| router와 tripwire | model router, 하루 tripwire와 원클릭 해제, frontier 월 예산 |
| 결정론적 도구 | 한도 운영과 함께 잡무는 script로 처리 |
마지막으로 기업은 token 단위로 비용을 내는 반면 소비자 제품은 정액 구독이라는 차이가 언급되었습니다. 정액제도 결국 token 경제를 반영하게 될 것이고, 사용 비용에 대한 감시가 업계 전반으로 번질 것이라는 전망입니다.
팀 도입을 고민한다면
이들의 경험을 종합하면, AI coding agent 도입의 성패는 코드를 얼마나 빨리 짜느냐보다 그 뒤 단계를 어떻게 다시 설계하느냐에 달려 있다고 볼 수 있습니다. 팀 단위 도입을 검토하는 독자가 바로 적용할 수 있는 항목을 정리하면 다음과 같습니다.
- 측정은 PR 수나 코드 줄 수가 아니라 고객 기능 출시 속도와 중앙값 개발자의 변화로 합니다.
- 전 과정을 스스로 통제하는 내부 도구와 유지보수, 프레임워크 업그레이드부터 agent를 투입합니다.
- 리뷰를 일률적으로 요구하는 대신 위험도별로 나누고, 강한 테스트가 덮는 기계적 변경은 자동 검증에 맡깁니다.
- 사양과 architecture 지시를 상류에서 정밀하게 쓰는 데 투자해 리뷰 부담을 줄입니다.
- feature flag, blue-green 배포, observability를 갖추고, 모바일은 스토어 심사 지연을 감안해 더 보수적으로 배포합니다.
- 기술 부채 시간의 일부를 prompt와 context 정비에 고정 배정하고, 교육은 일회성이 아니라 상시로 운영합니다.
- CI 부하를 10배 기준으로 점검하고 remote cache와 자동 복구 파이프라인을 준비합니다.
- token 비용을 개발자에게 보이게 하고, 하루 tripwire와 매니저 승인으로 관리하며, 반복 잡무는 script로 처리합니다.
무제한 실험의 시기는 지나고, 비용 책임과 architecture 최적화의 시기가 왔다는 것이 이 리더들의 공통된 진단입니다. 장기적으로는 model router와 결정론적 도구가 비용 최적화를 platform 안으로 흡수해, 개별 엔지니어가 모델을 고르는 부담에서 벗어나게 될 것이라는 기대도 함께 전해졌습니다.


