Google DeepMindは、ロボット向けAIモデル3種からなるGemini Robotics 2を公開しました。シーンを理解して計画を立てるモデルと、その計画を指先から足先までの動きに変えるモデルとで役割を分担する構成です。APIで一般公開されているのは計画モデルだけで、動作モデルは信頼できるテスター(trusted tester)に限られています。Google DeepMindでGemini Robotics研究を率いるリサーチリードは、進歩の速さに驚きつつも、ロボット工学はまだ言語モデルでいえばおおむね「GPT-2の時代」にあると位置づけています。何が変わったのか、ロボットを何が阻んでいるのか、ロボットAIを検討するチームがいま何をできるのかを整理します。
3つのモデル、2つの層
Gemini Robotics 2は階層構造で作られています。動きの遅い推論層が何をするかを決め、動作層が体をどう動かすかを決めます。
| モデル | 役割 | 提供状況 |
|---|---|---|
| Gemini Robotics ER 2 | シーン理解、空間分析、タスク計画、ツール選択 | Google AI StudioのAPIで公開 |
| Gemini Robotics 2 | 指示を関節の動きと軌道に変える視覚・言語・行動モデル | trusted testerのみ |
| Gemini Robotics On-Device 2 | クラウド接続なしでロボット上で動く小型の動作モデル | trusted testerのみ |
ERはembodied reasoning(身体性推論)の略で、その中で行動しなければならない身体の視点から物理的なシーンについて推論することを指します。Gemini Robotics ER 2はGemini Flashをもとに作られ、じっくり考える「System 2」の計画役を担います。開発者は、物をつかむ、置くといったロボットにできる動作を、テキストの説明を付けたツールとして記述します。するとモデルが適切なツールを選びます。ソフトウェアのAIエージェントが呼び出す関数を選ぶのと同じ仕組みです。
Gemini Robotics 2はVLA、つまり視覚・言語・行動(vision-language-action)モデルです。画像と言語を入力として受け取り、ロボットの動作を出力します。各関節を個別に扱うのではなく、手、腕、脚、姿勢をまとめて協調させ、全身を一度に推論します。高速なバランス制御と安定化のループは引き続き下位のコントローラーで動きますが、目標位置と軌道はVLAが生成します。オンデバイス版はロボット本体で動く圧縮版で、ネットワークの往復をなくし、帯域が乏しい場所でもロボットを動かし続けられます。
計画モデルが体を操る方法
計画モデルと動作モデルをつなぐ部分は、ステアラビリティ(steerability)と呼ばれる研究領域です。以前のERは、ピック・アンド・プレースの対象を2D画像の座標で指定していました。現在は、計画モデルがいくつかの方法で動作モデルを操れます。
- 自然言語:「後ろを向いて」「左を見て」など
- シーン内の物体を指し示すこと:レモンかバナナかといった曖昧さを解消できる
- インコンテキスト学習:デモ動画でロボットにやることを示し、再学習は不要
2つのモデルの間でプレーンテキストだけをやり取りすると空間的な情報が失われるおそれがあるため、両者の間をマルチモーダルな豊かなインターフェースでつなぐことが目標です。
記憶も制約の一つです。このモデルのコンテキストウィンドウ、つまり一度に考慮できる情報量は12万8,000トークンです。動画入力に換算すると、フレームレートや画像のエンコード方法にもよりますが、エピソード記憶でおよそ3分になります。短い操作タスクには足りますが、数時間かかる家事には足りません。実用的な対処法は、生の動画ではなく、終えた手順を「卵を裏返した」のような短いテキスト要約で残すことと、フレームを間引いたり変化のないフレームを捨てたりすることです。
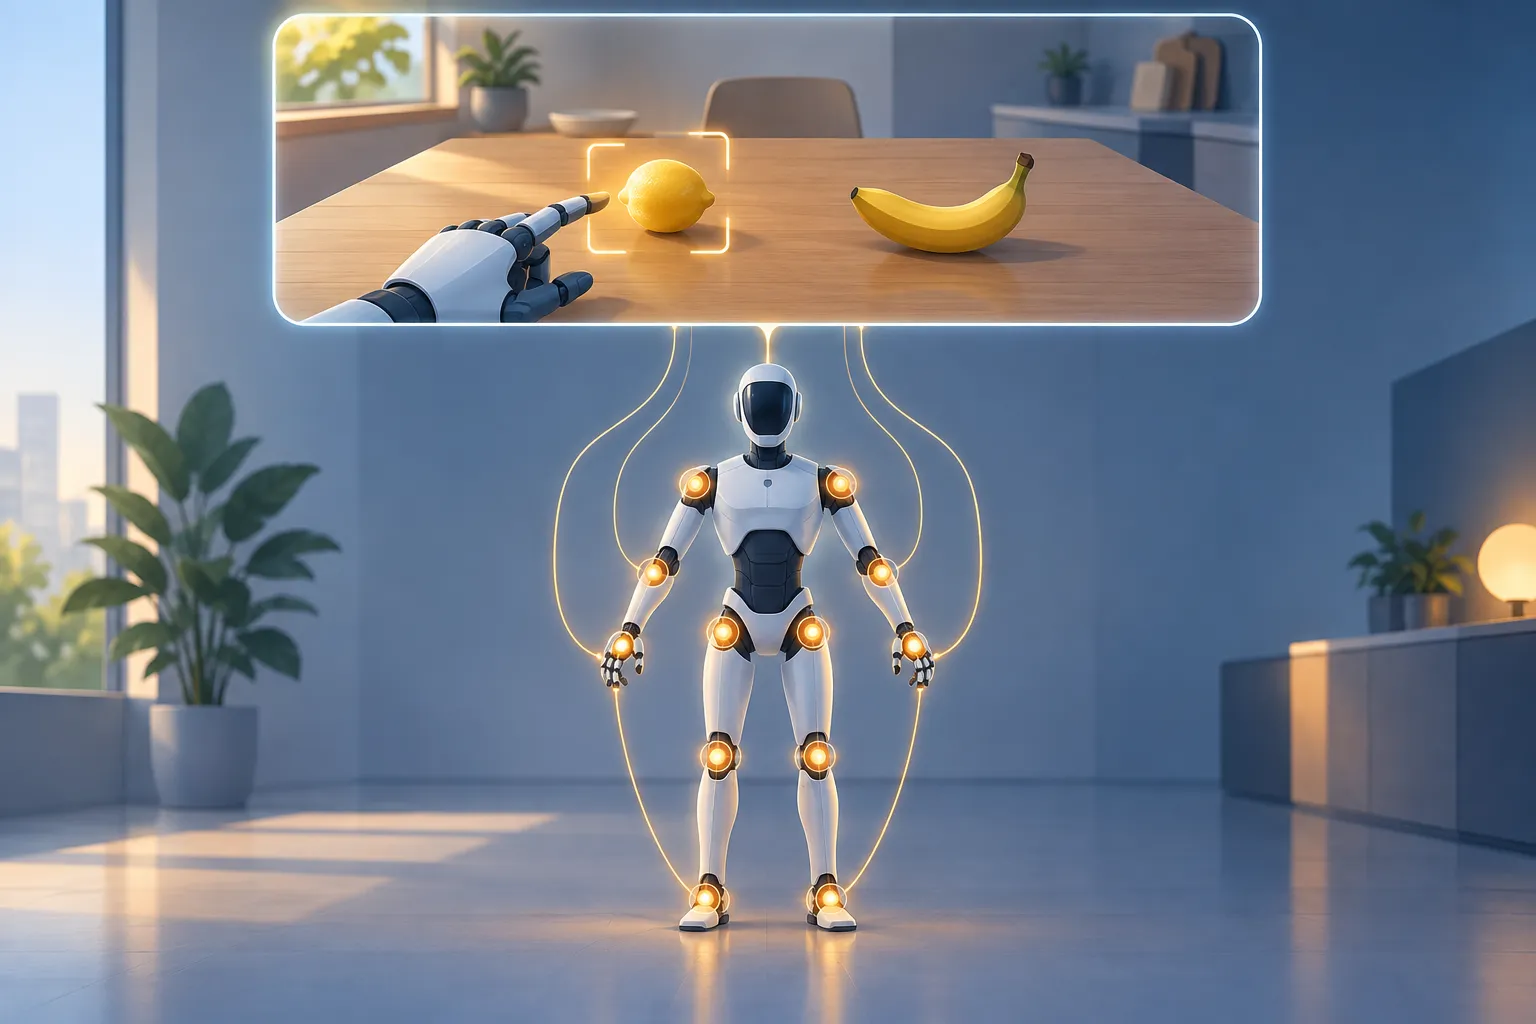
▲ 動作モデルを操る計画モデル
走るより手のほうが難しい理由
この夏、中国で開かれたロボット競技会で、ヒューマノイドロボットがトップクラスの人間のスプリンターより速く走り、その映像が広く拡散しました。研究の観点から見ると、平らな地面を走るのは比較的やさしい問題です。足と硬い床の接触は予測しやすいため、シミュレーションで正確に再現でき、シミュレーションで身につけたスキルが実機にうまく移ります。走るロボットは、人間や動物の動作データで初期化した低レベルの強化学習コントローラーに頼っており、高レベルの推論はほとんど使っていないとみられます。それに、速さはロボットを家庭や職場で役立つものにする要素ではありません。
物を扱うマニピュレーションは事情が違います。摩擦が変わり、物体は曲がったり折れたりするため、シミュレーターが追いつきません。布をたたむ作業が代表例です。硬い物体のピック・アンド・プレースは例外で、幅広いデータで事前学習した大規模な基盤モデルのおかげで、商用に十分なほぼ信頼できる水準に近づきました。そのため研究の最前線は、卓上に固定されたグリッパーアームから、歩き、しゃがみ、見慣れない物体をクローズドループで扱うヒューマノイドへと移っています。
ハードウェアも変わりました。Gemini Robotics 1は、2本指の平行グリッパーで何ができるかを示しました。その約15カ月後、Gemini Robotics 2は多指ハンドでゴミ袋の口を結ぶところを見せました。いまや器用さの最前線は多指ハンドにあり、市販の選択肢もさまざまです。
| ロボットハンド | 大きさ | 力 |
|---|---|---|
| Wuji | 人間の手に近い | 10歳の子ども程度 |
| Sharpa | 人間の手より大きい | 約20キロを持ち上げ、固い瓶のふたも開けられる |
残る課題は、信頼性、個体ごとのばらつきのなさ、そしてコストです。触覚も重要です。力覚センシングと、押されると関節がなめらかに追従するバックドライバビリティ(back-drivability)があれば、ロボットはポテトチップスを割らずに積み重ねられます。指先の力のデータを学習モデルに取り込むと、視覚だけの場合と比べて判断が向上します。
ロボット工学がまだ「GPT-2の時代」にある理由
GPT-3は、言語モデルが少数の例から新しいタスクを確実に学べるようになった転換点でした。ロボット工学は、幅広いタスクでその段階にまだ達していません。
最大の壁はクロスエンボディメント(cross-embodiment)、つまり一つのモデルで体やセンサーの異なるロボットを制御することです。言語モデルはiPhoneでもMacでもLinuxサーバーでも同じように動きますが、ロボットの方策はハードウェアが変わるとまったく機能しないことがよくあります。言語AIはこの問題を解く必要がありませんでした。Google DeepMindは特定の体に依存しない汎用知能を目指しており、ヒューマノイドをその試験の場にしています。全身のバランス、多指による器用さ、人とロボットのインタラクションという3つの課題で、同時に前進を迫られるからです。
前進もあります。Google DeepMindはApptronik、Agile Robots、Boston Dynamicsなどのロボットメーカーと協力しており、オンデバイスモデルは約200回のデモで新しいロボットの体に適応します。一方、追加学習なしで見慣れないロボットに載せ、実運用レベルの信頼性で動かすゼロショット展開はまだ解決していません。デモによるプロンプトは準備時間を短縮しますが、シーンが変わると硬直的な模倣に陥ることがあります。
誤りも積み重なります。10の動作を連ねる場合、システムは各ステップが成功したかを確かめ、次のサブゴールを選ばなければなりません。確かなリアルタイムの回復手段がなければ、全体の成功率は急激に下がります。失敗を取り消せるかどうかで大きな差が出ます。
- LEGOの組み立ては寛容:置き間違えたブロックはやり直せばよい。
- 卵料理はそうではない:落とした卵や焼きすぎた卵は元に戻せないため、はるかに高い信頼性が求められる。
視覚の汎化は大きく進み、照明やキッチンの配置が変わってもモデルが崩れることはなくなりました。いまのボトルネックは、接触、力の制御、取り返しのつかない手順といったタスクの物理的な側面です。
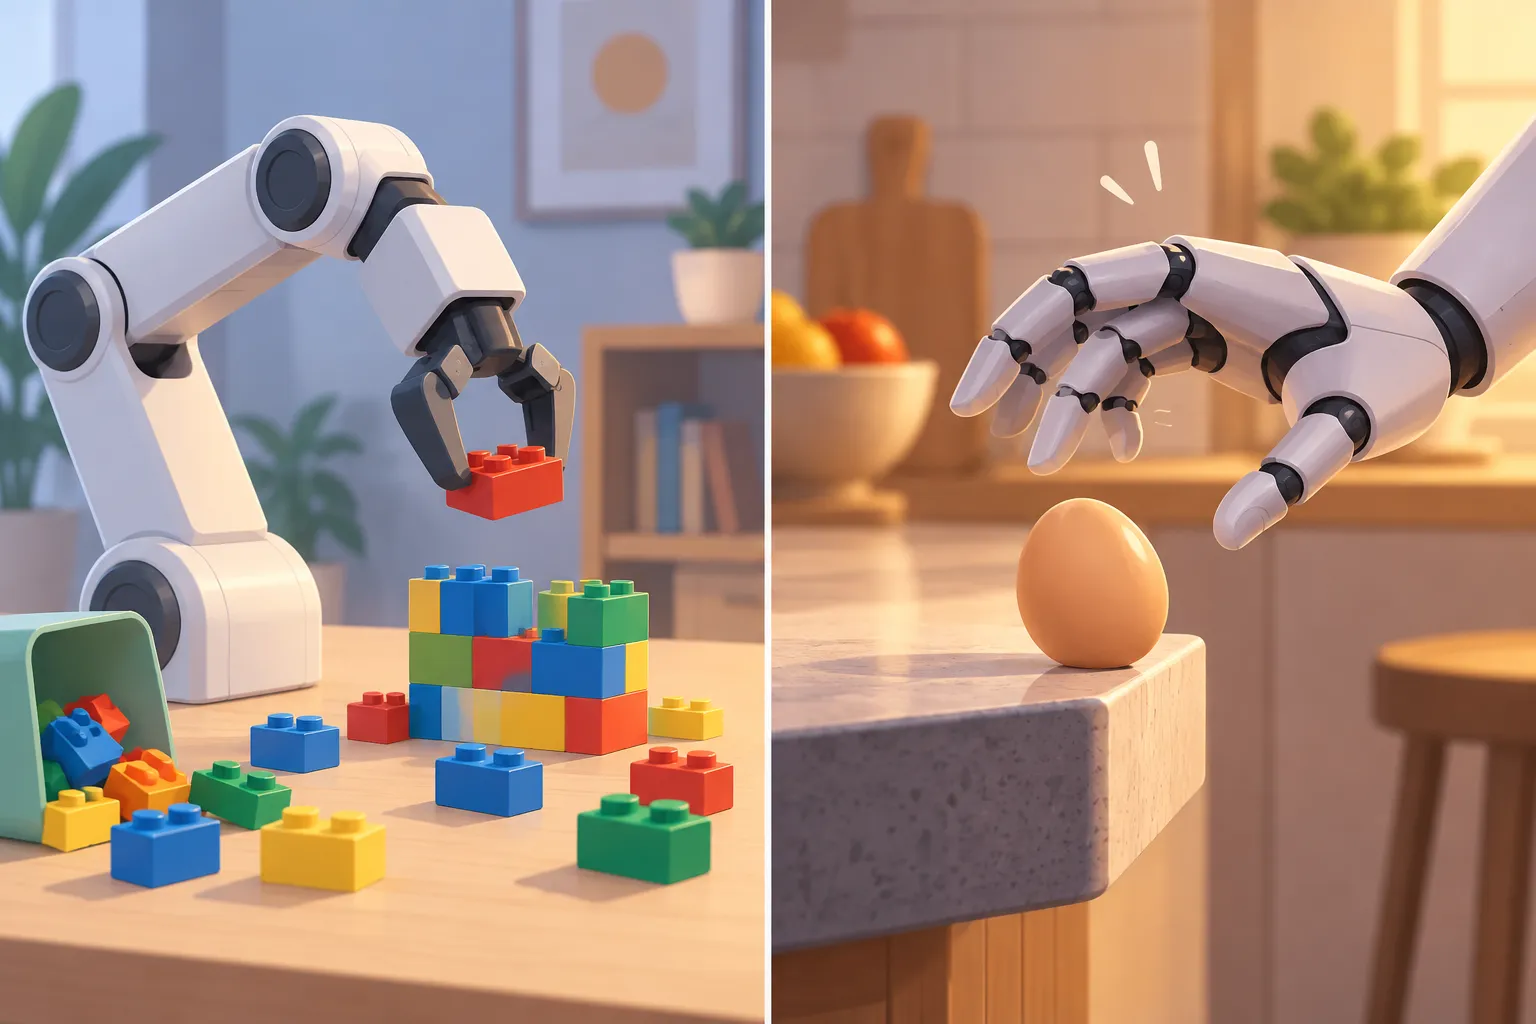
▲ やり直せる作業と取り返しのつかない作業
速度と信頼性は用途しだい
レイテンシーは現実的なトレードオフです。Gemini Robotics APIにつないだ簡単な2Dシミュレーションでは、モデルが画像と「バナナを皿に移して」という指示を受けてからツールを呼び出すまで約6秒かかりました。即応が必要なやり取りには遅いものの、許容される速度は現場によって変わります。
- 工場の組み立てラインは止められないため、非常に速い応答が必要です。
- 洗濯物をたたむような家事は速さより正確さが大事で、ロボットが夜のうちにゆっくり作業してもかまいません。
- 通信環境の悪い遠隔地の現場には、ロボット上で動くモデルが必要です。
それでも家庭が最初の市場になるわけではありません。幼い子どもや散らかった予測しにくい間取りが安全面のハードルを非常に高くするため、環境を管理しやすい商業施設のほうが初期導入には向いています。新しい能力はまず大きく遅いモデルに現れる傾向があるため、速いモデルと遅いモデルが並行して開発され、大きなモデルの知識が小さなモデルへ蒸留されていくとみられます。
計画モデルの強みは限られた領域で発揮されます。同様の2Dテストで基本的なピック・アンド・プレースを試したところ、作業中に物体が動いた場合も含め、Gemini Robotics ER 2とベースのGemini 1.5 Flashの結果は同等でした。ER 2が優位に立つのは、アナログメーターの読み取り、欠陥の検査、位置の正確な指し示しといった専門的な作業です。Google AI StudioでAPIが公開されると、利用は小規模なtrusted testerグループで見られた規模をはるかに上回り、研究者たちはBoston DynamicsのSpotに搭載して計器を読ませたり、お菓子を配らせたりしました。ただし注意点があります。ロボット工学には標準APIがないため、独特なコマンド体系を持つロボットでは、計画モデルが安定して動かせるようになるまでプロンプトとスキーマの調整を繰り返す必要があります。
能力としての安全性
半分しか正しく答えられないチャットボットでも役に立つことはあります。しかし物を落とすロボットは実際の損害を生むため、失敗が許される作業でない限り、成功率50%や80%でさえ自律作業には足りません。安全性は能力にかけるブレーキではなく、それ自体が一つの能力として扱われます。安全で信頼できない家庭用ロボットを消費者は受け入れないからです。
ロボットの安全性には2つの側面があります。不器用さ、機械の故障、転倒を扱う物理的な安全性と、計画を立てるモデルの行動のアライメントです。重いヒューマノイドが家の中で倒れれば即座に危険なため、安全性は機械設計や非常停止のハードウェアから計画モデルまで、スタック全体に組み込む必要があります。
| 非常停止 | 仕組み | 脚のあるロボットへの影響 |
|---|---|---|
| ハードe-stop | すべての関節の電源を切る | 体が崩れ落ち、近くの人や物に倒れかかるおそれがある |
| ソフトe-stop | 関節をその場で固定する | バランスを保ち、倒れない |
行動面もテストされます。あるロバスト性テストでは、研究者が作業中のヒューマノイドの頭にかごをかぶせました。正しい反応は、センサーがふさがれたことに気づき、目が見えないまま動き続けるのではなく、止まって人に助けを求めることです。人の形をしていることもハードルを上げます。グリッパーが物をつかみ損ねても人はただの不具合と見なしますが、ヒューマノイドがしくじると、はるかに無能に見えます。会話中に台本どおりのうなずきではなくその場でジェスチャーを生み出すなど、ロボットの振る舞いが自然になるほど、期待はさらに高まるかもしれません。
押さえておきたいこと
Gemini Robotics 2は計画と動作を分け、計画モデルをAPIで誰にでも開放しました。一方で、器用なマニピュレーション、クロスエンボディメント、積み重なる誤り、安全性は未解決の研究課題として残っています。ロボットAIを検討する開発者や企業にとっては、技術の現在地から次のステップが導かれます。
- まず使えるもの、つまりGemini Robotics ER 2のAPIから始めます。ロボットの動作を名前と説明の明確なツールとして定義し、計画はER 2に任せ、動作は既存のコントローラーや専用の動作モデルに委ねます。
- 基本的なピック・アンド・プレースだけでなく、メーターの読み取り、検査、位置の指し示しなどER 2が最も強い作業で、汎用モデルと比較します。
- 先にレイテンシーの要件を決めます。工場のラインと夜間の家事では、適したモデルも配置方法も異なります。
- 失敗してもやり直せる作業から始め、複数ステップの手順ではステップの間に成功確認を入れます。
- 学習時の設定ではなく、物体を動かしたりシーンを変えたりしてテストし、本当の汎化か模倣かを見分けます。
- 脚のあるロボットでは、電源を切るのではなく関節を固定する停止方法を使い、センサーがふさがれたら停止して助けを求めるようにします。