Amazon Web Services(AWS)は、近い将来に最も活発な利用者は人ではなくAIエージェントになるという前提で、クラウドの一部を作り直しています。AWSのCEOであるマット・ガーマン氏によれば、コーディングエージェントはすでにコードを書き、データベースを選び、インフラのデプロイまで自ら行っています。そのため、アカウントの設定からデータベースの耐久性、権限に至るまで、人間のエンジニアを前提とした設計はもはや合わなくなっているといいます。同氏は、不足するGPUをAWSがどう割り当てているのか、自社チップのGravitonとTrainiumがいまどんな役割を担っているのかについても説明しました。
成長はまだ初期段階
AWSの年間売上規模はおよそ$1,690億 ~ $1,700億で、成長率は約37%です。ガーマン氏は、クラウドはまだ初期の段階にあると主張します。世界の企業のワークロードの大半はいまもオンプレミスのデータセンターに残っており、AWSはそうしたワークロードの着実な移行と、生成AIによる需要の急増という2つの波に同時に乗っているといいます。
その中心にいるのは今もスタートアップです。ガーマン氏は2005年、ビジネススクール在学中のAWSインターンとして、どんな顧客が最初にクラウドインフラを評価するかを調べ、従量課金によってサーバーの初期費用が不要になるスタートアップこそがその顧客だと結論づけました。同氏の推計では、現在のAWSの売上の30~40%は、AWS上のスタートアップとして始まった企業から生まれています。スタートアップは銀行や病院、政府機関よりも強く、速くAWSのサービスに要求を突きつけ、その要望は大企業が3~5年後に求める機能を先取りしていることが多いといいます。
変わったのはスタートアップの規模です。かつての創業者はおよそ$1,000万を集め、1つのアプリをじっくり磨き上げていました。いまの有力なAIスタートアップは、$2億の資金調達と$10億の企業価値で事業を始めます。その大きな理由は、モデルの学習とGPUの調達に莫大な費用がかかることです。それでも、スケーリング、性能、セキュリティ、アクセス管理という基本的な課題は変わらないとガーマン氏は指摘します。
エージェントがクラウドに求めるもの
数秒で使えるアカウント
これまでAWSを使い始めるには、Virtual Private Cloud(VPC、AWS内のプライベートネットワーク)、サブネット、ルーティングテーブル、そして誰が何をできるかを決めるIAMロールを設定する必要がありました。開発者がCursor、Claude、Codexといったコーディングエージェントにクラウドの認証情報を渡し、アプリの構築からデプロイまで任せる場面では、こうした手間が妨げになります。
AWSは、Gmailアカウントのような一般的なIDで登録でき、最初はクレジットカードの入力も不要で、30秒未満で使えるアカウントが手に入る登録方法を順次提供しています。ネットワークとセキュリティの既定値は裏側で自動的に設定されます。これは機能を絞った試用アカウントではありません。企業が成長し、正式な組織構成や細かな設定が必要になっても、同じアカウントの中で変更でき、移行は不要です。提供は進行中のため、まだすべての環境で使えるとは限りません。
消えることを前提にしたリソース
AWSは長年、Amazon Auroraのようなサービスを「ファイブナイン」(99.999%)の耐久性と可用性を目標に設計してきました。しかしエージェントが必要とするのは、まったく異なるものであることが多いといいます。途中の処理のための一時的なデータベースを作り、数秒後には捨てるといった使い方です。ガーマン氏の見方では、これを複数リージョンの複製で包むのは過剰設計です。AWSは、必要に応じて長期保存も選べるようにしつつ、ミリ秒単位で作成と削除ができるリソースを検討しています。目標は、エージェントが3秒未満でデータベースを立ち上げて問い合わせまで済ませられるようにすることです。
範囲を絞った一時的な権限とサンドボックス
人間や固定のサービスロール向けに作られたIAMの権限は、エージェントには合いません。エージェントには広範で長期間有効な認証情報を持たせるべきではないからです。AWSは、1つのサブタスクに必要なツールと範囲だけを、期限付きでエージェントに与える権限の仕組みを構築しています。
エージェントには隔離も欠かせません。エージェントが生成したコードは、すぐに起動でき、なおかつ境界の堅いサンドボックスで実行すべきです。AWSは、約10年前に自社で開発したmicroVM(非常に軽量な仮想マシン)技術であるFirecrackerを使っています。起動が速く、ワークロードを強力に隔離できる技術で、AI分野で新たに登場しているサンドボックス系スタートアップの多くもFirecrackerの上に直接サービスを構築しています。
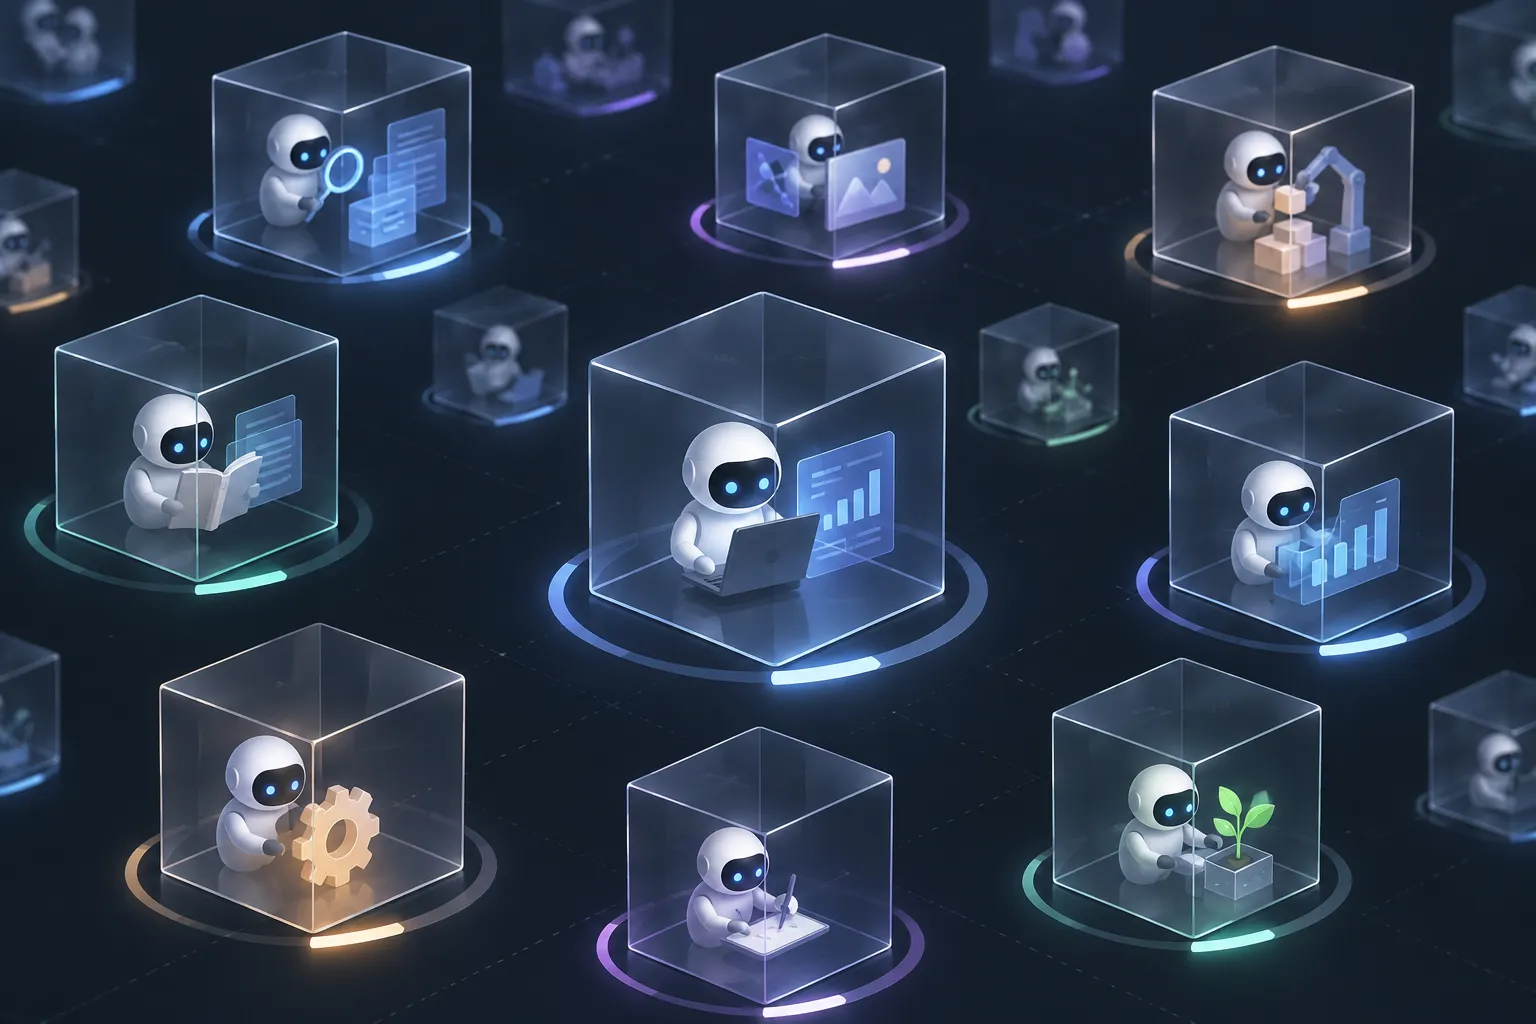
▲ 期限付き権限と隔離されたサンドボックス
予測可能なテールレイテンシ
エージェントのワークフローは数百もの処理を順番につなげて実行するため、まれに起きる遅い応答が積み重なります。これはテールレイテンシと呼ばれ、Amazon S3のp99.9のような水準で測られます。人ならたまの遅延は我慢できますが、エージェントのループでは遅延が累積します。ガーマン氏は、テールレイテンシの削減に長年注力してきたことが、エージェントのワークロードにとって実際の強みになると主張しています。
AWSはエージェント向けのサービスも提供しています。Amazon BedrockとAgentCoreは、オーケストレーション、メモリ、ゲートウェイ、そしてモデルとツールの間の権限の境界を扱います。S3のような基盤サービスも、人間以外のアクセスパターンに合わせて調整が進んでいます。プレビュー版として公開された新サービスのAWS Contextは、S3やAuroraといった別々のデータストアの上にメタデータの層を設け、エージェントが1つのインターフェースからまとめて問い合わせられるようにします。
AWSはGPUをどう割り当てているか
AIスタートアップにとって最大のボトルネックは、高性能GPUの確保です。AWSによれば、顧客からのGPUの要求のうち約60%には、リージョン、時期、クラスター構成を調整するなどして何らかの形で応えています。
AWSは、Anthropic、OpenAI、Metaといった最先端の大手AI研究機関にクラスター全体を明け渡すことも避けています。SalesforceやJPMorgan Chaseのような大企業の顧客とのバランスを取り、初期段階のスタートアップ向けの容量も確保しています。特定の1社が売上に占める割合は1桁%にとどめており、ガーマン氏はこれを、1~2社のAI企業が売上の30~60%を占めることもあるGPU特化型クラウド、いわゆるネオクラウドと対比しています。
投資額は巨大です。AWSは今後数年で約200万基のNVIDIA製GPUを追加する計画で、2026年の設備投資は約$2,200億という規模が話題に上りました。ガーマン氏はバブル説を否定し、企業の顧客は本番環境のAIワークロードで投資に見合う成果を得ていると述べています。
ペースを決めるのは物理的な制約です。電力、データセンターの建設、メモリとチップ、そして熟練した人材がそれに当たります。ガーマン氏は、エリヤフ・ゴールドラットの著書『ザ・ゴール』の制約理論を引き合いに出します。1つのボトルネックを解消すると次のボトルネックが現れるという考え方です。電力の問題を解決すれば、制約はメモリ、TSMCのパッケージング、広帯域メモリ(HBM)、ネットワーク機器へと移ります。AWSはいまやサーバー容量を2026年から2028年まで何年も先を見越して計画し、発電と送電は最長20年先まで計画しています。
自社チップ戦略
AWSのチップ開発は13~14年前、サーバーの仮想化が計算資源を食いつぶしていた時期に始まりました。AWSはネットワークとストレージの仮想化を専用カードに移し、ARMコアを搭載したカードを作っていたスタートアップのAnnapurna Labsを買収しました。これがNitro Systemとベアメタルインスタンスにつながり、そのARMコアを拡張して生まれたのがサーバー向けCPUのGravitonです。
| チップ | 役割 | 主なポイント |
|---|---|---|
| Graviton | ARMベースのサーバー向けCPU | コスト約20%減、性能約20%向上。AWSの上位100社の顧客の90%以上が利用 |
| Inferentia | AI推論 | 5~6年前に始めたAIチップ開発の一環 |
| Trainium 3 | AIの学習と推論 | 第3世代。容量は来年末までほぼ予約済み |
| Trainium 4 | 次世代AIチップ | 事前に発表済み |
AWSが毎年導入するサーバー向けプロセッサーの中で最も多いのがGravitonで、サーバー群をまるごと移行してサーバー台数を半分に減らした顧客もいます。ガーマン氏は、GravitonこそAWSの請求額を下げる最も簡単な方法だと述べています。
AWSによれば、Trainiumはその名前とは裏腹に、推論においても最もコスト効率の高いチップの1つになりました。Amazon Bedrockの推論の大半はTrainium上で動いており、AnthropicとOpenAIもTrainiumを使っています。ガーマン氏は、AWSは製品の名付けが下手だと認め、InferentiaとTrainiumの紛らわしさを例に挙げてもいます。
▲ 独自チップと電力のボトルネック
企業のエージェント導入を阻む本当の壁は信頼
現在の企業のエージェントの多くは、人が承認に関わる形をとり、従業員の手順を一歩ずつそのままなぞっています。ガーマン氏は企業に対し、目指す成果から考え直し、エージェントに数十通りの道筋を並行して試させるよう促しています。
同氏によれば、完全な自律化を阻む最大の障害はモデルの能力ではなく信頼です。権限を誤って設定されたエージェントが本番データベースを削除するのではないかと企業が恐れるのは当然であり、だからこそガードレール、きめ細かなアクセス制御、厳格な評価を先に整える必要があります。AWSは顧客企業の現場にエンジニアを送り込む45日間の支援で、評価の仕組みとデータのラベル付けづくりを手伝い、その後は顧客自身のチームに運用を引き継ぎます。何年にもわたるコンサルティング契約に縛りつけないためです。
データについてAWSは、Amazon Bedrock上の顧客のプロンプトと入力は顧客のVPCの中にとどまり、モデル提供企業と共有されることはないと強調しています。ガーマン氏によれば、Bedrockは大きく伸びており、OpenAIのAPIから移ってくるワークロードや、AnthropicのClaudeモデルやオープンウェイトモデルの急速な採用が見られます。セキュリティ面では、高度なモデルを使って脆弱性を見つけ、顧客の環境の文脈に照らして優先順位をつけるContinuumを打ち出しました。防御も機械の速度で動かなければならないという考えに基づくものです。
Amazon社内では、すべての社員がAmazon Qを使っています。人事チームは数週間かかっていた計画作業を数時間で終え、財務チームはエージェントを使って税制や規制のルールを確認し、エンジニアはますます多くのコーディングエージェントを指揮するようになっています。かつて10人のエンジニアが担っていた仕事は、いまでは3~4人の小さなチームが受け持っています。
開発者が押さえておきたいこと
AWSは、エージェントがクラウドの主な利用者になるという見通しに賭けています。AWSでサービスを構築するなら、次のような実践的なステップが考えられます。
- コーディングエージェントには広い管理者権限ではなく、範囲を絞った短期間の権限を与え、エージェントのコードはサンドボックスで実行する。
- エージェントが短時間だけ使う一時データには、本番レベルの複製を付けない。
- 多段階のエージェントでは、平均値ではなくp99やp99.9のレイテンシでサービスを比べる。
- GPUが必要なときは、リージョンとハードウェア構成に柔軟性を持たせる。
- コストを下げたいなら、Gravitonに移せるワークロードを確認する。
- 企業にエージェントを導入するときは、成果を軸にプロセスを設計し直し、本番運用の前に評価とガードレールを整える。