Claude Opus 5.5の強みが最もよく表れたのは実務での成果です。要点を押さえた文章で回答し、コードによるアニメーションを生成し、操作できるWebデザインを制作しました。2週間にわたるモデルのテストとワークフローへの組み込みでは、モデルが処理するテキストの単位であるAPIトークンを約$3000分使用しました。AnthropicがOpus 5.5をリリースしたのは、OpenAIがGPT-6 SolとGPT-6 Lunaを発表するわずか2時間前です。このタイミングから両者を比較したくなりますが、ここで詳しく扱う作業例はOpus 5.5によるものであり、新しい3モデルすべてを同条件でテストした結果ではありません。
▲ ベンチマークと実務の成果
この違いは重要です。標準化された性能テストであるベンチマークと、完成した成果物では、答えられる問いが異なるからです。Anthropicの社内比較表では、Opus 5.5がGPT-6を上回っています。ただし、以下で扱う文章、アニメーション、デザインの課題にSolとLunaがどう対応したかは、個別に示されていません。
数値は何を比較しているか
| 指標 | 報告された結果 | 比較対象 |
|---|---|---|
| ベンチマークテスト | 9項目中7項目でOpus 5.5が優位 | Anthropicの社内比較表におけるGPT-6 |
| 運用コスト | 40%低い | 従来のOpusモデル |
| 出力生成速度 | 30%速い | 従来モデル |
コストと速度の数値は、GPT-6 SolやGPT-6 Lunaに対する価格面または速度面での優位を示すものではありません。ベンチマークの表も、新しい両モデルとの同一課題での比較ではありません。これらの結果ではOpus 5.5が好成績を収めているように見えますが、特定の仕事に使うモデルを選ぶには、その仕事での出力を確認する必要があります。
要点に直行する文章
AnthropicのエンジニアはOpus 5.5について、文の明瞭さ、重要な情報を先に置くこと、ユーザーが指定した文章上の制約を守ることを重視したリリースだと説明しています。Claude Opus 5との比較では、書式がよりすっきりしていました。実務的な技術上の質問の例では、会話的な前置きから始めず、すぐに診断を示しました。
すぐに使える答えが必要な場合、こうした振る舞いはスコアと同じくらい重要になり得ます。試用では、Opus 5.5の文章は従来版より自然で率直だと評価されましたが、これは定性的な判断です。同じプロンプトに対してGPT-6 SolやGPT-6 Lunaのほうが冗長になるという根拠にはなりません。この比較には、両モデルによる同等の文章例が含まれていないためです。
アニメーションテストで見えた注意点
Opus 5.5には、素のJavaScriptによるcanvas描画とWeb Audio APIで作る音を使い、単一の自己完結したHTMLファイルとして短編アニメーションを制作するよう求めました。canvasはWebページに図形を描く仕組みで、Web Audio APIを使うとコードで音を作れます。生成されたアニメーションでは、色鮮やかなボールが、小舟や鳥のいる水彩画風の風景の中を移動しました。静止画を求めるより難しいテストです。フレームごとの変化と一連の場面をモデルが指定しなければならないからです。
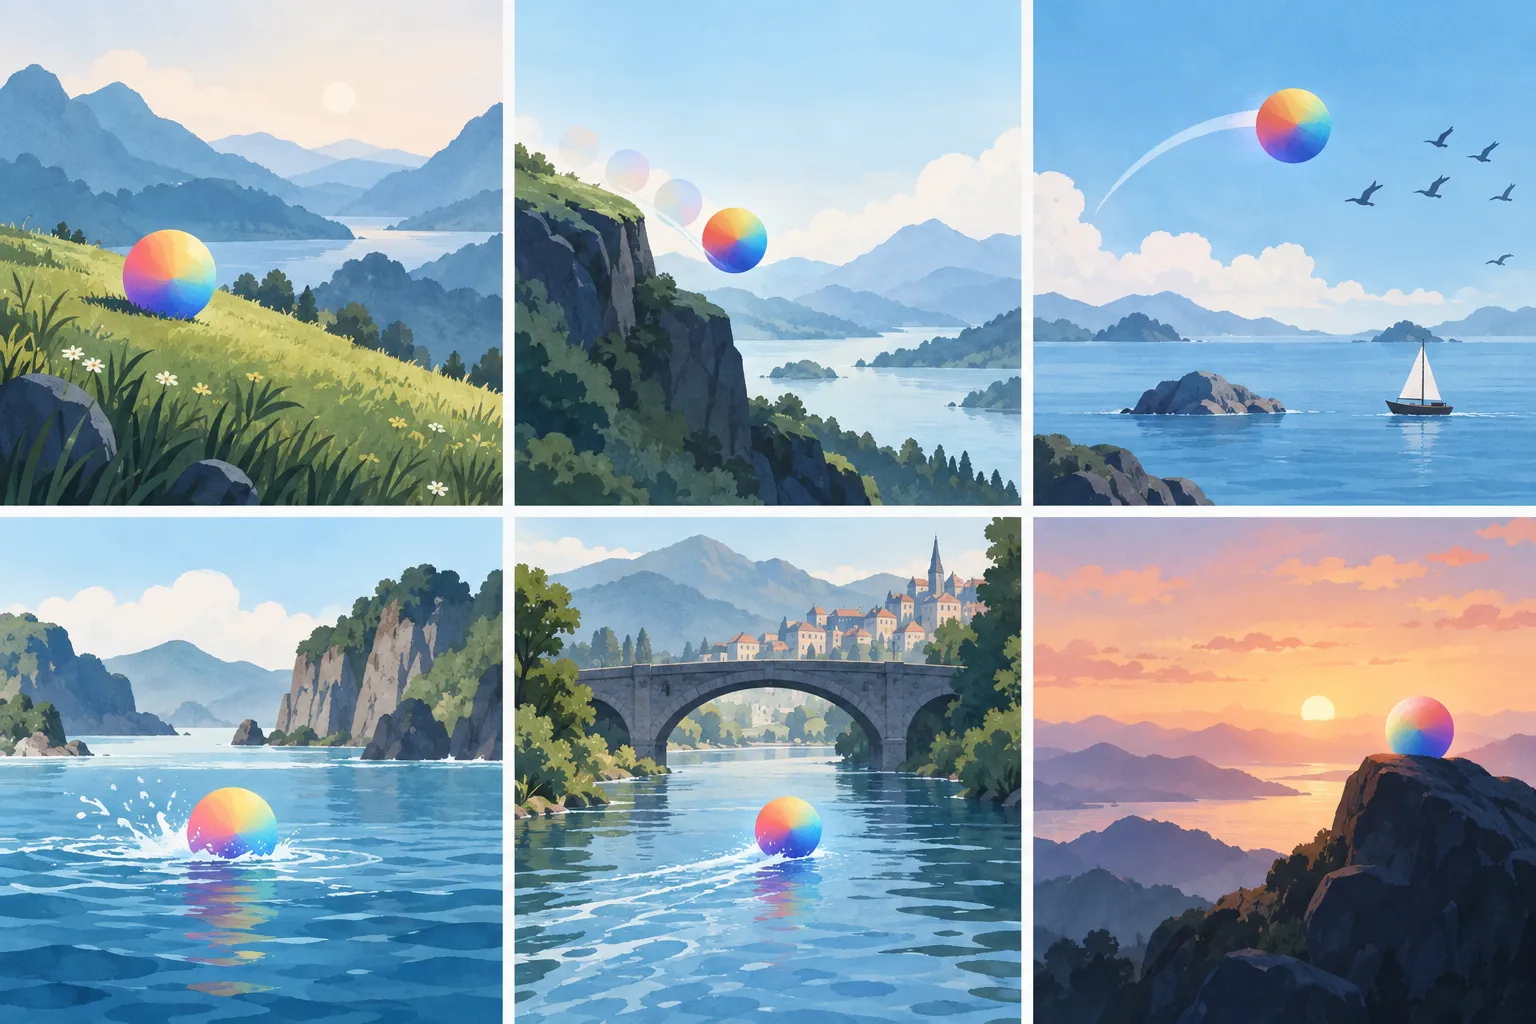
▲ コードで作った風景アニメーション
出力されたコードは、HTMLファイルと補助的なレンダリング用スクリプトを合わせて約1300行でした。要求された形式は単一の自己完結したファイルだったため、見た目の仕上がりは魅力的でも、追加のスクリプトがあった点は見逃せません。別のクリエイティブコーディングの例でも、JavaScriptによる描画と生成した音を使い、複数の場面で構成される物語を制作しました。これらの例は、Opus 5.5がかなりの量のアニメーション用コードを生成できることを示唆します。一方で、修正なしですべての納品条件を満たせる頻度までは分かりません。
コードだけでなく成果物としてのデザイン
Claude Projectsでは、Opus 5.5が事業紹介用のティーザーページについて、スタイルを整えた操作可能なプレビューを生成しました。デザインには、書体の選択、流れるようなグラデーションの図形、モバイル画面に対応するレスポンシブなレイアウトが含まれていました。また、Anthropicのベンチマーク結果と価格性能比の数値を視覚化した7枚のスライドも制作しました。これらは、外部で組み立てるための生のコードブロックにとどまらず、Claude内で確認できる成果物でした。
この違いによって評価の観点も変わります。フロントエンドの仕事では、レイアウトが意図したメッセージを伝えるか、モバイル画面のサイズで機能するか、修正しやすいかが重要です。これらの例では、Opus 5.5が洗練された初期出力を示しています。ただし、SolやLunaが同等のデザインを作れないと証明するものではありません。完成したページの内容や動作の確認に代わるものでもありません。
比較を役立てるには
実務で得られた結果は、簡潔な文章作成、クリエイティブコーディング、視覚的なフロントエンド制作でOpus 5.5を試す理由になります。ベンチマークの数値も判断材料になりますが、重要な仕事についてGPT-6 SolとGPT-6 Lunaを直接試す代わりにはなりません。比較は、次のような小規模な手順で十分です。
- 希望する文章の長さと、答えを先に書くという条件を含め、各モデルに同じ文章作成を依頼します。明瞭さと、必要な編集の量を比べます。
- アニメーションやWebデザインが仕事に含まれるなら、納品物とファイルに関する条件を指定します。見た目の結果に加え、ファイルが依頼に合っているかも確認します。
- 各出力の確認と修正にかかった時間を記録します。エージェントの出力を直すほうが手作業より時間がかかるなら、ベンチマークの好成績に期待するのではなく、ワークフローそのものを見直します。
Opus 5.5の作業例は同モデルを試す理由になりますが、現時点の数値だけではSolとLunaに関する疑問は解消しません。評価表を参考に調べる点を決めたうえで、条件をそろえた課題、実際に使える出力、自分の仕事で必要な確認作業の量に基づいて選んでください。