Claude Opus 5.5在实际工作中展现了最有说服力的能力:直接给出文字回答、用代码生成动画,并制作交互式网页设计。为期两周的模型测试与工作流集成使用了价值约$3000的API token,即模型处理文本的计量单位。Anthropic发布Opus 5.5仅两小时后,OpenAI就推出了GPT-6 Sol和GPT-6 Luna。这一时间点自然引发比较,但本文详述的工作样例来自Opus 5.5,而非对三款新模型开展的同题测试。
▲ 基准分数与实际产出
这一区别很重要:基准测试(即标准化性能测试)与一件完成的作品所回答的问题并不相同。Anthropic的内部对比表显示,Opus 5.5相较GPT-6占优。但该表并未分别展示Sol和Luna在下文所述写作、动画及设计任务中的表现。
数字比较的是什么
| 指标 | 报告结果 | 对比对象 |
|---|---|---|
| 基准测试 | Opus 5.5在9项中领先7项 | Anthropic内部表格中的GPT-6 |
| 运行成本 | 低40% | 此前的Opus档位 |
| 输出生成速度 | 高30% | 此前的模型 |
成本和速度数据不能证明Opus 5.5在价格或速度上优于GPT-6 Sol或GPT-6 Luna。基准测试表也没有提供与这两款新变体的同题对比。从这些结果看,Opus 5.5似乎表现强劲,但要为具体工作选择模型,仍需检查它在该任务上的产出。
直奔重点的写作
一位Anthropic工程师表示,Opus 5.5此次更新着重提升语句清晰度、将重要信息放在前面,并遵守用户的写作要求。与Claude Opus 5相比,它的排版不那么密集。在一个实际技术问题示例中,Opus 5.5没有以寒暄式的铺垫开场,而是直接给出诊断。
当用户需要尽快用上答案时,这种表现可能和分数一样重要。此次测试认为,Opus 5.5的文字比早期版本更自然、直接,但这仍是定性判断。这不能证明GPT-6 Sol或GPT-6 Luna面对同一提示词会更啰唆;本次比较并未纳入这两款模型的对应写作样例。
动画测试及一个值得注意的限制
Opus 5.5接到的任务是制作一部动画短片:以单个自包含的HTML文件交付,使用原生JavaScript的canvas绘图,并通过Web Audio API生成声音。Canvas可用于在网页中绘制图形;Web Audio API则让代码能够生成声音。最终动画呈现了一颗多彩的球穿行于水彩风格的风景之间,画面中还有船只和飞鸟。相比生成静态图片,这项测试要求更高,因为模型必须安排不断变化的画面和连续的场景。
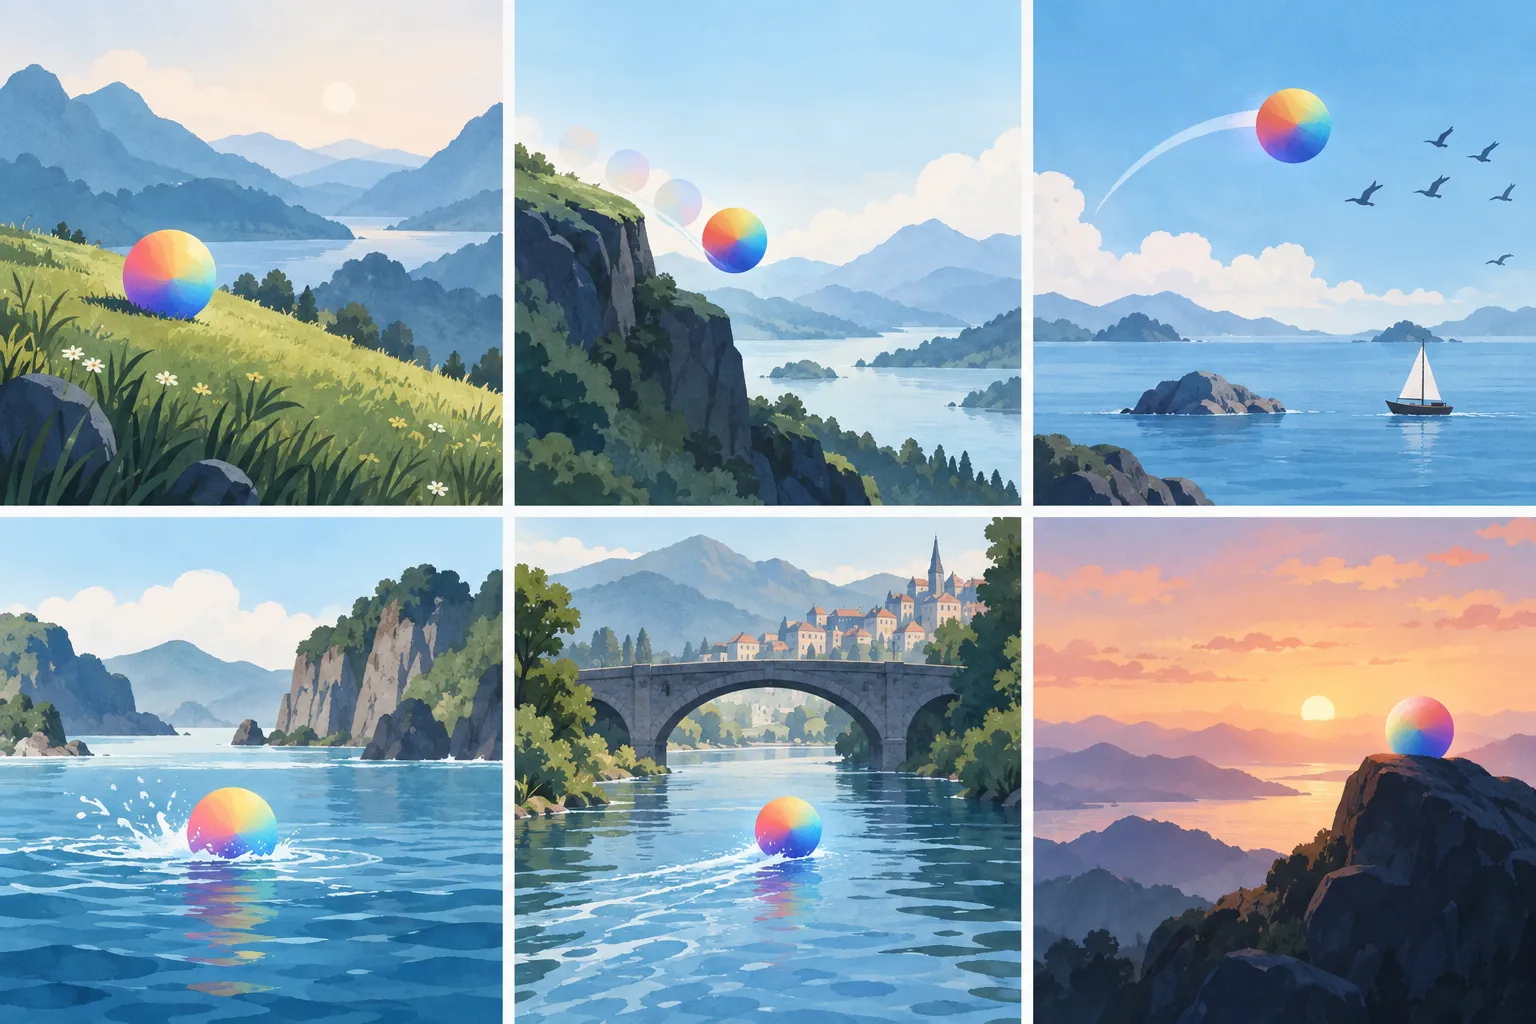
▲ 代码生成的风景动画
输出包含约1300行代码,分布在一个HTML文件和一个辅助渲染脚本中。任务要求以单个自包含文件交付,因此即使视觉效果颇具吸引力,额外的脚本仍值得注意。另一个创意编程示例也使用JavaScript绘图和生成的音频,制作了一个多场景故事。这些样例共同表明,Opus 5.5能够编写相当规模的动画代码;但它们不能说明模型无需修改就能满足每一项交付要求的频率。
设计:不仅是代码,更是可查看的成果
在Claude Projects中,Opus 5.5为一个商业预告页面生成了带有样式、可交互的预览。设计包含字体排版选择、流动的渐变图形,以及适配手机屏幕的响应式布局。它还制作了一份七页演示文稿,将Anthropic的基准测试和性价比数据可视化。这些成果可以直接在Claude中查看,而不只是需要到别处组装的原始代码块。
这一区别改变了评价方式。对于前端工作,值得关注的问题包括:布局能否传达预期信息、在手机尺寸下能否正常呈现,以及后续修改是否方便。这些样例显示了Opus 5.5完成度较高的初步产出,但不能据此断定Sol或Luna无法制作出同等水平的设计。它们也不能取代对最终页面内容和行为的审查。
如何让比较更有用
从实际样例来看,简洁写作、创意编程和视觉前端工作都值得试用Opus 5.5。基准测试数据提供了背景信息,但不能代替在与你相关的任务上直接测试GPT-6 Sol和GPT-6 Luna。有针对性的比较不必复杂:
- 向每个模型提出相同的写作要求,包括期望篇幅和先给出答案的要求。比较文字的清晰度和所需的编辑量。
- 如果工作涉及动画或网页设计,明确交付成果和文件限制。既检查可见效果,也核对文件是否符合要求。
- 记录审查和修正每份产出所花的时间。如果修正智能体工作的耗时超过手动完成任务,就应调整工作流,而不是认为基准测试的领先能解决问题。
Opus 5.5的工作样例提供了试用它的理由,但现有数据尚不能回答它与Sol、Luna孰优孰劣。可以用分数表决定要研究什么,再根据同题任务、可用的产出,以及工作所需的审查投入作出选择。