一个拥有270亿参数的模型即使被压缩到2比特精度,依然能在一张16GB显卡上完成实际的开发工作。Qwen3.8-27B-Escha-W2是Qwen3.8 27B的2比特版本,权重只需约10GB。在一项包含九个部分的测试中,它在256k token的上下文里15次试验全部找到了隐藏的密码,100道编程题通过75道,并在几乎不需要帮助的情况下做出了可运行的网页应用和游戏。测试也暴露了2比特量化的代价:3D资产的精细程度,以及依赖特定框架的游戏代码的准确性。下面整理这些结果对想在普通硬件上本地运行大模型的人意味着什么。
2比特27B模型是什么样的
量化是降低模型权重的数值精度、从而减少内存占用的方法。Qwen3.8-27B-Escha-W2是Qwen3.8 27B经2比特量化的微调版本,原始权重为10.15GB。因此装进16GB或24GB的消费级GPU后,仍有充足空间留给上下文,也就是模型工作时持续参考的文本。
该模型在Hugging Face上以GGUF格式提供两种版本,GGUF是推理引擎llama.cpp使用的文件格式:
| 版本 | 文件大小 | 说明 |
|---|---|---|
| Q8_0 embed与head | 10.31GB | 比F16小2.38GB,生成速度快3.4% |
| F16 embed与head | 12.69GB | 权重舍入与Q8_0仅相差约0.02% |
由于精度差异可以忽略,测试使用了Q8_0版本。另有一个2.93GB的可选MTP(多token预测)草稿模型,可通过推测解码加快生成,即由辅助模型提前猜测几个token。为了把16GB显存尽量留给上下文,测试没有使用它。
测试机器与九项任务
模型在Ubuntu Server 24.04.4上通过llama.cpp运行,CPU为AMD Ryzen 5700X,内存为32GB DDR4。目标GPU是配备16GB显存的NVIDIA RTX 2000 Ada。另一张RTX 5090仅用于加快测试自动化。
九项任务分为四组:
- 性能:原始的提示处理速度和生成速度
- 记忆:从超长上下文中检索信息
- 解题:分难度的推理测试和100道编程题
- 开发:看板网页应用、落沙物理沙盒、地牢探索游戏,以及通过MCP(Model Context Protocol,让AI模型调用外部工具的标准方式)操作Blender和Godot的两项智能体任务
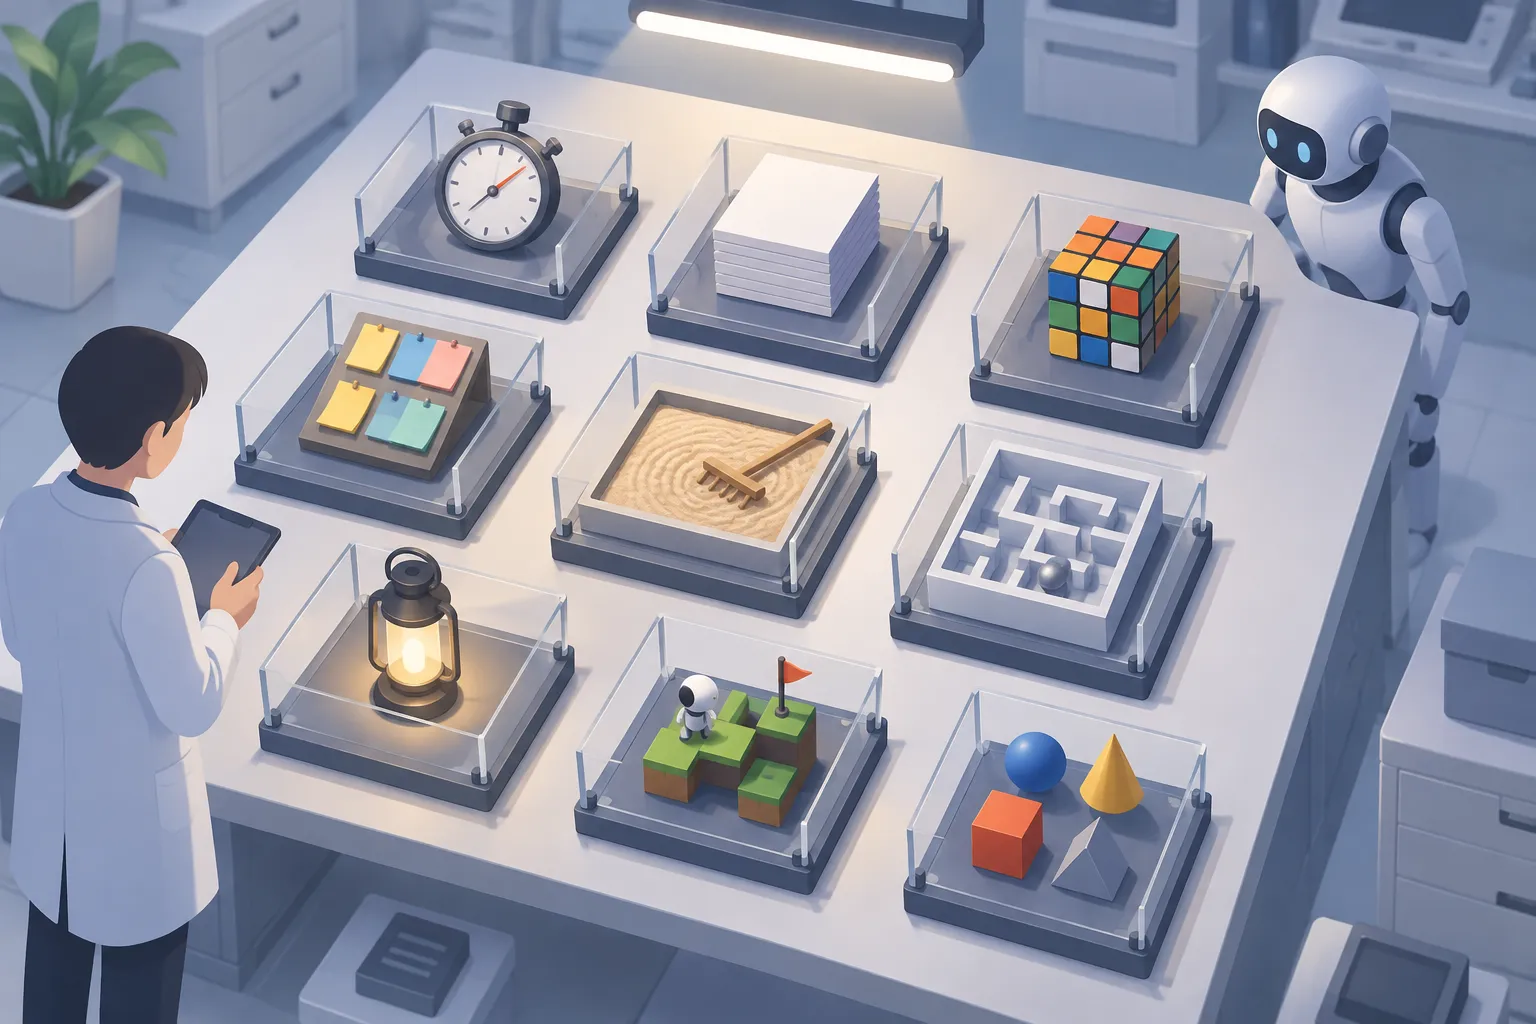
▲ 本地模型的九项测试
速度主要取决于显卡
预填充是模型读取提示的速度,解码是模型写出回答的速度。
| 测量项目 | 结果 |
|---|---|
| 无缓存预填充 | 512 token时每秒235.1个token,8k时295.1,32k时271.2 |
| 有缓存预填充 | 512 token时每秒1,904.7个token,32k时115,252 |
| 解码 | 短输出每秒11.6个token,16k以内平均11.4 |
每秒约11个token的解码速度可以使用,但并不快,主要原因似乎在于GPU。RTX 2000 Ada是一款70瓦的工作站显卡,显存带宽为每秒225至250GB。RTX 30、40、50系列的标准16GB桌面显卡,如RTX 4080或RTX 4070 Ti Super,功耗上限更高、显存更快,因此运行同一模型时生成token的速度应该会快得多。
长上下文记忆、推理与编程成绩
记忆测试采用大海捞针(Needle-in-a-Haystack)的方式。上下文扩展到256,608个token,并在文本0%、25%、50%、75%和100%的位置藏入一个秘密密码。每个位置测试三次,共15次,历时56分36秒。模型每次都找到了密码,通过率100%。不过,它的回答夹带了多余的思考过程和闲话,位置越深,回答越长、越杂乱,但提取出的答案始终正确。
| 测试 | 结果 |
|---|---|
| 推理48题 | 通过38题(79%),每题平均21,047毫秒 |
| 按难度 | 简单12题中12题,中等12题中12题,困难12题中10题,专家12题中4题 |
| HumanEval Remix 100题 | 通过75题(75%),5题未作答 |
| 仅计已作答题目 | 95题中通过75题(79%) |
推理测试涵盖逻辑、规划和概率,用时16分50秒。HumanEval Remix是根据OpenAI的HumanEval基准改编的100道Python编程题,运行了1小时8分,平均响应时间为41,067毫秒。对于压缩到2比特的这一规模模型来说,推理79%、编程75%看起来是扎实的成绩。专家难度下成绩骤降这一点,在把高难度逻辑问题交给它之前值得留意。
开发任务:擅长应用和游戏,3D较弱
| 任务 | 额外提示次数 | 上下文占用 | 结果 |
|---|---|---|---|
| 看板网页应用 | 1 | 57.3% | 修复一处缺失的按钮处理函数 |
| 落沙沙盒 | 0 | 30.6% | 首次即可运行 |
| 地牢探索游戏 | 0 | 34.2% | 首次即可运行 |
| Blender灯笼 | 1 | 89.7% | 发光过强,挂钩错位 |
| Godot 3D平台游戏 | 3 | 64.0% | 修复操作反转和碰撞错误 |
网页应用与模拟
看板支持在To Do、In Progress和Done三列之间拖放卡片、调整列顺序、在对话框中编辑卡片、优先级标签以及深色和浅色主题。第一版唯一的缺陷是Add Column按钮没有绑定点击监听器。在收到一条说明该按钮没有反应的消息后,模型发现了遗漏并修补了JavaScript文件。默认外观中规中矩,但功能代码质量很高。
落沙沙盒是一种元胞自动机,即每个格子按简单规则更新状态的网格。沙子会堆积,水会顺坡流下,酸会溶解墙壁和沙子。画笔大小调节、橡皮擦和清空按钮都能正常使用,无需任何修改。
程序化生成游戏
地牢探索游戏考验算法能力。模型选择了二叉空间分割,即反复把地图切分成矩形,来布置相互连通的房间和走廊。它用Bresenham直线算法从玩家位置向外投射最远9格的视线,随着玩家移动逐步揭开地图,并用不同颜色区分未探索、已探索和当前可见的格子。它甚至发现并修复了自己代码中出生点被选取两次的错误。整个过程无需额外提示。
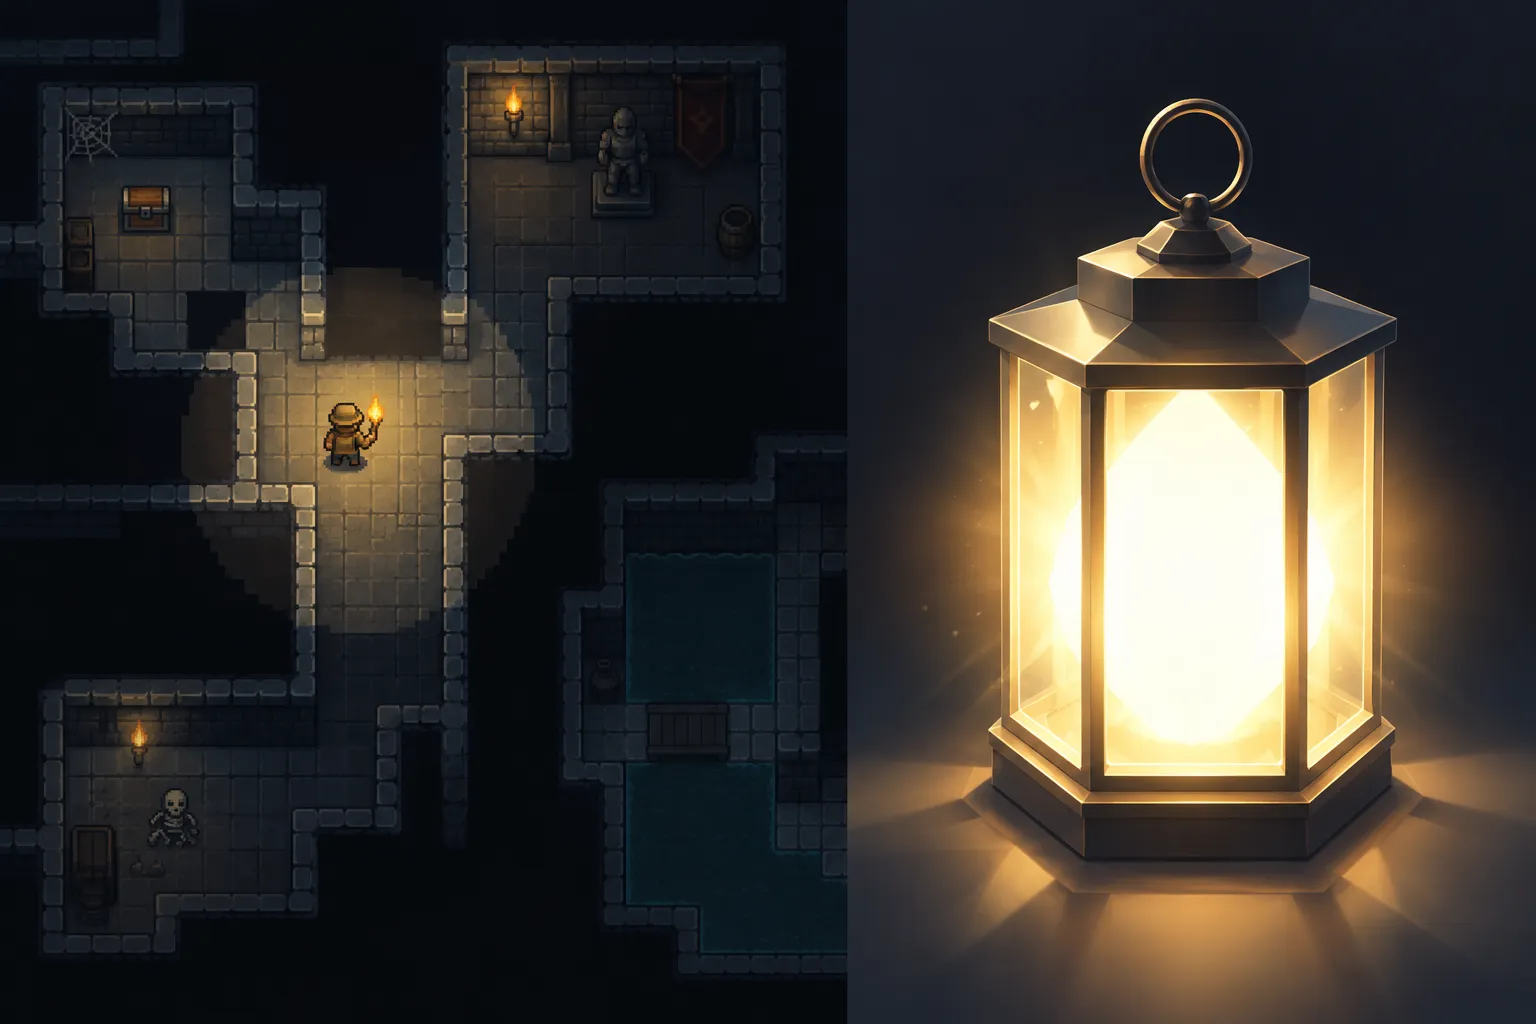
▲ 游戏逻辑与3D资产质量对比
通过MCP执行的智能体任务
MCP任务更清楚地显示了2比特精度的局限。在Blender中,模型制作了一个带六边形框架、尖顶、悬挂环和内部光源的灯笼,并渲染了四个视角。内部光线过亮,顶部挂钩没有绕过固定球,而是插进了球体。模型还反复尝试保存场景并以无界面方式运行Blender而陷入停滞,直到被直接要求提供截图才继续推进。
难度最高的Godot平台游戏要求包含可收集的钥匙、移动的障碍物和终点。第一版两个方向的操作都是反的,覆盖坑洞的物体也没有碰撞。模型还使用了Godot 4中并不存在的碰撞属性,导致会坍塌的平台脚本出错,随后改用碰撞体的disabled标志修复了问题。经过三次修正提示和两次上下文压缩,游戏最终完全可玩。
在16GB显卡上运行大模型前需要了解的要点
从这些结果来看,2比特版本是在单张16GB GPU上运行27B模型的现实选择,而且无需占用系统内存。在长文档检索和日常网页开发中,几乎感觉不到质量下降。若是需要视觉精细度的3D工作,或必须严格遵循特定框架语法的代码,在硬件允许的情况下,Q4或Q5量化明显更好。
如果打算在本地运行这类模型:
- 在16GB显卡上选择Q8_0 embed与head版本而非F16,可节省2GB以上显存。
- 显存紧张时不要使用MTP草稿模型,把这部分空间留给上下文。
- 先确认显卡的显存带宽,因为它在很大程度上决定生成速度。
- 生成的应用出现小错误时,具体描述症状,例如哪个按钮没有反应。
- 如果模型在MCP任务中反复执行同一命令,应中断它并直接要求提供输出文件。
- 对于Godot 4这类不同版本差异较大的工具,要检查代码是否使用了不存在的属性。