Claude Opus 5.5와 GPT-6 Sol·Luna가 두 시간 간격으로 공개됐습니다. 2주 동안 약 $3,000어치 token(모델이 처리하는 텍스트 단위)을 사용한 작업 경험에서는 Claude Opus 5.5의 글쓰기, 애니메이션 제작, 웹 디자인이 특히 돋보였습니다. 그러나 이 사용액은 모델별 지출액이나 동일 조건의 비교 비용을 뜻하지 않습니다. 세 모델의 우열을 판단하려면 발표 수치와 실제 작업 결과를 나눠 봐야 합니다.
benchmark 점수가 말해 주는 범위
Anthropic의 자체 benchmark(표준화된 성능 평가) 비교표에서 Claude Opus 5.5는 GPT-6를 상대로 9개 평가 중 7개에서 앞섰습니다. 함께 소개된 비용 40% 절감과 생성 속도 30% 향상은 이전 모델 대비 수치입니다. 이를 GPT-6 Sol이나 GPT-6 Luna보다 40% 저렴하고 30% 빠르다는 뜻으로 읽어서는 안 됩니다.
이 수치는 Claude Opus 5.5를 살펴볼 이유가 되지만, 어떤 일을 맡겼을 때 수정 없이 쓸 만한 결과가 나오는지까지 보여 주지는 않습니다. 더구나 비교표의 상대는 GPT-6로 표기돼 있습니다. 해당 결과를 Sol과 Luna 각각의 성적표로 바꿔 읽을 근거는 없습니다.
▲ 평가와 작업의 차이
실제 작업에서 두드러진 세 가지
핵심부터 답하는 글쓰기
Claude Opus 5.5는 복잡한 기술 문제에도 긴 도입 없이 진단을 먼저 제시하고, 필요한 설명을 간결하게 이어 가는 모습을 보였습니다. Anthropic의 한 엔지니어에 따르면 이번 모델은 문장 명료성을 높이고 과밀한 정보 나열을 줄이는 데 초점을 맞췄습니다. 중요한 정보를 앞에 놓고 사용자가 정한 작성 조건을 따르도록 개선했다는 설명입니다.
실무에서 확인할 지점은 단순히 문장이 짧은지가 아닙니다. 요청한 답이 먼저 나오고, 형식 조건을 지키며, 사람이 덜 고쳐도 되는지가 중요합니다. 간결한 답변이더라도 필요한 내용이 빠진다면 좋은 결과라고 보기 어렵습니다.
애니메이션을 만드는 코드
Claude Opus 5.5에는 별도 설치 없이 실행할 수 있는 HTML 파일을 요청했습니다. JavaScript의 canvas(웹에서 그림을 그리는 영역)로 장면을 그리고 Web Audio API(브라우저에서 소리를 만들고 처리하는 기능)로 소리를 만드는 조건이었습니다. 결과물은 색색의 공이 여러 풍경을 지나는 애니메이션이었고, 생성된 코드는 약 1,300줄에 달했습니다.
여기에는 결과물의 완성도와 별개로 살펴볼 점이 있습니다. 요청은 하나의 독립적인 파일이었지만, 실제 산출물에는 HTML 파일 외에 보조 렌더링 스크립트가 포함됐습니다. 복잡한 창작 작업을 수행하는 능력과 파일 구성 조건을 정확히 지키는 능력은 따로 확인해야 한다는 뜻입니다.
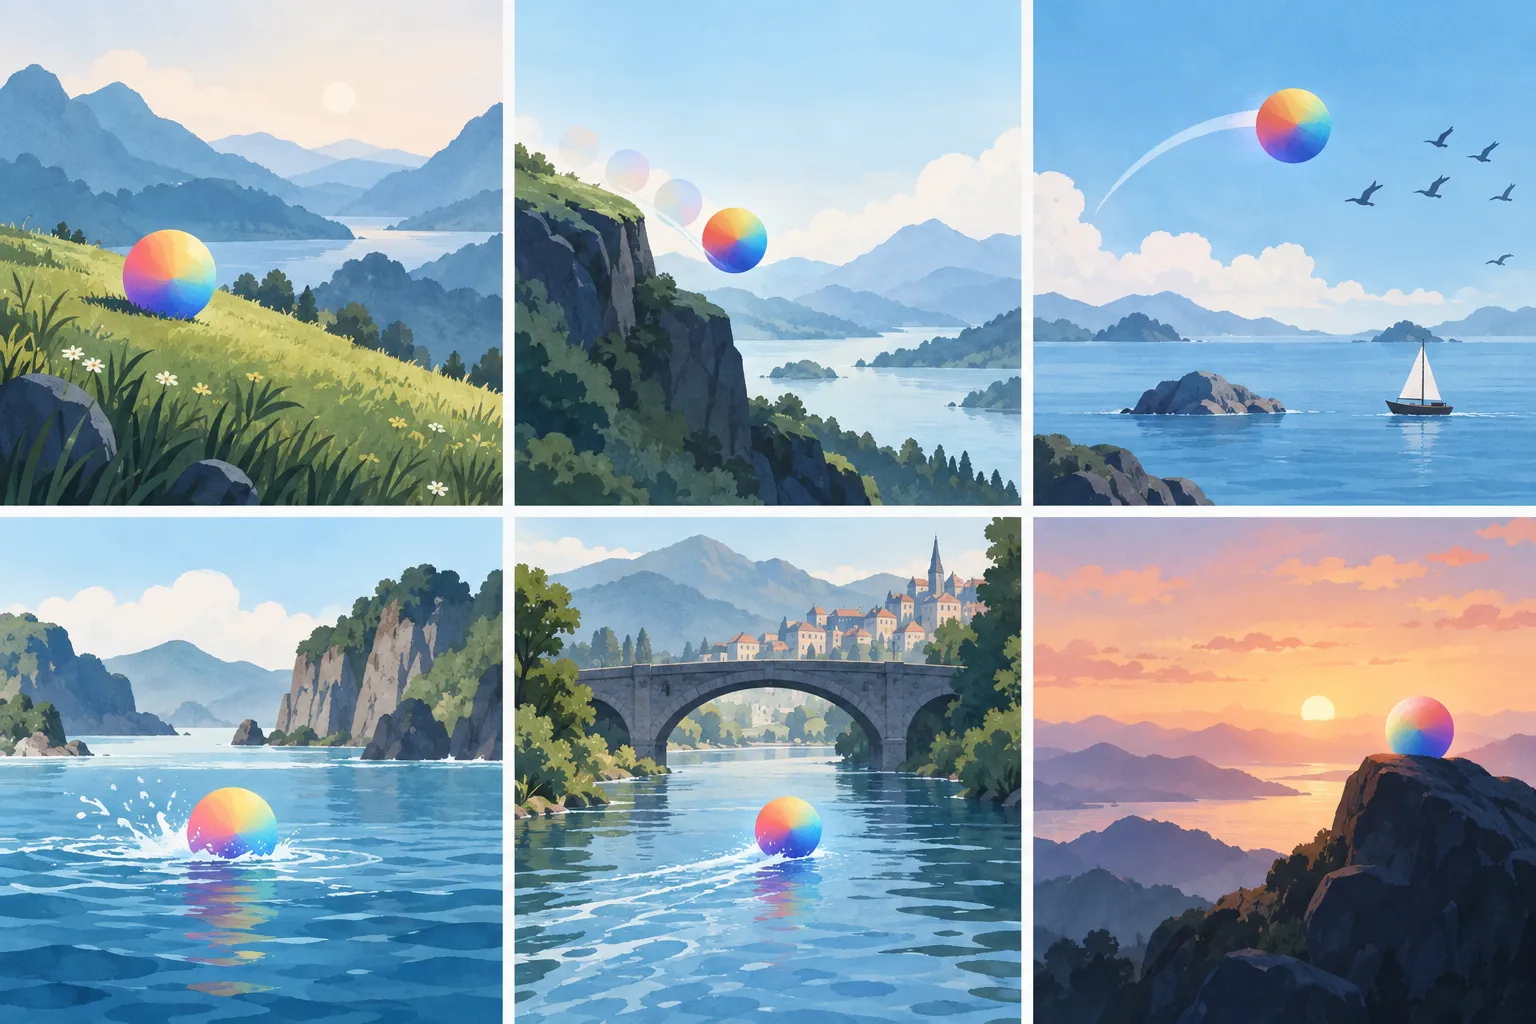
▲ 코드로 만든 애니메이션
바로 살펴볼 수 있는 웹 디자인
Claude Projects에서는 출시 예고 페이지를 새로 구성하는 작업에 Claude Opus 5.5를 사용했습니다. 모델은 단순한 코드 묶음 대신 글꼴 배치, 색상 변화, 움직이는 도형, 모바일 화면 구성을 갖춘 인터랙티브 결과물을 만들었습니다. 비교 수치를 정리한 발표 자료도 같은 환경에서 제작됐습니다.
이 사례의 강점은 코드를 받은 뒤 다른 곳에 옮겨야만 모양을 확인하는 방식과 다르다는 데 있습니다. 작업 중 디자인을 직접 살펴보고 수정 방향을 정할 수 있습니다. 다만 시각적 완성도가 높다는 평가와 실제 서비스에 그대로 적용할 수 있다는 판단은 구분해야 합니다.
GPT-6 Sol·Luna와의 비교에서 남은 빈칸
GPT-6 Sol과 GPT-6 Luna도 이전 모델보다 빠른 처리와 낮은 token 비용을 내세우며 공개됐습니다. 하지만 글쓰기, 애니메이션, 웹 디자인을 세 모델에 동일하게 맡기고 결과를 나란히 평가한 자료는 제시되지 않았습니다. 따라서 Claude Opus 5.5가 이 작업들에서 좋은 결과를 보였다는 판단은 가능해도, 두 GPT-6 모델보다 언제나 낫다는 결론은 어렵습니다.
직전 출시 때는 GPT-6 Astra가 더 좋은 평가를 받았고, 이번에는 Claude Opus 5.5가 더 인상적이라는 평가가 나왔습니다. 이 역시 모델 전체의 고정된 순위라기보다, 당시 살펴본 작업과 사용 경험에 따른 판단으로 읽는 편이 적절합니다.
내 작업에 맞게 확인하는 방법
모델을 고를 때는 발표 점수 하나보다 반복해서 수행할 작업을 기준으로 삼는 편이 유용합니다.
- 글쓰기: 핵심 답변이 앞에 오는지, 지정한 길이와 형식을 지키는지 확인합니다.
- 코드 생성: 실행 결과와 함께 요청한 파일 구성까지 충족했는지 확인합니다.
- 웹 디자인: 미리 보이는 화면뿐 아니라 모바일 구성과 수정하기 쉬운지도 살펴봅니다.
- 비용과 속도: 같은 작업을 같은 조건으로 맡긴 뒤 비교합니다. 이전 모델 대비 개선 수치를 경쟁 모델과의 차이로 사용하지 않습니다.
이번 작업 경험에서 가장 뚜렷한 성과는 Claude Opus 5.5가 문장, 움직이는 장면, 웹 화면을 구체적인 결과물로 만들었다는 점입니다. 독자도 자신이 자주 맡길 작업 한두 가지를 정해 결과의 품질과 수정 시간을 함께 기록하면, benchmark 점수만 볼 때보다 모델 선택의 기준을 분명히 할 수 있습니다.