Git保存的是代码,却保存不了产生这些代码的对话。当AI编程智能体完成一项功能时,提示词、重试、执行过的shell命令、运行过的测试,以及人类说出“这里不对”的那一刻,都会在仓库提交后随之消失。AgentGit正是为捕捉这一缺失层而打造的平台:它完整记录来自Claude Code、OpenAI Codex、Cursor、OpenCode、Hermes和WorkBuddy的智能体会话,让开发者逐轮查看、通过链接分享,并在另一台机器上继续。目前该平台免费使用,没有付费档位。
一个会话究竟包含什么
核心理念是:最终的代码仓库只是一段漫长过程的最后一帧。AgentGit把整个过程存为一连串带编号的轮次。每一轮都保留:
- 人类最初的请求或后续的提示词
- 智能体的推理及其尝试,包括没有成功的尝试
- 每一次工具调用,附带可展开的shell执行输出、字符数和执行耗时
- 以Git风格差异展示的文件补丁
- 测试运行及其结果
会话视图与常规的工作区文件树并排显示,读者既能浏览最终存在的文件,也能一步步回看它们是如何形成的。摘要面板会统计会话中的工具操作次数,下文的一个示例项目就列出了22个工具。
安装命令行工具只需一行命令:npx -y create-agit@latest,它会把本地的智能体会话同步到云端仓库。文档还为每种受支持的助手提供了智能体技能配置,让智能体自己知道如何与AgentGit协作。
案例一:一款浏览网页历史的Chrome扩展
一个名为“growth-usability”的公开会话由一位AgentGit用户创建,记录了智能体构建Manifest V3(MV3)Chrome扩展的过程。该项目在自己的文档中被称为“Web Archaeology”(网页考古),用户输入一个URL、选择年份,即可从Wayback Machine的CDX API拉取快照数据,该API会返回Internet Archive对该页面的存档抓取记录。会话元数据显示这项工作完成于2026年9月23日。
工作区中可以看到文档、扩展本身、测试夹具、落地页素材和执行日志等文件夹,外加一个实验计划文件。扩展文件可以直接从会话中下载,通过chrome://extensions页面以未打包扩展的方式装入Chrome并进行测试。输入亚马逊首页地址并选择2020年,就会返回一列存档快照,并呈现出2020年1月时亚马逊首页的模样。这些结果来自Internet Archive的副本,而非用户自己的浏览历史。
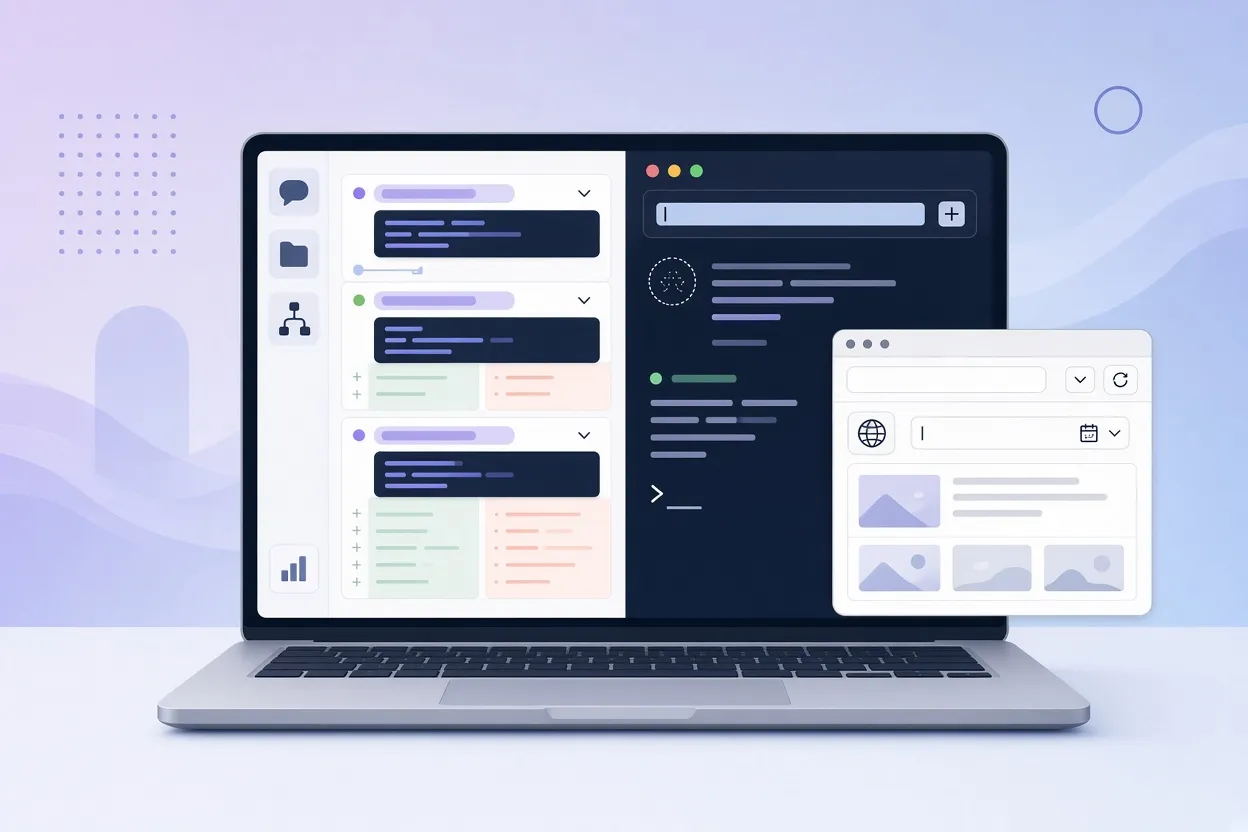
▲ 会话记录、本地续接与扩展弹窗
更有意思的是阅读会话记录本身。第1轮和第2轮展示了智能体执行的shell命令、应用的JSON补丁差异以及所做的验证步骤。有一个细节值得注意:日志中记录的检查是针对本地夹具数据运行的,而不是真实的访客流量。这一区别很重要,因为智能体的测试日志看上去可能很有说服力,实际上却只跑过合成输入。有了完整的执行轨迹,要分辨这两种情况就变得直截了当,这也是支持记录会话的更有力的实际理由之一。
在Codex中接续会话
每个会话都有一个“Continue locally”(本地继续)按钮。点击后会复制一条用于终端的恢复命令。在Windows PowerShell中运行该命令,会话便在OpenAI Codex(0.106.0版)中重新打开,上下文完整保留。接下来,诸如“解释这个扩展”“每个扩展文件各做什么”之类的提示词,都能得到基于已记录工作的回答,无需重新介绍项目。实际上,这意味着队友继承的不只是代码,还有智能体关于“代码为何长成这样”的工作记忆。
案例二:调试一个有漏洞的推理谜题
第二个公开会话“Last elevator”(最后一班电梯)是一款基于浏览器的中文文字推理游戏。设定如下:23:47,13层的电梯门关上,电梯内发现一把带有红色污渍的雨伞。玩家有三次询问机会,可以向前台、住客和维修工三名嫌疑人提问,然后指认是谁留下了雨伞。最初的提示词要求做出一个完整可玩的HTML谜题,包含线索、有限的提问次数、胜负条件和重开机制。
第1轮中,智能体生成了index.html的第一个版本。随后的审阅反馈指出了一个逻辑缺陷:仅凭所给线索,根本推不出真凶。在典型的聊天式工作流中,要找出推理链究竟在哪一点断裂,得在冗长的日志里来回翻找、手动比对文件,过程相当痛苦。而在AgentGit中,被标记的那一轮作为一个独立步骤清晰可见,紧随其后的就是智能体修订线索和证词的那一轮。
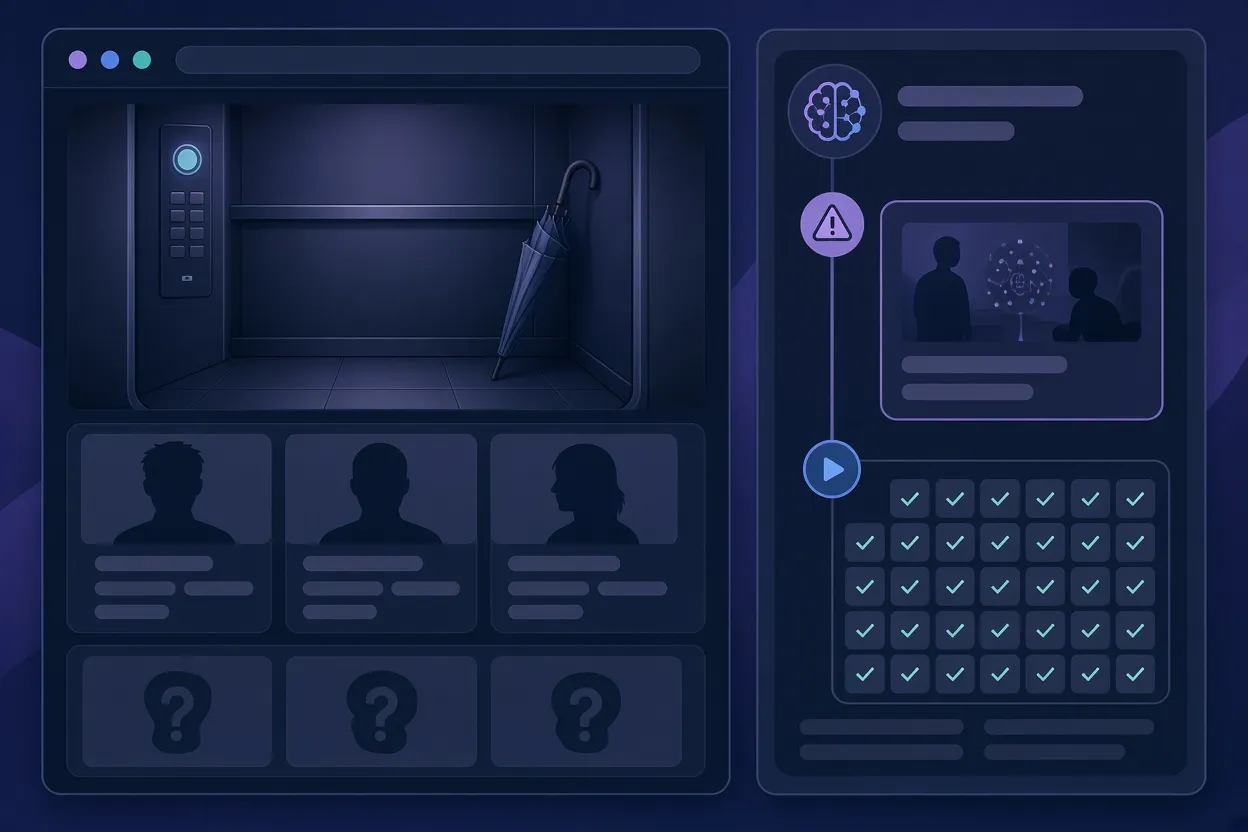
▲ 被标记的推理轮次与回放测试结果
修复并未止步于改写线索。智能体还添加了一套测试:
| 测试文件 | 检查内容 |
|---|---|
| reset-test.cjs | 重开后状态是否正确重置 |
| replay-test.cjs | 全部75种提问组合是否都得到正确结局,并正确处理错误指认 |
| 伪浏览器冒烟测试 | 不依赖真实浏览器,页面DOM是否按预期运作 |
会话记录展示了第1轮、第2轮和第3轮中的Node.js测试运行,任何审阅该项目的人都能确认逻辑修复是经过验证的,而不只是口头声称。对于用AI构建的逻辑密集型项目来说,这类自动化回放测试看来是一道合理的防线,可以防止谜题或流程在不知不觉中变得无解。
分享与交接
AgentGit的协作功能以链接为中心。分享会话时有两个选项:“Let someone continue”(允许他人继续),接收者可以接着智能体工作流继续做;“Share for viewing”(仅供查看),这是只读模式,适合只需要审核提示词和执行历史的队友。平台还提供远程控制功能:智能体在一台机器上运行,由另一台电脑或移动设备来指挥。
与常见的交接产物相比,无论是聊天截图、导出的Markdown记录,还是一个光秃秃的仓库,交互式会话似乎都承载了多得多的可用上下文。审阅者在同一处就能看到提示词、尝试、差异和测试,并可以直接从那里继续,而不必重新还原。
为什么重要,以及该怎么做
转向由智能体编写代码,带来了一种新型技术债:无人能追溯的决策。AgentGit的答案是把会话本身当作版本控制的单位。对于已经在用Claude Code或Codex的开发者来说,实际要做的事并不多:
- 用
npx -y create-agit@latest安装CLI,并为你的智能体添加技能配置。 - 浏览growth-usability和Last elevator等公开会话,逐轮了解真实的智能体开发模式是什么样子。
- 当某个会话很重要时,用链接而不是截图来分享,审核用仅查看模式,交接用允许继续模式。
- 用“Continue locally”在你自己的Codex环境中恢复工作,而不是从头重新输入提示词。
- 接手任何会话时,先阅读其中的测试日志,确认测试是在夹具数据还是真实数据上运行,再决定是否信任结果。
需要提醒一点:平台目前免费且没有付费档位,但随着发展这一点可能改变。就眼下而言,尝试它的成本只是一条命令,而回报则是一份关于你的AI构建软件究竟如何诞生的记录。


