DeepSeek V4.1 Flash的API价格大约只有竞争对手的十分之一,公开基准测试成绩也接近Claude Opus 5和GPT-5.6 Sol。但把这款模型放到真实的建筑工程任务中检验,它与当前前沿模型之间的差距却相当大。在一套包含169道已核验答案的招标图纸问题上,它的得分为62.7%,而Claude Sonnet 5.5为93.3%。在一项给排水工程量计算任务中,它的准确率为20.7%,Claude Opus 5.5为42.7%。在一次成本报告练习中,它对一个实际将亏损$25万的项目预测出$103万的利润。这些结果表明,至少在目前,省下的token费用并不足以抵消采信其输出所带来的风险。
为何用真实任务而非榜单分数
DeepSeek是来自中国的开放权重模型家族,其权重可从Hugging Face等平台下载并在私有硬件上运行。V4.1 Flash的发布说明宣称,在Terminal-Bench 3.0、DeepSeek-SWE 1.1、CyberGym和Automation-Bench等标准测试中,其表现可与Claude Opus 5和GPT-5.6 Sol匹敌。这些信号有参考价值,却无法告诉承包商:模型能否数清给排水图纸上的地漏,或者识破招标文件里暗藏的条款陷阱。
因此,这里介绍的评测改用了一套专门面向建筑行业的基准。它分为三部分:一是客观的图纸测试,由9套真实招标图纸和169道有核验答案的问题构成;二是工程量计算测试,基于一套11张图纸的Whole Foods给排水图,包含82项计分工程量;三是主观的施工管理测试,覆盖六个项目工作流,按评分标准打分。同一基准数据库中保存着38个原始模型和22个harness的成绩,因此DeepSeek的数字可以与Claude Sonnet 5.5、Claude Opus 5.5、GPT-6 Astra和GPT-6.1 Sol并列比较。
测试配置:模型、harness与价格
DeepSeek的测试是在DeepSeek Harness中进行的,这是其免费的桌面应用。所谓harness,是把模型包装成智能体的软件环境:它负责管理对话会话、文件访问、工具和自动化,作用类似于Claude Code或ChatGPT Codex。DeepSeek Harness可从DeepSeek官网免费下载,支持Windows等多种操作系统。它还不绑定特定模型:在设置的Models选项卡中,既可以登记DeepSeek的API密钥,也可以登记Anthropic、OpenAI的密钥,或OpenRouter这类路由网关的密钥,并在它们之间切换。
有几项设置细节对建筑测试影响较大:
- 模型选择。 之所以选DeepSeek V4.1 Flash而非DeepSeek V4-Pro,是因为V4-Pro缺乏原生视觉理解能力,无法读取平面图。Claude或ChatGPT的核心模型具备相近的多模态功能,DeepSeek的各个版本却能力各异,因此在处理技术文档之前,应先确认所用模型具体支持哪些能力。
- 工作区。 每个工作区对应一个通过标准文件对话框选定的本地文件夹,会话和产出物都归在侧边栏的该工作区之下。测试从一个桌面文件夹发起,与Claude和ChatGPT所用的桌面协作配置保持一致。
- 权限。 提示栏菜单提供只读(Read Only)、工作区写入(Workspace Write)和完全访问(Full)三档。测试采用工作区写入,让智能体可以编辑项目文件,又不触及更大范围的系统。
- 插件。 内置插件控制网页搜索、shell执行限制、智能体循环调度,以及一项Subagent功能,允许主对话派生子智能体,并用滑块设置递归深度和并行上限。把这些上限收紧,有助于避免token消耗失控。
在本地运行开放权重的方案因不切实际而被排除。在普通笔记本电脑上,推理速度太慢,无法满足日常工作,除非投入数万美元购置专用加速硬件。
按量付费与固定订阅
最大的吸引力在于价格。DeepSeek V4.1 Flash标准时段的标价为:缓存未命中时每百万输入token $0.30,每百万输出token $1.20,约为竞品标价的十分之一。缓存命中时输入价格进一步下降,非高峰时段为每百万token $0.003,高峰时段为$0.015;非高峰时段的输出价格也降至每百万token $0.60。
不过,它没有面向消费者的固定订阅,每一次调用都按量计费。相比之下,每月$200的Claude或ChatGPT套餐提供的是有补贴的token额度,若全部用满,按原始API算力估算可能价值$1万。因此对重度用户来说,固定套餐也许更划算;而按量计费所需的$10额度反复充值本身也会带来摩擦,让运行成本始终悬在眼前。即便如此,开放权重的竞争仍然重要:它迫使闭源厂商压住前沿模型的定价。
读图:文字信息强,测量几乎失灵
图纸测试涵盖建筑、结构、电气、暖通、给排水和土建图纸。DeepSeek的总体成绩及按任务类型的拆分如下,并与前沿模型并列。
| 模型 | 图纸测试总分 |
|---|---|
| Claude Sonnet 5.5 | 93.3% |
| Claude Opus 5.5 | 92.5% |
| GPT-6 Astra | 86.6% |
| GPT-6.1 Sol | 85.8% |
| DeepSeek V4.1 Flash | 62.7% |
| 任务类型 | DeepSeek V4.1 Flash | 前沿模型最佳成绩 |
|---|---|---|
| 读取图纸上的文字信息 | 82.8% | 96.5%(Claude Sonnet 5.5与Opus 5.5) |
| 清点构件数量 | 55.9% | 91.2%(Claude Sonnet 5.5) |
| 从图纸上量取尺寸 | 9.1% | 81.8%(Claude Sonnet 5.5与GPT-6系列) |
规律很清楚。当答案以文字形式印在图纸上时,DeepSeek表现尚可;当需要清点图例符号时,它开始失分;当需要按比例从图纸上量取实际尺寸时,它几乎总是失败。两个具体的失误可以说明这种行为。在编号402的电气图纸上,问DB-GB配电板属于essential(重要)供电还是non-essential(非重要)供电,DeepSeek回答所提供的资料没有说明,而核验答案是非重要供电。在一份办公楼平面图的201号图纸上,它拒绝清点一层的小功率插座数量,而核验数字是6个。
测试过程中还遇到了稳定性问题。DeepSeek多次在执行提示词中途停住,不得不手动重启,而Claude或ChatGPT在同类负载下很少出现这种情况。
▲ 地漏数量清点正确但系统归属颠倒
给排水工程量计算:总数对了,系统错了
工程量计算(quantity takeoff)是指对图纸上的每一项构件进行清点和测量,以便计价。在这套11张图纸、82项计分工程量的给排水图上,结果如下:
| 模型 | 工程量计算准确率 |
|---|---|
| Claude Opus 5.5 | 42.7% |
| GPT-6 Astra | 37.8% |
| GPT-6.1 Sol | 35.4% |
| Claude Sonnet 5.5 | 34.2% |
| DeepSeek V4.1 Flash | 20.7% |
这里没有任何模型接近可投入生产的水平,即便最高分也不到一半。但DeepSeek的出错方式很有启发意义。在P100图纸上,任务是清点HD-1型地漏(hub drain),并将其归入污水系统或含油废水系统。核验答案是污水系统64个、含油废水系统2个。DeepSeek给出的却是污水系统6个、含油废水系统55个。总数大致不差,分配却几乎完全颠倒。在计价的估算书中,这类错误不会表现为明显的缺项,而是表现为给错误的系统计算了错误的管道、管件和连接。从这些证据看,DeepSeek目前不适合用于自动化工程量计算流程。
六项施工管理任务
主观基准要求模型完成六个真实的工作流,每项满分100分:编制投标估算、在中标时建立基准施工进度计划、进度与赶工规划、采购管理、合同管理,以及编制成本报告。招标文件中埋设了陷阱,例如一条禁止在工地附近停车的条款,用以检验估算人员是否会为工人增加交通费用。
| 任务 | DeepSeek V4.1 Flash | 竞品最佳成绩 |
|---|---|---|
| 投标估算 | 32.2 | 67.8(Claude Opus 5.5) |
| 中标时的进度计划 | 30.3 | 67.2(Claude Sonnet 5.5) |
| 进度与赶工 | 25.6 | 66.6(GPT-6.1 Sol) |
| 采购管理 | 36.8 | 58.4(Claude Opus 5.5) |
| 合同管理 | 27.6 | 78.8(Claude Opus 5.5) |
| 成本报告 | 24.0 | 71.8(Claude Opus 5.5) |
DeepSeek在每个类别中都垫底。数据库中六项任务的最佳平均分为65.9%,由Claude Opus 5.5保持。有两个输出尤其值得一提。被要求编制施工进度计划时,DeepSeek生成了29项任务,却没有一条依赖关系链接,只是在电子表格里列了一栏彼此无关的日期,尽管钢结构吊装、屋面板铺设和钢纤维混凝土(SFRC)楼板浇筑等活动必须依次进行。而在成本报告中,它对一个真实评估显示将亏损$25万的项目,预测出$103万的利润和6.6%的利润率。
最后这个结果正好点明了成本之争的要害。如果一次运行花$10而不是$30、省下$20的token费用,但产出的报告却把项目引向错误的财务方向,那这点节省毫无意义。
Creator模式与未能成形的工程量插件
DeepSeek Harness除标准模式外还有第二种模式,叫Creator模式,可在工作区顶栏切换。它会暴露harness的配置,并允许用户通过普通对话指示智能体编写并安装自定义UI插件。其意图与最近推出的Claude Mods相近,后者允许用户改造Claude的工作区并添加扩展;DeepSeek把对应的组件称为插件。
为了公平地测试它,这里尝试构建一个建筑工程量计算插件:一个交互式界面,用户可以看到叠加在图纸上的工程量条目标记并进行调整。经过两个小时的提示和迭代,得到的只是一张基础的表格清单,包含条目描述、单位、数量、单价和金额,外加CSV导入、手动填写的损耗百分比字段和一个“运行计算”按钮。它完全没有图纸可视化叠加层,没有达到设计要求。这次尝试最终放弃。Creator模式看起来对新手并不友好,通过文字提示构建复杂的可视化工具也令人沮丧。
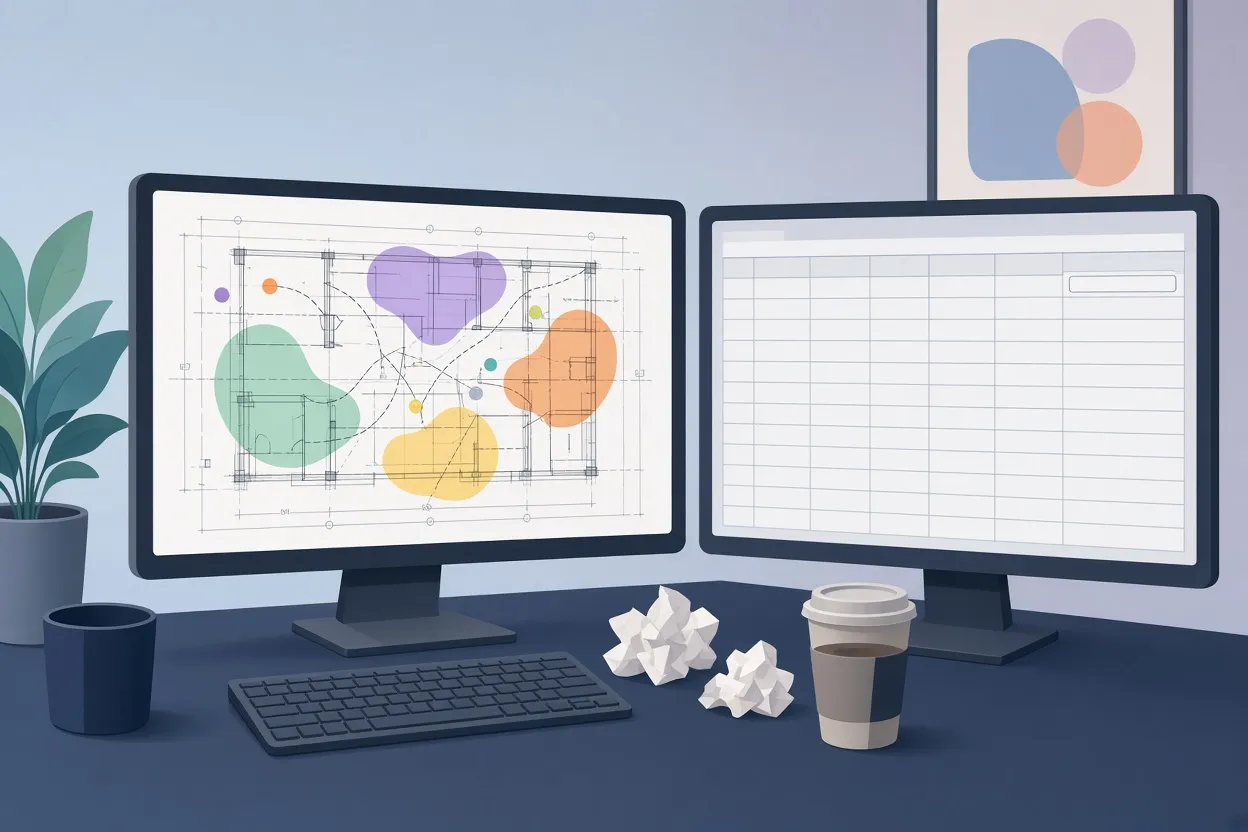
▲ 预期的可视化算量工具与实际生成的表格
对“harness工程”的怀疑态度
这次实验也印证了一个更宏观的判断,即如何看待当下对“harness工程”的热情。这种观点认为,终端用户应当重新设计自己所用的智能体环境。子智能体递归深度、并行子智能体上限、智能体循环调度和shell限制等可配置旋钮固然有趣,但这里的看法是,从业者用常规配置反而能获得更好的结果:定义清晰的技能、标准插件、结构分明的项目文件夹,以及经过核验的测试数据集。平台架构或许最好留给Anthropic和OpenAI这样的前沿实验室,建筑行业的专业人士则应把时间花在工作流、测试和数据质量上。
有一点需要充分考虑。DeepSeek Harness是免费的新产品,拿它与成熟的付费产品正面比较多少有些苛刻。它的价格优势是真实的,而开放权重的竞争通过抑制前沿定价让所有人受益。
建筑行业专业人士应从中记住什么
- 用自己的任务来评判模型。 公开基准上的平起平坐并没有转化为建筑领域的实际能力。从自己的图纸中选出一小组有核验答案的问题,比排行榜更适合用来选型。
- 区别对待文字提取与空间任务。 DeepSeek在读取印刷信息上有82.8%的准确率,尚可使用,但在测量上只有9.1%。如果工作流依赖量取尺寸或清点数量,低价方案目前站不住脚。
- 不只核对总数,还要核对系统归属。 地漏的例子表明,合计数可能大致正确,而按系统分配却几乎全错。计价之前,把工程量的每一行与图纸逐一核对。
- 打开每一份生成的进度计划,检查逻辑链接。 只有日期、没有前置和后续任务的进度计划不能算进度计划。
- 把token成本与决策风险放在一起权衡。 如果生成的成本报告把亏损倒成了盈利,更便宜的一次运行就不是节省。
- 把时间花在工作流上,而不是重建harness。 选择具备所需能力的模型版本,设置工作区写入权限,限制子智能体的深度和并发数,并把项目文件夹整理清楚。除非有明确且经过验证的理由,否则把插件和界面的构建留给平台开发者。
DeepSeek V4.1 Flash价格低廉、权重开放,还配有一个灵活的免费harness。但在建筑图纸解读、工程量计算和管理报告方面,Anthropic和OpenAI当前的前沿模型仍然准确得多;而且包括领先者在内,没有任何模型在工程量计算上赢得了可以无人监督的信任。


